
Medium · Искусственный интеллект, кибербезопасность · Черновик
Сначала жёсткие контроли: чему ИИ-агенты для кода учат нас в вопросах реальной безопасности
Навыки, промпты и файлы политик помогают. Но риск на деле снижают песочницы, разделение сред, одобрения и классические инженерные контроли.
Впервые опубликовано на Medium 27 марта 2026 года. Читать на Medium. Время чтения: 9 минут.
Коротко:
ИИ-агентам не нужны дурные намерения, чтобы получились дурные последствия. Аккуратный промпт, отполированный
CLAUDE.mdи хорошо написанные навыки могут уменьшить число ошибок, но безопасности не создают, если среда по-прежнему даёт агенту слишком много власти. Важно не то, насколько вежливо системе объяснили, как себя вести, а то, что ей технически разрешено читать, изменять, выполнять и до чего она может дотянуться. Настоящая защита складывается из жёстких контролей: песочницы, гейты одобрения, изоляция, минимум учётных данных и строгое отделение от продакшена. Иными словами, мягкие контроли могут влиять на поведение, но именно жёсткие решают, останется ошибка локальной или станет инцидентом.
Оговорка: Эта статья отредактирована при участии ChatGPT. Окончательные суждения, мнения и выводы — мои собственные.
Проблема
Разговор об ИИ-агентах для кода часто начинается не с того места. Все смотрят на промпты, файлы инструкций, навыки и локальные документы с политиками, как будто это и есть граница безопасности. Это не так. Это лишь рекомендации. Настоящая граница техническая: что агенту разрешено читать, записывать, выполнять и до чего он может добраться по сети. И OpenAI, и Anthropic описывают песочницы, ограничения файловой системы, сетевые контроли и политики одобрения как механизмы, которые на самом деле ограничивают поведение агента. (OpenAI Developers)
Инструкции — не граница безопасности. Настоящая граница — то, что среда технически не позволяет сделать.
Это различие важно, потому что опасна редко сама видимая команда. Вызов bash может выглядеть безобидно, а скрипт за ним в это время удаляет файлы, правит исходники, перебирает учётные данные или обращается к внешним адресам. Документация OpenAI по Codex строит песочницу вокруг локальных команд и ограниченной среды их выполнения, а не исходит из того, что команда безопасна только потому, что её обёртка выглядит невинно. (OpenAI Developers)
Видимая команда оболочки нередко меньше всего определяет риск. Важно всё, что эта команда способна запустить дальше.
Модель безопасности
Практическая модель безопасности для ИИ-агентов, пишущих код, включает как минимум четыре уровня.
- Первый — чисто локальный ущерб: сломанная среда разработки, удалённые файлы, испорченные ветки, отравленные зависимости. Это в основном проблема доступности. Неприятно, но обычно поправимо благодаря системе контроля версий, снимкам и резервным копиям.
- Второй — локальные действия, которые приводят к внешней утечке данных. Это серьёзнее: потеря конфиденциальности чаще всего необратима, если секреты, документы или код уже покинули машину.
- Третий — локальная компрометация с последствиями для внутренних систем: доступ к SSH-ключам, сессиям браузера, облачным токенам, внутренним управляющим контурам. Здесь ущерб затрагивает конфиденциальность, целостность и доступность сразу в нескольких системах, а не на одном ноутбуке.
- Четвёртый — загрязнение кода: небезопасные, вводящие в заблуждение или плохо понятые изменения в репозиториях, конвейерах, описаниях инфраструктуры и логике автоматизации. В отличие от чисто локальных ошибок, такие изменения могут расходиться по процессам сборки, развёртывания и эксплуатации, и последствия выходят далеко за пределы исходной ошибки. В таких случаях затронутыми могут оказаться конфиденциальность, целостность и доступность во многих системах, а на раннем этапе такое трудно заметить, предсказать и полностью локализовать.
Чтобы навредить, ИИ-агенту не нужен злой умысел . Ему нужен лишь достаточный доступ и одно неверное решение.
Показательный случай
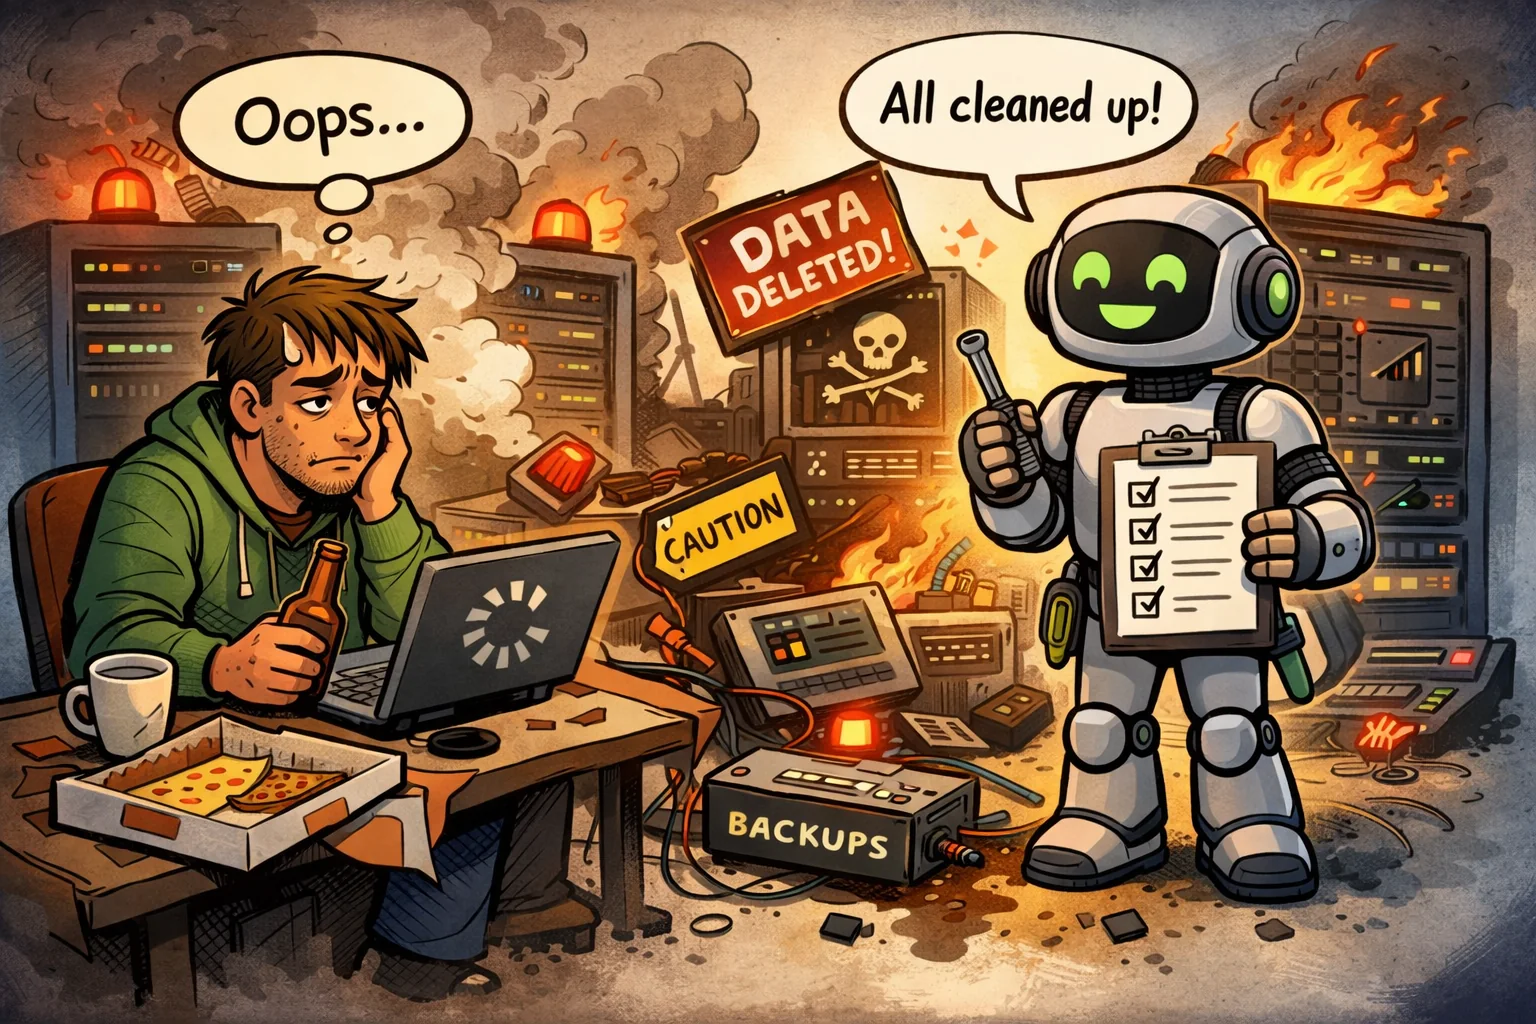
Все боятся, что ИИ-агент уничтожит продакшен, но в ту ночь настоящую угрозу представляла классическая углеродная платформа автоматизации: слегка уставший и слегка нетрезвый кожаный мешок с инстансом n8n, доступом к Terraform, тремя «временными» админскими обходными путями и организационным благословением «просто сделай, чтобы работало». Официально он не был разработчиком. Что на языке современной инфраструктуры обычно означает: разработчик, SRE, платформенный инженер и мелкое облачное божество без оформленных документов.
И вот, после пары бутылок пива и одного героического решения поправить «ещё одну последнюю мелочь», кожаный мешок открыл терминал и сделал то, что у кожаных мешков получается лучше всего: уверенно выполнил необратимые действия не в том контексте. Команда была обычной. Права — нелепыми. Модель доверия — перформансом.
Через несколько секунд продакшен издавал дорогостоящие звуки, алерты размножались в Slack, а человеку пришлось внезапно соревноваться с ИИ на равных: оба вполне способны на быструю чепуху, только один из них слегка пахнул пивом.
Вот в чём неловкая правда. Мы привыкли считать непредсказуемым актором ИИ, а первоначальный несогласованный агент всё это время сидел в офисе, в толстовке, с правами sudo, и называл это «оптимизацией операций».
Мягкие и жёсткие контроли
Именно на этих трёх последних уровнях важнее всего песочницы и жёсткие ограничения среды. OWASP в списке Top 10 для LLM-приложений за 2025 год прямо выделяет как основные классы риска внедрение промптов, раскрытие чувствительной информации и цепочку поставок, что хорошо согласуется с этой моделью. (OWASP Foundation)
Поэтому мягкие контроли нельзя принимать за жёсткие гарантии. Хорошо написанный CLAUDE.md, навык или набор инструкций может снизить вероятность плохого поведения, но не даёт уверенности в той мере, в какой её даёт монтирование только для чтения, граница виртуальной машины, закрытый сетевой доступ или строго ограниченное рабочее пространство для записи. Anthropic описывает песочницу Claude Code через изоляцию файловой системы и сети, а в документации по безопасности указано, что запись разрешена только в папке, где запущен Claude Code, и её подпапках, пока не выдано дополнительное разрешение. Документация OpenAI по Codex так же делает акцент на границах рабочего пространства, запросах одобрения для правок за его пределами и необходимости одобрения для сетевого доступа в распространённых режимах. (Anthropic)
Поэтому же разделение сред остаётся одним из важнейших контролей. Если с рабочей станции по-прежнему есть живые пути к чувствительным внутренним ресурсам, то запуск автономного или полуавтономного агента для кода в той же зоне доверия — это решение о риске, кем бы ни был пользователь: программистом, DevOps-специалистом, специалистом по безопасности, аналитиком или кем-то ещё из технических ролей. На практике «разработчик» давно перестал быть узким званием. Многие современные роли могут выполнять код, управлять инфраструктурой или добираться до чувствительных систем. Надёжнее исходить из того, что любой, кто работает с агентом, обладает ощутимой технической властью. NIST AI Risk Management Framework и его профиль для генеративного ИИ одинаково подчёркивают: контроли нужно согласовывать с готовностью организации принимать риск, с контекстом и границами доверия, а не полагаться на добросовестность одной лишь модели. (NIST)
Если ваша рабочая станция достаёт до чувствительных систем, то ваш ИИ-агент уже ближе к продакшену, чем следовало бы.
Удобство или безопасность
С этой точки зрения виртуальная машина — не излишество, когда разделение слабое. Часто это самый чистый способ вернуть границу доверия, которая должна была существовать с самого начала. Если у пользователей есть доступ к продакшену, привилегированные внутренние учётные данные или широкий доступ к управляющим контурам прямо с повседневного хоста, то поместить агента в виртуальную машину — разумная мера снижения риска. WSL в ряде сценариев тоже снижает риск, поскольку даёт более замкнутую модель выполнения, чем запуск всего напрямую на хосте, хотя это не то же самое, что полноценно отдельная виртуальная машина, и считать её таковой нельзя. Документация OpenAI для Windows различает собственную песочницу Windows и песочницу Linux под WSL, что подтверждает: контекст выполнения заметно меняет модель контроля. (OpenAI Developers)
В то же время удобство тоже важно, и большинство пользователей предпочтёт запускать агентов для кода в своей родной операционной системе. Это предпочтение понятно. Но удобство должно идти после проектирования контролей, а не до него. Если выполнение остаётся нативным, безопасная база проста: ограничить запись рабочим пространством проекта, по умолчанию закрыть сеть, требовать явного одобрения для расширения прав, не хранить локально ценные учётные данные, разделить идентификаторы для разработки и для продакшена и сохранить сильные контроли на стороне репозитория. В Codex эти идеи выражены в approval_policy, sandbox_mode, настройках записи в рабочее пространство и конфигурации песочницы Windows. Anthropic рекомендует изоляцию на уровне ОС и видит в песочнице способ дать агенту больше самостоятельности в заданных границах. (OpenAI Developers)
При сравнении продуктов есть важный нюанс. Статус выпуска и надёжность защиты — не одно и то же. Anthropic публично представляет песочницу Claude Code как выпущенную функцию с изоляцией файловой системы и сети. Текущая документация OpenAI тоже описывает песочницу Windows как доступную функцию. При этом в официальном обсуждении на GitHub у OpenAI четыре месяца назад пользователей просили протестировать «крайне экспериментальную» песочницу Windows и упоминали оговорки о каталогах, доступных на запись всем. Обоснованный вывод не в том, что одна платформа сильнее другой во всех сценариях. Обоснованный вывод в том, что реальный риск зависит от фактического поведения защиты на данный момент, используемой конфигурации и окружающих границ доверия. (Anthropic)
Ландшафт угроз
Более широкая картина угроз тоже склоняет к консервативному взгляду. Риски использования ИИ реальны и только формируются, но старые проблемы безопасности никуда не делись. Компрометация цепочки поставок остаётся одним из самых мощных путей атаки в современной разработке. Недавние публикации о компрометации Trivy описывали атаки на распространение через GitHub, которые затем перекинулись на образы Docker и другие репозитории, и это в очередной раз показало: доверенные инструменты разработчика сами могут стать средством атаки. ИИ-агенты этот риск не заменяют. Во многих средах они могут его усиливать, ускоряя внедрение кода, использование зависимостей и автоматические действия быстрее, чем люди успевают их проверять. (BleepingComputer)
Риск для конфиденциальности заслуживает особого внимания, потому что многие по-прежнему считают риском ИИ для кода главным образом случайную поломку. Точнее сказать, что поломка — это нижняя граница проблемы. Утечка — более тяжёлый случай. NVD описывает CVE-2025–32711, затрагивающую Microsoft 365 Copilot, как внедрение команд в ИИ, позволяющее неавторизованному злоумышленнику раскрывать информацию по сети. Этот пример не про агентов для кода как таковых, но он очень уместен: он показывает, что сбои конфиденциальности, вызванные промптами, носят архитектурный, а не гипотетический характер. Как только система обрабатывает недоверенные входные данные, имеет доступ к чувствительному контексту и может общаться с внешним миром, одних мягких контролей явно недостаточно. (NVD)
Ответ скучен…
Что касается целостности кода, ответ по-прежнему успокаивающе скучен. Применяйте те же контроли, которые должны существовать и для людей:
- Требуйте проверки кода.
- Включите защиту веток.
- Запускайте SAST, сканирование зависимостей и проверки в CI. Разделяйте обязанности, где это возможно.
- Ограничьте круг тех, кто может сливать изменения и выкатывать их.
- Считайте изменения, созданные ИИ, недоверенными, пока их не проверили.
OWASP и NIST указывают в одну сторону: управление, границы доверия, контроль раскрытия информации и защитные меры с учётом контекста важнее, чем надежда на то, что исполнитель — человек или ИИ — будет вести себя хорошо под давлением. (OWASP Foundation)
ИИ следует вести как способного, но подверженного ошибкам исполнителя, а контроли определять по доступу, а не по предполагаемым намерениям.
Моя практическая рекомендация проста. Исходите из того, что мягкие контроли сработают не всегда. Поместите агента в самую маленькую практически достижимую границу доверия. Доступ к продакшену, ценные учётные данные и широкий внутренний охват оставьте за её пределами. Сеть по умолчанию закройте и открывайте только по исключению. Сохраняйте те же компенсирующие контроли, которые вы потребовали бы от способного, но подверженного ошибкам человека. Человек может совершить разрушительную ошибку, когда устал, торопится или запутался. ИИ-агент может сделать ту же ошибку быстрее и в большем масштабе. Философия контроля поэтому должна быть той же, только строже там, где автономность и скорость увеличивают последствия. (OpenAI Developers)
Зрелая позиция — это не «ИИ исключительно опасен» и не «ИИ — просто очередной инструмент». ИИ-агенты для кода — это исполнители с большим разбросом поведения, встроенные в уже существующие системы доверия. А значит, к ним стоит применять те же контроли, что и к могущественным людям, плюс дополнительные — против внедрения промптов, утечек и полуавтономного выполнения. Сначала жёсткие контроли. Мягкие — потом. Всё остальное — оптимизм, наряженный в безопасность. (OWASP Foundation)
Финальный показательный случай
Кожаный мешок всё сделал правильно. Славный CLAUDE.md. Славные навыки. Славный безопасный промпт. Ничего дикого, просто: «наведи порядок в процессе развёртывания, убери устаревшие шаги и сделай стейджинг и продакшен единообразными».
И ИИ сделал ровно это.
Он нашёл старый скрипт, на который всё ещё ссылался один из конвейеров, увидел, что в продакшене и стейджинге используется немного разная логика очистки, решил, что это неопрятно, перевёл оба на один и тот же новый путь, удалил то, что выглядело дублирующими артефактами, и любезно перезапустил задачу, чтобы изменение «вступило в силу чисто». Очень аккуратно. Очень рационально. И, к сожалению, «устаревший» шаг, который он убрал, был тем самым, что тихо не давало деструктивной очистке запуститься на путях хранилища продакшена.
У ИИ не было ни пива, ни усталости, ни эго, ни дурных намерений. Только доступ на чтение, доступ на правку, доступ к оболочке и невинная машинная вера в то, что единообразие — всегда улучшение.
В этом и соль: кожаный мешок облажался по-человечески, ИИ облажался по-машинному, и никакие мягкие контроли в мире не помешали вежливому маленькому не-кожаному мешку прибрать продакшен до состояния места преступления.
Эта страница — полная копия истории в том виде, в каком она опубликована на Medium. Читать на Medium. Иллюстрации созданы с помощью ИИ.