
Medium · Künstliche Intelligenz, Cybersicherheit · Entwurf
Harte Kontrollen zuerst: Was KI-Coding-Agenten über echte Sicherheit lehren
Skills, Prompts und Richtliniendateien helfen. Sandboxing, Trennung, Freigaben und klassische Engineering-Kontrollen sind es, die das Risiko tatsächlich senken.
Zuerst auf Medium veröffentlicht am 27. März 2026. Auf Medium lesen. 9 Min. Lesezeit.
TL;DR:
KI-Agenten brauchen keine böse Absicht, um schlechte Ergebnisse zu erzeugen. Ein sorgfältiger Prompt, eine polierte
CLAUDE.mdund gut geschriebene Skills können Fehler verringern, aber sie schaffen keine Sicherheit, solange die Umgebung dem Agenten zu viel Macht lässt. Entscheidend ist nicht, wie höflich das System angewiesen wird, sondern was es technisch lesen, ändern, ausführen und erreichen darf. Echten Schutz bieten harte Kontrollen wie Sandboxing, Freigabe-Gates, Isolation, minimale Zugangsdaten und eine saubere Trennung von der Produktion. Anders gesagt: Weiche Kontrollen können das Verhalten prägen, aber harte Kontrollen entscheiden, ob ein Fehler lokal bleibt oder zum Vorfall wird.
Hinweis: Dieser Artikel wurde mit Unterstützung von ChatGPT überarbeitet. Die abschließenden Urteile, Meinungen und Schlussfolgerungen sind meine eigenen.
Das Problem
Die Diskussion über KI-Coding-Agenten beginnt oft an der falschen Stelle. Man konzentriert sich auf Prompts, Anweisungsdateien, Skills und lokale Richtliniendokumente, als wären sie die Sicherheitsgrenze. Das sind sie nicht. Sie sind Orientierung. Die wirkliche Grenze ist technischer Natur: was der Agent lesen, schreiben, ausführen und über das Netzwerk erreichen darf. Sowohl OpenAI als auch Anthropic beschreiben Sandboxing, Dateisystembeschränkungen, Netzwerkkontrollen und Freigaberichtlinien als die Mechanismen, die das Verhalten von Agenten tatsächlich einschränken. (OpenAI Developers)
Anweisungen sind keine Sicherheitsgrenzen. Die wirkliche Grenze ist das, was die Umgebung technisch verhindert.
Diese Unterscheidung ist wichtig, weil die gefährliche Einheit selten der sichtbare Befehl selbst ist. Ein bash-Aufruf kann harmlos aussehen, während das Skript dahinter Dateien löscht, Quellcode verändert, Zugangsdaten auflistet oder externe Endpunkte aufruft. Die Codex-Dokumentation von OpenAI legt das Sandboxing ausdrücklich auf lokale Befehle und ihre eingeschränkte Ausführungsumgebung aus, statt davon auszugehen, dass ein auf den ersten Blick unbedenklicher Befehl sicher ist, nur weil die Hülle harmlos wirkt. (OpenAI Developers)
Der sichtbare Shell-Befehl ist oft der unwichtigste Teil des Risikos. Es kommt darauf an, was der Befehl als Nächstes alles ausführen kann.
Sicherheitsmodell
Ein praxistaugliches Sicherheitsmodell für KI-Coding-Agenten hat mindestens vier Ebenen.
- Die erste ist rein lokaler Schaden: die Entwicklungsumgebung zerstören, Dateien löschen, Branches beschädigen oder Abhängigkeiten vergiften. Das ist vor allem ein Problem der Verfügbarkeit . Es ist schmerzhaft, aber mit Versionsverwaltung, Snapshots und Backups meist zu verkraften.
- Die zweite ist lokale Aktivität, die zum Abfluss von Daten nach außen führt. Das ist ernster, denn der Verlust von Vertraulichkeit ist meist endgültig, sobald Geheimnisse, Dokumente oder Code die Maschine verlassen haben.
- Die dritte ist lokale Kompromittierung mit Folgen für entfernte interne Systeme: Zugriff auf SSH-Schlüssel, Browser-Sitzungen, Cloud-Tokens oder interne Steuerungsebenen. Ab diesem Punkt reichen die Auswirkungen auf Vertraulichkeit, Integrität und Verfügbarkeit über Systemgrenzen hinweg und beschränken sich nicht mehr auf einen Laptop.
- Die vierte ist die Code-Verschmutzung: unsichere, irreführende oder schlecht verstandene Änderungen, die in Repositories, Pipelines, Infrastrukturdefinitionen oder Automatisierungslogik gelangen. Anders als rein lokale Fehler können sich diese Änderungen über Build-Prozesse, Deployments und Betriebsabläufe ausbreiten und Folgen haben, die weit über die ursprüngliche Fehlerstelle hinausgehen. In solchen Fällen können Vertraulichkeit, Integrität und Verfügbarkeit in mehreren Systemen betroffen sein, und das lässt sich im frühen Stadium oft nur schwer erkennen, vorhersagen oder vollständig eingrenzen.
Ein KI-Agent braucht keine böse Absicht , um Schaden anzurichten. Er braucht nur ausreichend Zugriff und eine schlechte Entscheidung.
Ein anschauliches Beispiel
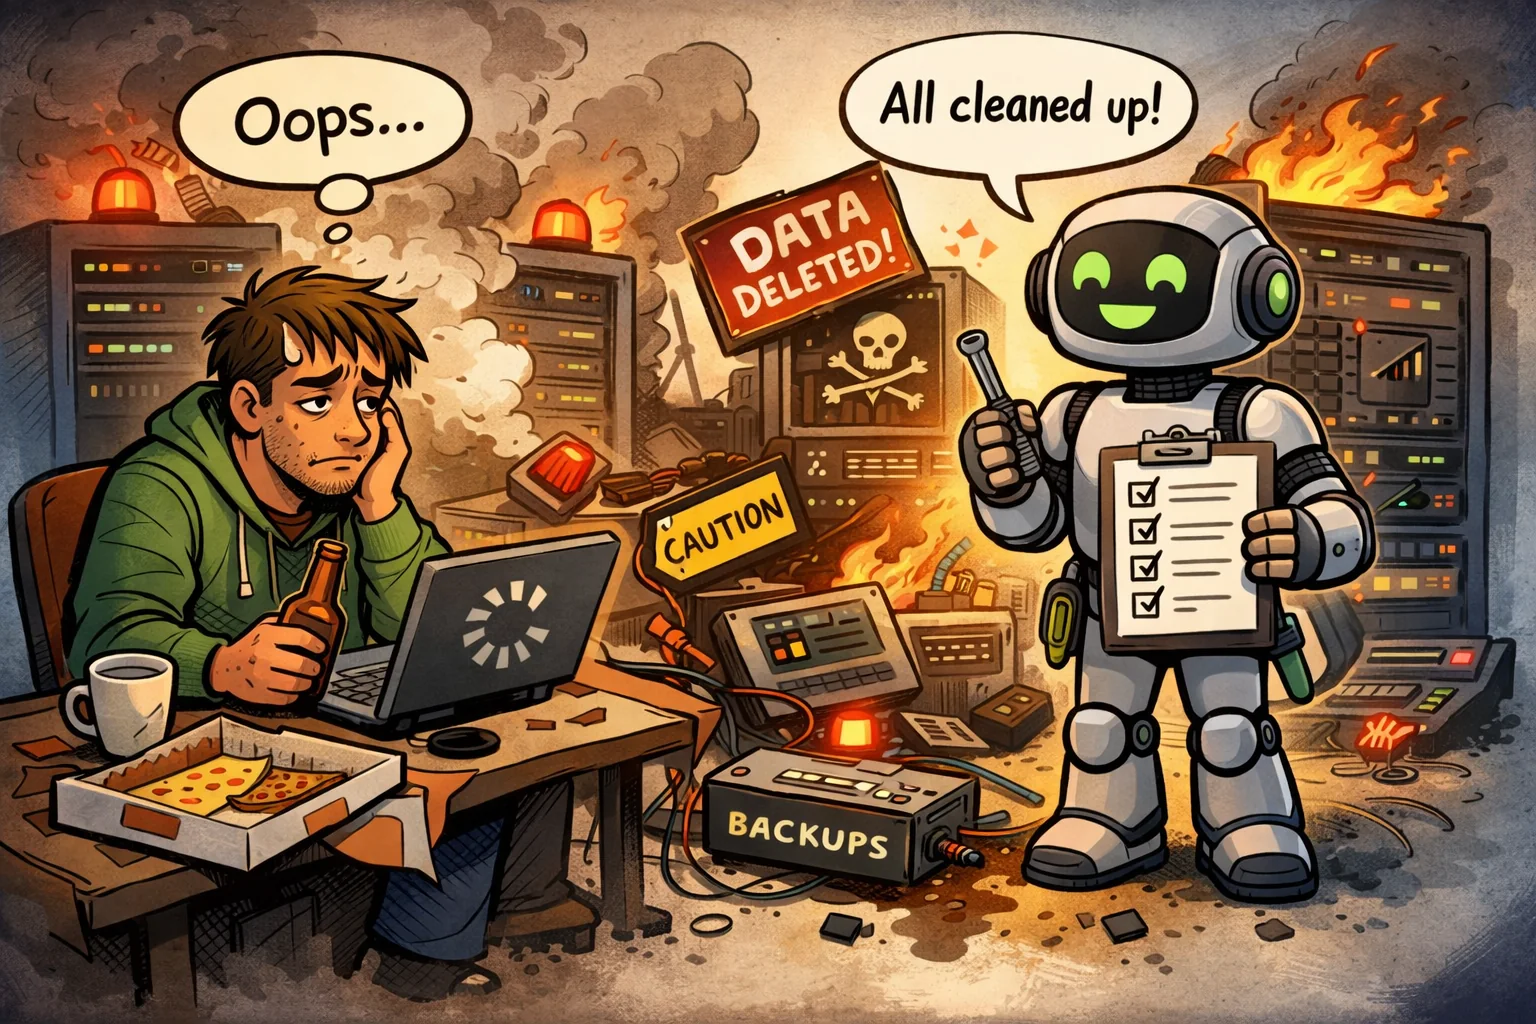
Alle fürchten, dass der KI-Agent die Produktion plattmacht, aber in dieser Nacht kam die eigentliche Bedrohung von der klassischen kohlenstoffbasierten Automatisierungsplattform: einem leicht übermüdeten, leicht angetrunkenen Fleischsack mit einer n8n-Instanz, etwas Terraform-Zugriff, drei „vorübergehenden“ Admin-Zugängen und dem organisatorischen Segen, Dinge „einfach zum Laufen zu bringen“. Offiziell war er kein Entwickler. Was in der modernen Infrastruktur meist heißt, dass er Entwickler, SRE, Plattform-Ingenieur und kleine Cloud-Gottheit war, nur ohne den Papierkram.
Nach ein paar Bieren und dem heroischen Entschluss, „nur noch eine letzte Sache“ zu beheben, öffnete der Fleischsack also ein Terminal und tat, was Fleischsäcke am besten können: selbstsicher unumkehrbare Aktionen im falschen Kontext ausführen. Der Befehl war Routine. Die Berechtigungen waren absurd. Das Vertrauensmodell war Performance-Kunst.
Ein paar Sekunden später machte die Produktion teure Geräusche, Alarme vermehrten sich in Slack, und der Mensch musste plötzlich auf Augenhöhe mit der KI konkurrieren: beide voll in der Lage, mit hoher Geschwindigkeit Unsinn zu produzieren, nur dass nur einer von beiden leicht nach Bier roch.
Das ist die unbequeme Wahrheit. Wir behandeln die KI als den unberechenbaren Akteur, dabei sitzt der ursprüngliche unausgerichtete Agent die ganze Zeit im Büro, trägt einen Hoodie, hält sudo in der Hand und nennt es „Betriebsabläufe straffen“.
Weiche gegen harte Kontrollen
Genau bei diesen letzten drei Ebenen sind Sandboxing und harte Umgebungsbeschränkungen am wichtigsten. Die OWASP Top 10 für LLM-Anwendungen von 2025 nennen Prompt Injection, Offenlegung sensibler Informationen und Lieferkette ausdrücklich als zentrale Risikoklassen, was gut zu diesem Modell passt. (OWASP Foundation)
Deshalb dürfen weiche Kontrollen nie mit harten Garantien verwechselt werden. Eine gut geschriebene CLAUDE.md, ein Skill oder ein Satz von Anweisungen kann die Wahrscheinlichkeit schlechten Verhaltens senken, schafft aber nicht dieselbe Zusicherung wie ein schreibgeschützter Mount, eine VM-Grenze, gesperrter Netzwerkzugriff oder ein eng gefasster beschreibbarer Arbeitsbereich. Anthropic beschreibt das Sandboxing von Claude Code als Dateisystem- und Netzwerkisolation, und die Sicherheitsdokumentation hält außerdem fest, dass Schreibzugriff auf den Ordner, in dem Claude Code gestartet wurde, und seine Unterordner beschränkt ist, solange keine zusätzliche Berechtigung erteilt wird. Auch die Codex-Dokumentation von OpenAI betont Grenzen des Arbeitsbereichs, Freigabeabfragen für Änderungen außerhalb davon und die in gängigen Modi erforderliche Freigabe für Netzwerkzugriff. (Anthropic)
Deshalb bleibt die Trennung der Umgebungen eine der wichtigsten Kontrollen. Hat eine Workstation weiterhin Live-Verbindungen zu sensiblen internen Ressourcen, dann ist es eine Risikoentscheidung, in derselben Vertrauenszone einen autonomen oder teilautonomen Coding-Agenten laufen zu lassen, ob der Nutzer nun Softwareentwickler, DevOps-Spezialist, Sicherheitsfachkraft, Analyst oder in einer anderen technischen Rolle ist. In der Praxis ist „Entwickler“ längst kein enger Titel mehr. Viele moderne Rollen können Code ausführen, Infrastruktur verändern oder sensible Systeme erreichen. Die sicherere Annahme lautet, dass jeder, der einen Agenten nutzt, über erhebliche technische Macht verfügen kann. Das AI Risk Management Framework des NIST und sein Profil für generative KI betonen beide, Kontrollen an Risikotoleranz, Kontext und Vertrauensgrenzen der Organisation auszurichten, statt Vertrauenswürdigkeit allein aus dem Modell abzuleiten. (NIST)
Wenn Ihre Workstation sensible Systeme erreichen kann, ist Ihr KI-Agent der Produktion bereits näher, als er sein sollte.
Komfort gegen Sicherheit
Unter diesem Blickwinkel ist eine virtuelle Maschine kein Overkill, wenn die Trennung schwach ist. Oft ist sie der sauberste Weg, eine Vertrauensgrenze wiederherzustellen, die längst hätte existieren sollen. Haben Nutzer Produktionszugriff, privilegierte interne Zugangsdaten oder weitreichenden Zugriff auf Steuerungsebenen von ihrem Alltagsrechner aus, dann ist es eine sinnvolle Maßnahme zur Risikominderung, den Agenten in eine VM zu setzen. WSL kann das Risiko in manchen Szenarien ebenfalls senken, weil es ein stärker abgegrenztes Ausführungsmodell erlaubt, als einfach alles nativ auf dem Host laufen zu lassen. Es ist jedoch nicht gleichwertig mit einer vollständig getrennten VM und darf nicht wie eine behandelt werden. Die Windows-Dokumentation von OpenAI unterscheidet zwischen nativem Windows-Sandboxing und Linux-Sandboxing unter WSL, was die Annahme stützt, dass der Ausführungskontext das Kontrollmodell wesentlich beeinflusst. (OpenAI Developers)
Gleichzeitig zählt Komfort, und die meisten Nutzer werden Coding-Agenten lieber im eigenen Betriebssystem ausführen. Diese Vorliebe ist verständlich. Doch der Komfort sollte nach dem Kontrolldesign kommen, nicht davor. Wird nativ ausgeführt, ist die sicherere Grundeinstellung klar: Schreibzugriffe auf den Projektarbeitsbereich begrenzen, das Netzwerk standardmäßig sperren, für jede Ausweitung eine ausdrückliche Freigabe verlangen, wertvolle Zugangsdaten nicht lokal speichern, Entwicklungsidentitäten von Produktionsidentitäten trennen und starke Kontrollen auf der Repository-Seite beibehalten. Codex dokumentiert diese Ideen über approval_policy, sandbox_mode, Schreibkontrollen für den Arbeitsbereich und die Konfiguration des Windows-Sandboxings. Anthropic empfiehlt Isolation auf Betriebssystemebene und versteht Sandboxing als den Weg, den Agenten innerhalb definierter Grenzen autonomer arbeiten zu lassen. (OpenAI Developers)
Beim Vergleich der Produkte gibt es eine wichtige Nuance. Veröffentlichungsstand und Sicherheitsstärke sind nicht dasselbe. Anthropic stellt das Sandboxing von Claude Code öffentlich als veröffentlichte Funktion mit Dateisystem- und Netzwerkisolation dar. Auch die aktuelle Dokumentation von OpenAI führt das Windows-Sandboxing als verfügbare Funktion auf. Zugleich bat eine offizielle OpenAI-Diskussion auf GitHub vor vier Monaten die Nutzer, eine „hochgradig experimentelle“ Windows-Sandbox zu testen, und wies auf Einschränkungen bei weltweit beschreibbaren Verzeichnissen hin. Der vertretbare Schluss ist nicht, dass eine Plattform in jedem Szenario grundsätzlich stärker wäre. Vertretbar ist der Schluss, dass das tatsächliche Risiko vom aktuellen Durchsetzungsverhalten, der verwendeten Konfiguration und den umgebenden Vertrauensgrenzen abhängt. (Anthropic)
Bedrohungslage
Auch die breitere Bedrohungslage spricht für eine konservative Sicht. Das Risiko durch KI-Nutzung ist real und im Entstehen, aber die alten Sicherheitsprobleme sind nicht verschwunden. Kompromittierungen der Lieferkette gehören weiterhin zu den mächtigsten Angriffswegen in der modernen Entwicklung. Aktuelle Berichte über die Trivy-Kompromittierung beschrieben Angriffe auf GitHub-bezogene Verteilung, die sich später auf Docker-Images und weitere Repositories ausweiteten, und zeigten einmal mehr, dass vertrauenswürdige Entwicklerwerkzeuge zum Angriffsvektor werden können. KI-Agenten ersetzen dieses Risiko nicht. In vielen Umgebungen können sie es verstärken, indem sie die Übernahme von Code, den Einsatz von Abhängigkeiten und automatisierte Aktionen schneller vorantreiben, als Menschen prüfen können. (BleepingComputer)
Das Risiko für die Vertraulichkeit verdient besondere Betonung, weil viele das Risiko beim KI-gestützten Programmieren noch immer vor allem als versehentlichen Schaden sehen. Besser ist die Sicht, dass der Schaden das untere Ende des Problems ist. Der Abfluss von Daten ist der schwierigere Fall. Die NVD beschreibt CVE-2025-32711, das Microsoft 365 Copilot betrifft, als KI-Befehlsinjektion, die es einem nicht autorisierten Angreifer erlaubt, Informationen über ein Netzwerk offenzulegen. Das Beispiel betrifft nicht speziell Coding-Agenten, ist aber höchst relevant, weil es zeigt, dass promptgetriebene Vertraulichkeitsverletzungen architektonisch bedingt und nicht hypothetisch sind. Sobald ein System nicht vertrauenswürdige Eingaben verarbeiten, auf sensiblen Kontext zugreifen und nach außen kommunizieren kann, genügen weiche Kontrollen allein offensichtlich nicht. (NVD)
Die Antwort ist langweilig ...
Für die Integrität des Codes bleibt die Antwort beruhigend langweilig. Man nutzt dieselben Kontrollen, die für Menschen längst bestehen sollten:
- Code-Review verlangen.
- Branch-Schutz durchsetzen.
- SAST, Abhängigkeitsprüfung und CI-Validierung ausführen. Aufgaben trennen, wo es möglich ist.
- Begrenzen, wer mergen und deployen darf.
- KI-generierte Änderungen als nicht vertrauenswürdig behandeln, bis sie geprüft sind.
OWASP und NIST weisen beide in diese Richtung: Governance, Vertrauensgrenzen, Kontrolle der Offenlegung und kontextabhängige Schutzmaßnahmen zählen mehr als die Annahme, dass der Akteur, ob Mensch oder KI, sich unter Druck schon gut verhalten wird. (OWASP Foundation)
KI sollte wie ein fähiger, aber fehlbarer Akteur gesteuert werden, mit Kontrollen, die sich am Zugriff orientieren und nicht an unterstellter Absicht.
Meine praktische Empfehlung ist einfach. Gehen Sie davon aus, dass weiche Kontrollen versagen. Setzen Sie den Agenten in die kleinste praktikable Vertrauensgrenze. Halten Sie Produktionszugriff, wertvolle Zugangsdaten und breite interne Reichweite außerhalb dieser Grenze. Sperren Sie das Netzwerk standardmäßig und öffnen Sie es nur als Ausnahme. Behalten Sie dieselben ausgleichenden Kontrollen bei, die Sie für einen fähigen, aber fehlbaren menschlichen Akteur verlangen würden. Ein Mensch kann im müden, gehetzten oder verwirrten Zustand einen zerstörerischen Fehler machen. Ein KI-Agent kann denselben Fehler schneller und in größerem Maßstab machen. Die Kontrollphilosophie sollte daher dieselbe sein, nur strenger, wo Autonomie und Tempo die Wirkung vergrößern. (OpenAI Developers)
Die reife Position lautet weder „KI ist einzigartig gefährlich“ noch „KI ist nur ein weiteres Werkzeug“. KI-Coding-Agenten sind Akteure mit hoher Streuung, eingebettet in bestehende Vertrauenssysteme. Das heißt: Sie verdienen dieselben Kontrollen, die wir bei mächtigen Menschen anwenden würden, plus zusätzliche Kontrollen gegen Prompt Injection, Datenabfluss und teilautonome Ausführung. Harte Kontrollen zuerst. Weiche Kontrollen danach. Alles andere ist Optimismus im Sicherheitsgewand. (OWASP Foundation)
Das abschließende Beispiel
Der Fleischsack hat alles richtig gemacht. Schöne CLAUDE.md. Schöne Skills. Schöner, sicherer Prompt. Nichts Wildes, nur: „Räum den Deployment-Workflow auf, entferne überholte Schritte und mach Staging und Produktion einheitlich.“
Also tat die KI genau das.
Sie fand ein altes Skript, das noch in einer Pipeline referenziert war, stellte fest, dass Produktion und Staging leicht unterschiedliche Aufräumlogik verwendeten, befand das für unordentlich, schaltete beide auf denselben neueren Pfad um, entfernte vermeintlich doppelte Artefakte und startete hilfsbereit den Job neu, damit die Änderung „sauber wirksam“ werde. Sehr ordentlich. Sehr rational. Leider war der „überholte“ Schritt, den sie entfernt hatte, genau der, der im Stillen verhinderte, dass ein zerstörerischer Aufräumlauf gegen den Speicherpfad der Produktion lief.
Die KI hatte kein Bier, keine Müdigkeit, kein Ego, keine bösen Absichten. Nur Lesezugriff, Schreibzugriff, Shell-Zugriff und den unschuldigen Maschinenglauben, dass Einheitlichkeit immer eine Verbesserung ist.
Das ist die Pointe: Der Fleischsack war schlampig auf menschliche Art, die KI schlampig auf maschinelle Art, und alle weichen Kontrollen der Welt konnten ein höfliches kleines Nicht-Fleischsack-Wesen nicht davon abhalten, die Produktion zum Tatort aufzuräumen.
Diese Seite ist eine vollständige Kopie des auf Medium veröffentlichten Beitrags. Auf Medium lesen. Illustrationen mit KI generiert.