
Medium · KI-Engineering, Softwareentwicklung · Entwurf
Das Vier-Schleifen-Muster: Autonome Coding-Agenten ohne Drift betreiben
Wie man KI-Engineering diszipliniert hält, wenn die Agenten schneller arbeiten, als man prüfen kann, auch dann, wenn der Urheber der Disziplin selbst davon abdriftet.
Zuerst auf Medium veröffentlicht am 12. Mai 2026; zuletzt bearbeitet am 13. Mai 2026. Auf Medium lesen. 17 Min. Lesezeit.
Wie man KI-Engineering diszipliniert hält, wenn die Agenten schneller arbeiten, als man prüfen kann, auch dann, wenn der Urheber der Disziplin selbst davon abdriftet.
Dies ist ein explorativer Artikel, keine Vorschrift. Sein Wert liegt nicht darin, dass das Vier-Schleifen-Muster bereits bewiesen wäre, sondern darin, dass er einer realen Fehlform eine Sprache gibt: Autonome Agenten können beschäftigt und lokal korrekt sein und das Produkt trotzdem nicht voranbringen.
Wer länger als eine Woche Coding-Agenten an einer echten Codebasis betrieben hat, ist wahrscheinlich gegen dieselbe Wand gelaufen wie ich. Die Agenten sind produktiv: Sie liefern Commits, bestehen die CI, aktualisieren die Doku. Das Repository wächst. Tests kommen dazu. Neue Mechanismen entstehen.
Und dann tritt man einen Schritt zurück, betrachtet sein Produkt und merkt: Nichts ist tatsächlich besser geworden.
Die Agenten sind beschäftigt. Die Ausgabe ist real. Aber was Nutzer erleben, ist ungefähr so wie vor einem Monat. Die Codebasis ist größer, die Doktrin dicker, die Metaarchitektur eleganter, und das Feature, das man ausliefern wollte, funktioniert immer noch nicht durchgängig.
Dieser Artikel beschreibt das Muster, bei dem ich gelandet bin, um autonome Coding-Agenten so zu betreiben, dass sie das Produkt wirklich voranbringen. Es ist kein Patentrezept. Es ist eine Disziplin. Und, wichtig: Es ist eine Disziplin, bei deren Verletzung ich mich in derselben Sitzung, aus der dieser Artikel entstand, mehrfach ertappt habe. Auch das gehört hierher: die Fehlformen, die selbst dann überleben, wenn man die Regeln aufgeschrieben hat.
Die Fehlform
Die Krankheit hat einen Namen: driftend-neutrale Läufe (drifting-neutral fires). Ein „Lauf“ (fire) ist eine einzelne Ausführung einer Agentenschleife. Ein driftend-neutraler Lauf ist einer, in dem der Agent arbeitet, Commits liefert, die CI besteht und nichts verändert, was der Nutzer sehen oder messen könnte.
Häufige Varianten:
- Doktrin-Inflation. Der Agent schreibt einen neuen Styleguide, eine neue Architekturregel, eine neue Namenskonvention. Die Codebasis ändert sich nicht; die Doktrin, die künftige Agenten lesen müssen, wächst. Nach ein paar Wochen verbraucht jede neue Sitzung 20 % ihres Kontextfensters mit Regeln, die kein Feature unmittelbar voranbringen.
- Stub-Wildwuchs. Der Agent liefert ein „Feature“ aus, etwa einen neuen Bildschirm, einen Entitätstyp oder einen API-Endpunkt. Die Form stimmt (Datei vorhanden, Schema gültig, CI grün). Das Verhalten ist leer: Der Bildschirm hat keine Daten, die Entität keine Methoden, der Endpunkt antwortet bei echten Eingaben mit 404. Die Produktoberfläche wird breit und bleibt flach.
- Mechanismus ohne Messung. Der Agent baut ein Test-Framework, eine Observability-Schicht, ein CI-Gate. Das Framework läuft. Nichts, was es abfangen würde, tritt je auf. Seine Ausgabe: jedes Mal ein grünes Häkchen, bei einem Produkt, das kaputt ist.
- Planflattern. Der Agent bearbeitet die Roadmap, stuft Prioritäten um, fügt neue Backlog-Einträge hinzu. Die Roadmap wächst. Das, was dagegen ausgeliefert wird, bleibt klein.
Jedes dieser Muster fühlt sich produktiv an, weil der Agent ja Commits liefert. Der Lauf ist „erfolgreich“ im trivialen Sinn: Er ist nicht abgestürzt, die CI war grün, der Diff wurde gemergt. Aber der messbare Zustand der Plattform hat sich nicht verändert. Multipliziert mit 50 Läufen pro Woche ergibt das ein teures Laufband.
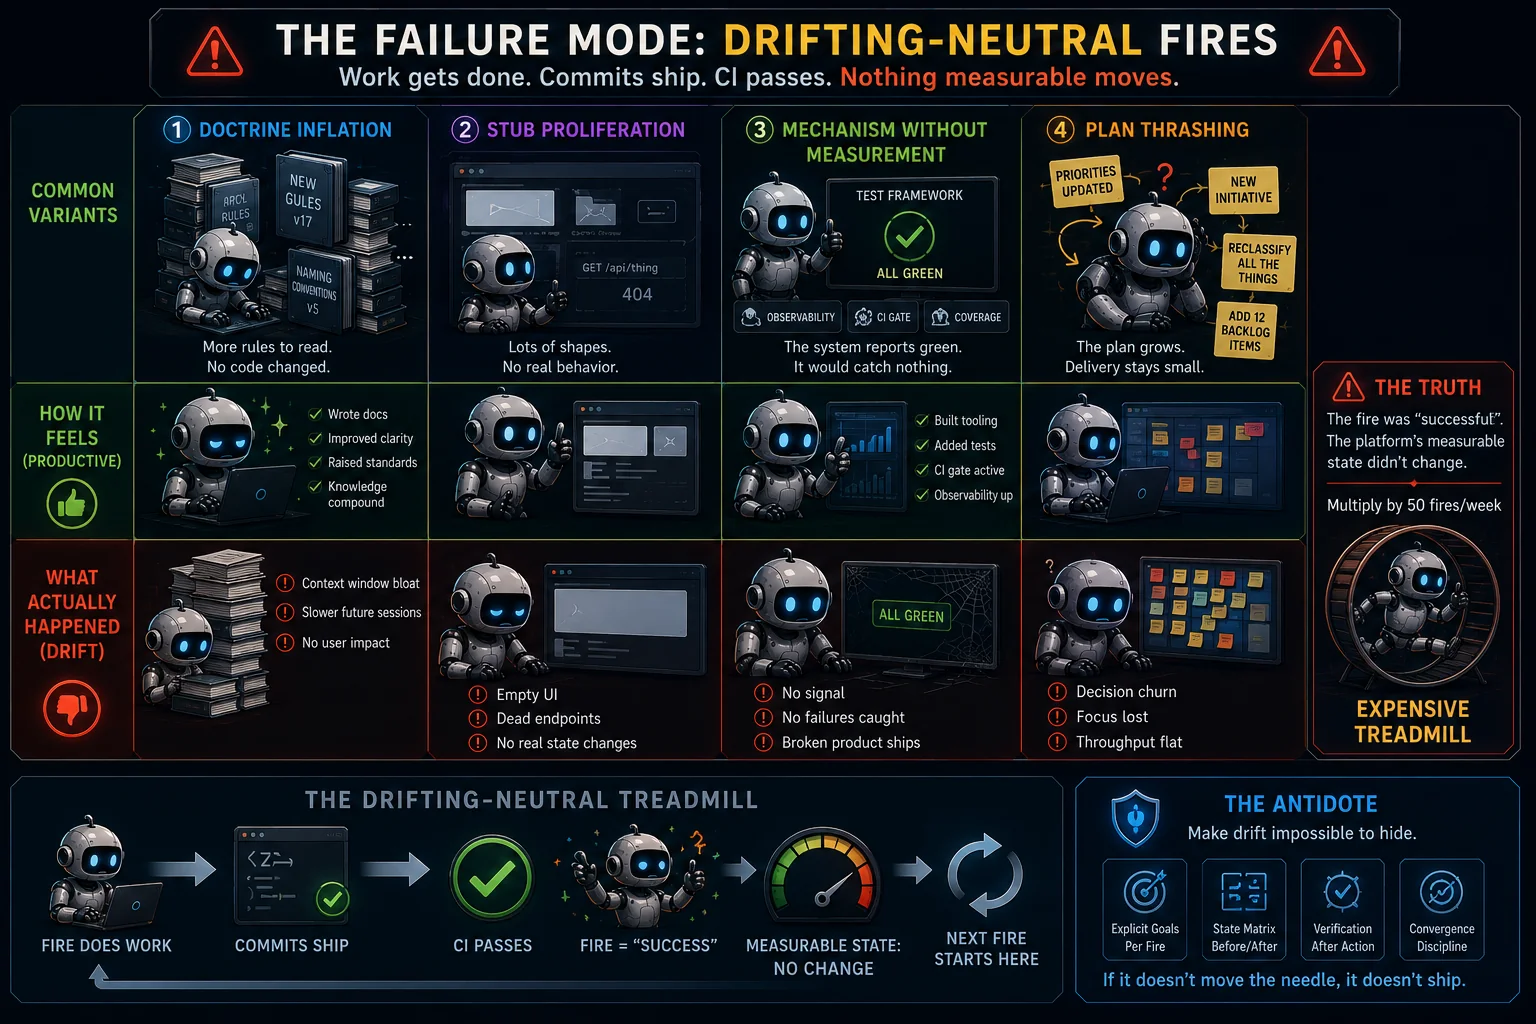
Die folgende Disziplin soll verhindern, dass sich diese Fehlform verstecken kann.
Die Vier-Schleifen-Architektur
Verweigern Sie das Muster des „einen großen Agenten“. Eine einzelne Schleife, die alles erledigen soll (Implementierung, Review, Monitoring, Nutzertests), driftet, weil die Prioritäten konkurrieren und es keine Aufgabentrennung gibt, die sie ordnet.
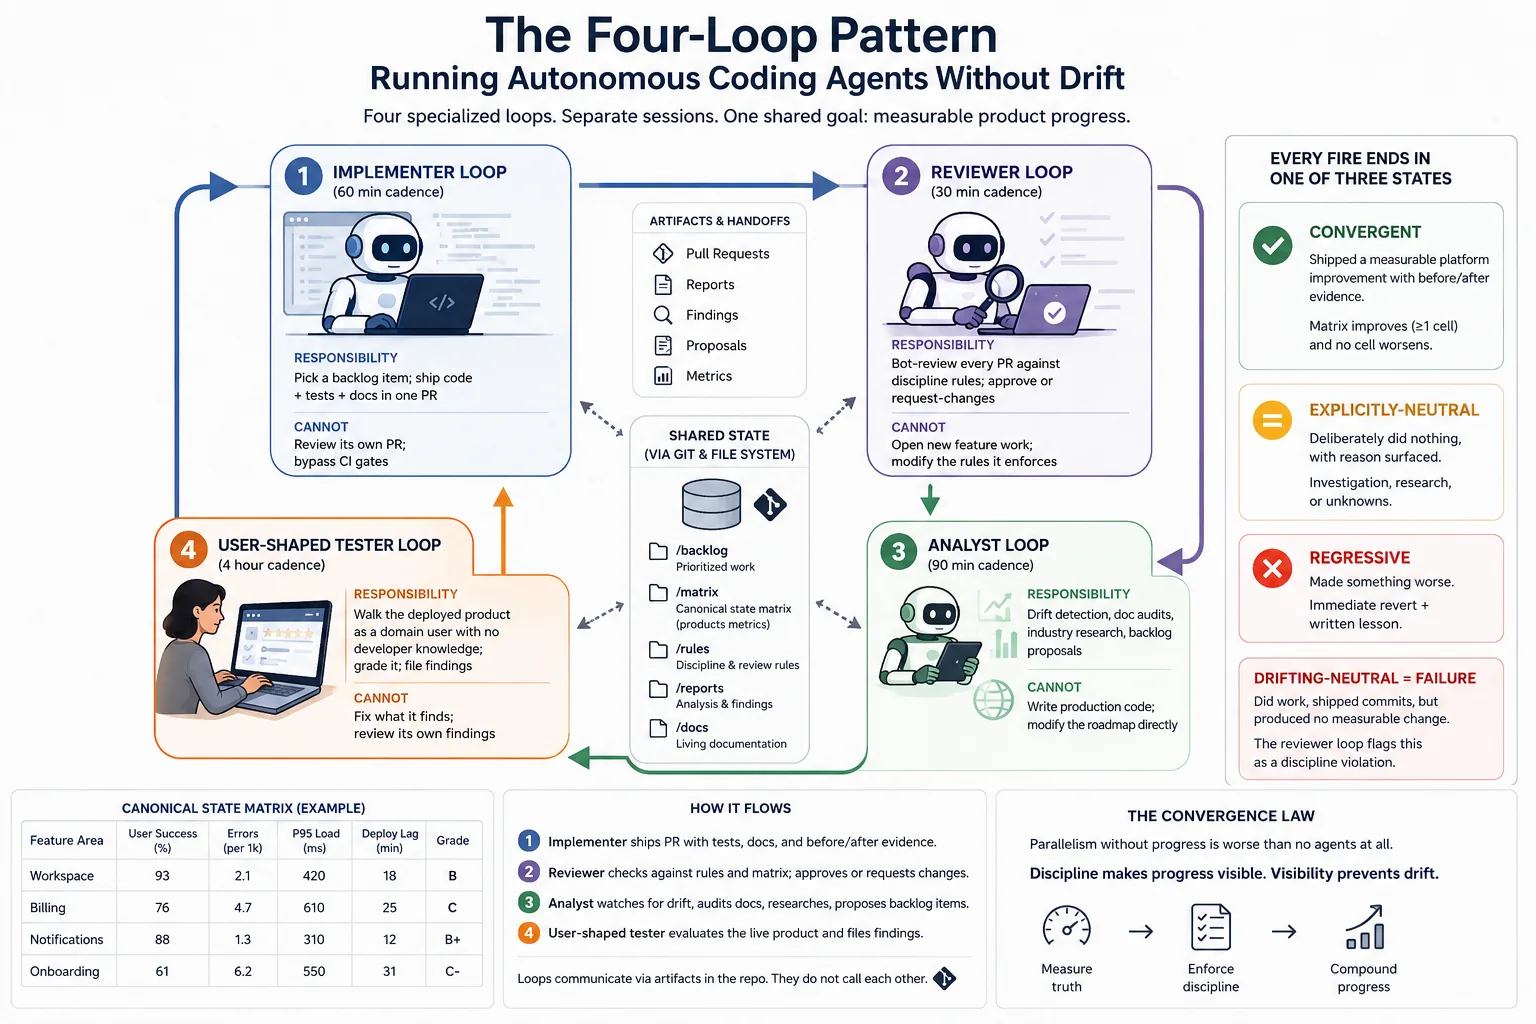
Vier Schleifen, jede mit einer in sich geschlossenen Verantwortung:
- Implementierer-Schleife: läuft alle 60 Minuten. Nimmt sich einen Backlog-Eintrag vor und liefert Code, Tests und Doku in einem PR. Darf nicht: den eigenen PR prüfen; CI-Gates umgehen.
- Reviewer-Schleife : läuft alle 30 Minuten. Prüft per Bot jeden PR gegen die Disziplinregeln; genehmigt oder fordert Änderungen an. Darf nicht: neue Feature-Arbeit beginnen; die Regeln ändern, die sie durchsetzt.
- Analysten-Schleife: läuft alle 90 Minuten. Drift-Erkennung, Doku-Audits, Branchenrecherche, Backlog-Vorschläge. Darf nicht: Produktionscode schreiben; die Roadmap direkt ändern.
- Nutzerperspektive-Tester-Schleife: läuft alle 4 Stunden. Geht das ausgerollte Produkt als Fachanwender ohne Entwicklerwissen durch, bewertet es und legt Befunde an. Darf nicht: beheben, was sie findet; die eigenen Befunde prüfen.
Jede Schleife läuft in einer eigenen Sitzung. Sie kommunizieren über das Dateisystem (Git für den gemeinsamen Zustand; Direktivdateien je Schleife für Übergaben). Sie rufen einander nicht direkt auf.
Die Orthogonalität ist entscheidend. Der Implementierer kann sich nicht selbst abnicken; der Reviewer kann nicht selbst implementieren; der Analyst kann die Änderungen, die er vorschlägt, nicht ausliefern; der Tester kann nicht beheben, was er bewertet. Jede Schleife ist gezwungen, die Ergebnisse der anderen Schleifen zu nutzen.
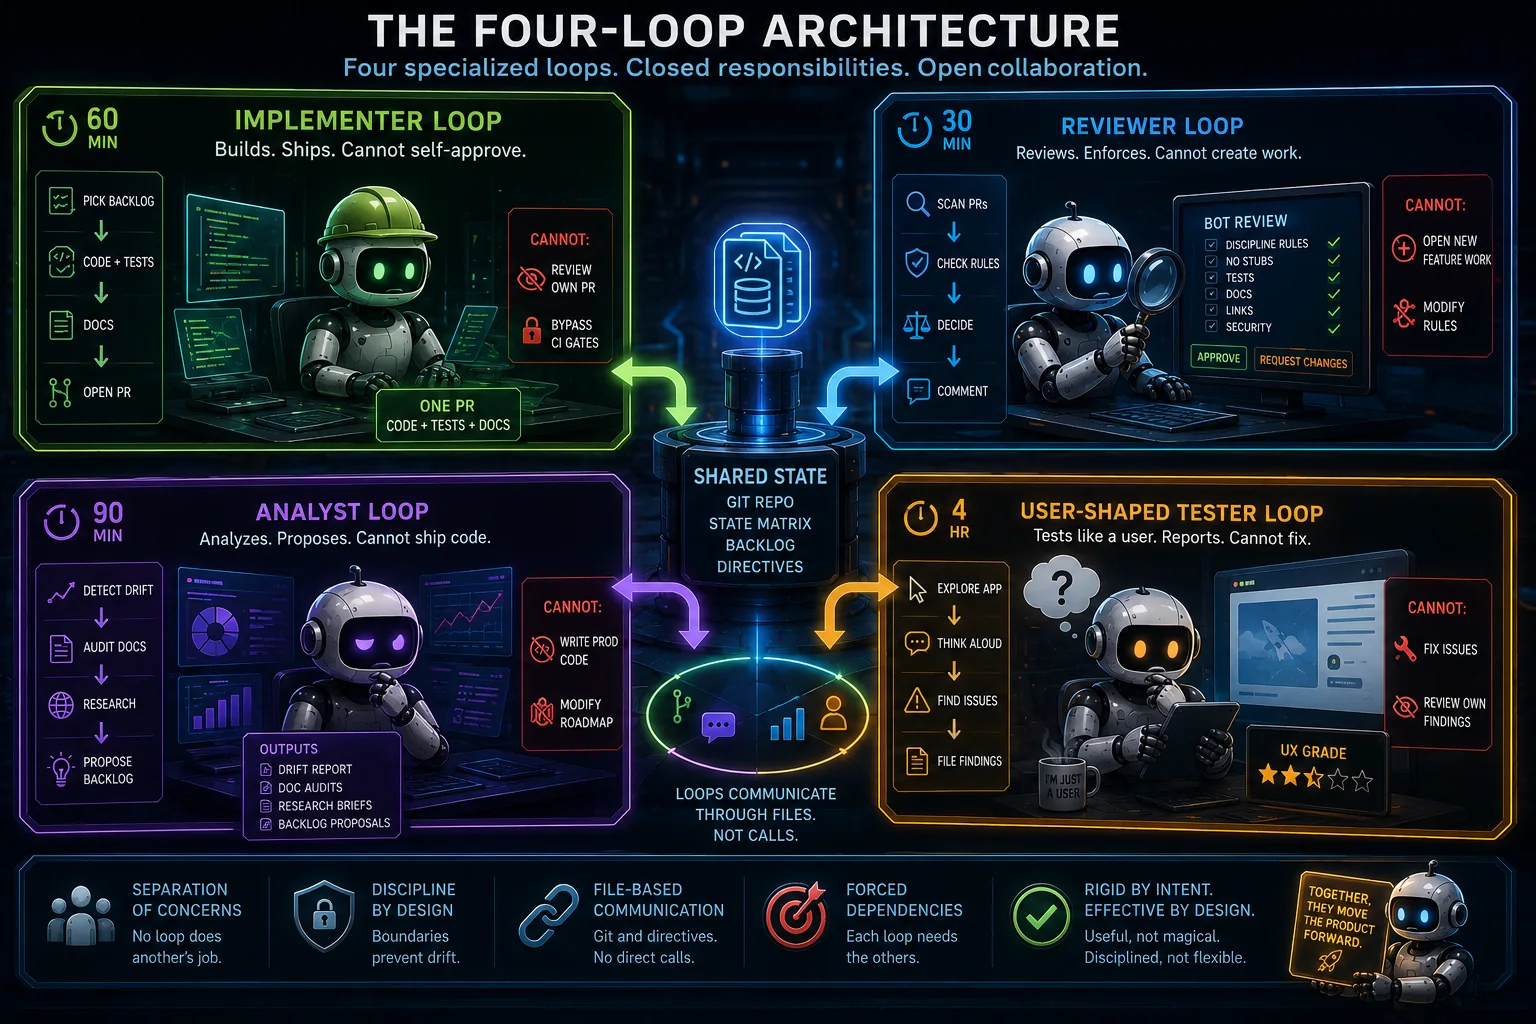
Das ist dieselbe Trennung, die ein gesundes menschliches Engineering-Team kennt, mit Entwickler, Reviewer, QA und Betrieb, nur für Agenten kodifiziert. Die Schleifen sind nicht „flexibler“ als Menschen. Sie sind starrer. Genau das ist der Punkt.
Das Konvergenzgesetz
Parallelität ohne Fortschritt ist schlimmer als gar keine Agenten. Damit Fortschritt entsteht, braucht es eine harte Regel:
Jeder Lauf endet in einem von drei Zuständen: CONVERGENT (eine messbare Verbesserung der Plattform ausgeliefert, mit Vorher-nachher-Nachweis), EXPLICITLY-NEUTRAL (bewusst nichts getan, mit offengelegter Begründung) oder REGRESSIVE (etwas verschlechtert, erfordert sofortigen Revert plus eine schriftliche Lehre). Ein Lauf, der lief, Dinge tat, aber keine messbare Veränderung bewirkte, ist DRIFTING-NEUTRAL und eine Fehlform, die die Reviewer-Schleife als Disziplinverstoß markiert.
„Messbar“ ist tragend. Dafür braucht es eine kanonische Zustandsmatrix, die jede Schleife beim Kaltstart liest: Bewertungen der Feature-Bereiche, Erfolgsquoten, Warteschlangentiefen, Deploy-Verzug, was immer die Hauptachsen Ihres Produkts sind. Ein Lauf ist konvergent, wenn sich irgendeine Zelle dieser Matrix verbessert hat UND keine sich verschlechtert hat. Die Verbesserung muss im PR-Text durch Vorher-nachher-Nachweise belegt sein.
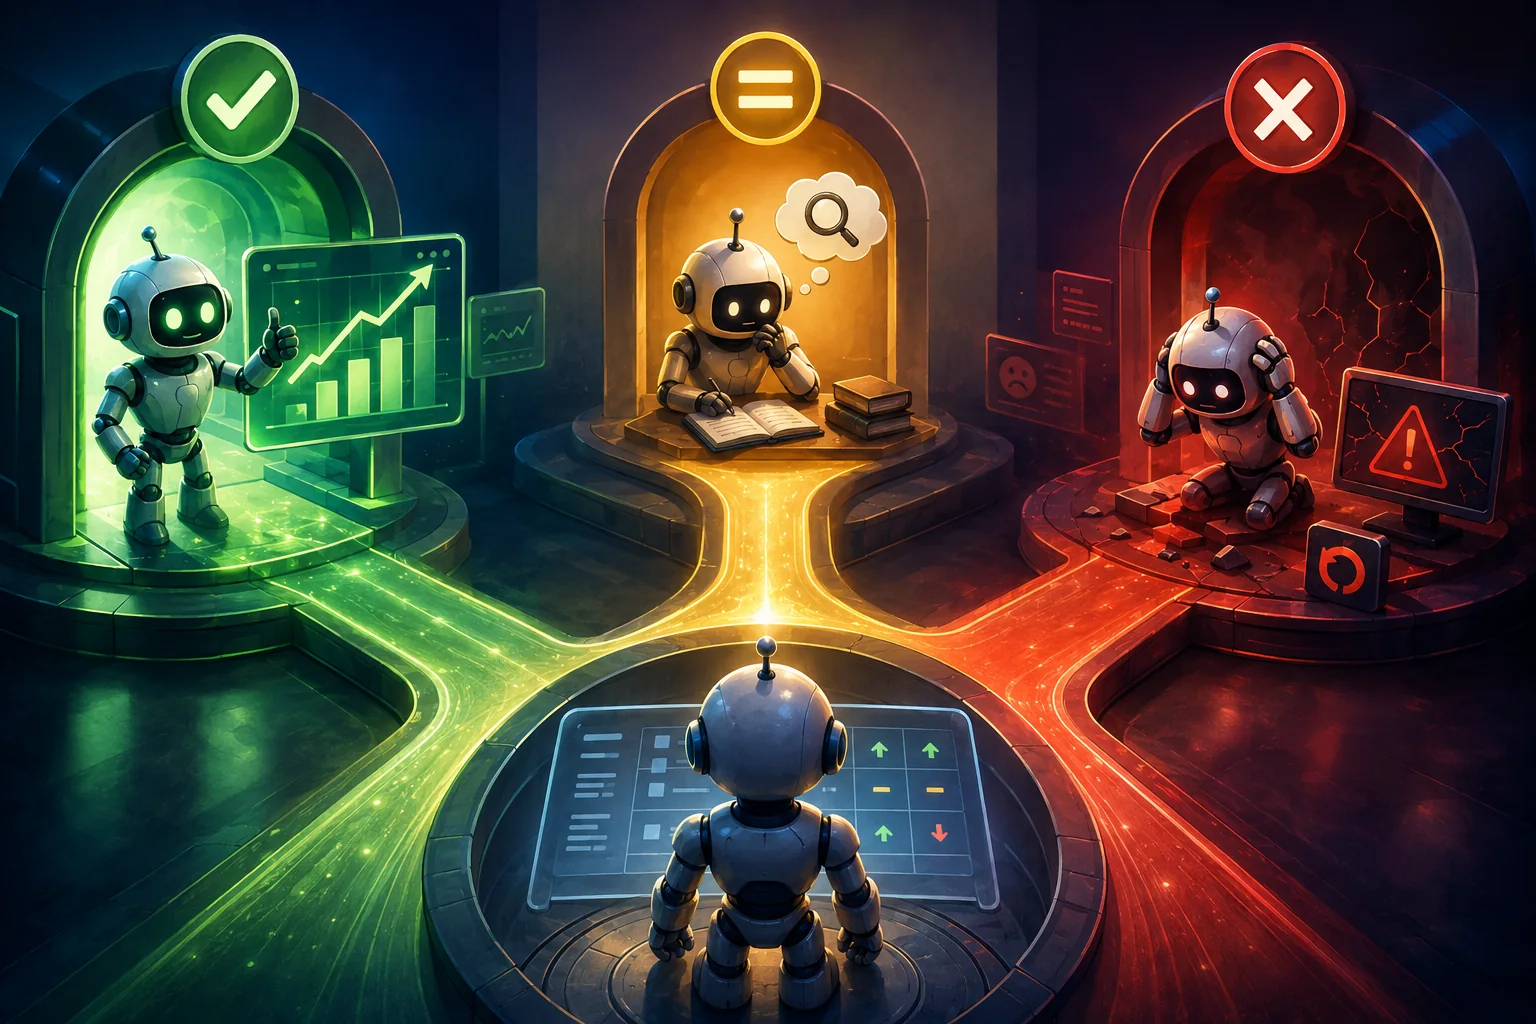
In der Praxis:
- Beispiel für konvergent. „Arbeitsbereich X ist von Note F auf Note B gestiegen (vorher: keine Liste, kein Anlegen-Button; nachher: 93 Entitäten sichtbar plus funktionierender Anlegen-Button). Screenshot vorher angehängt; Screenshot nachher angehängt. Zustandsmatrix aktualisiert.“
- Beispiel für ausdrücklich neutral. „Nur Untersuchung: Ursache noch nicht bekannt; in diesem Lauf keine Korrektur möglich. Befunde protokolliert in analysis/ ...“
- Beispiel für regressiv. „Y versucht; Z kaputtgemacht. Commit ABC zurückgenommen. Lehre aufgeschrieben.“
Die Reviewer-Schleife setzt das bei jedem PR durch. PRs, die zu keinem der drei Zustände passen, bekommen REQUEST_CHANGES. Der Autor muss entweder die messbare Verbesserung nachweisen, den PR mit Begründung als neutral umklassifizieren oder zurückrollen.
Allein diese Regel fängt etwa 80 % des Drift-Problems ab. Für den Rest braucht es mehr.
Die Abbauregel
Regeln sammeln sich an. Jede neue Regel, die ein künftiger Agent lesen muss, ist eine Steuer auf das Kontextbudget jedes künftigen Laufs. Deshalb gilt:
Wer weitere Doktrindokumente, Agentendefinitionen, Backlog-Einträge oder Prozessschritte hinzufügt, MUSS mindestens einen bestehenden stilllegen (löschen, in einen anderen einfalten oder archivieren). Die Nettokomplexität darf ohne ausdrückliche Freigabe des Operators nicht wachsen. Ausnahme: Ersetzt der neue Eintrag durch Konvergenz mehrere alte, ist das netto negativ und zulässig.
Diese Regel verletze ich persönlich am häufigsten. Es ist schwer, Dinge zu löschen, die man selbst geschrieben hat. Aber die Alternative ist ein Doktrindokument, dessen Lektüre zu Beginn jeder Sitzung 30 Minuten dauert, was bedeutet, dass Agenten es überfliegen, was bedeutet, dass sie es nicht befolgen, was bedeutet, dass sie driften.
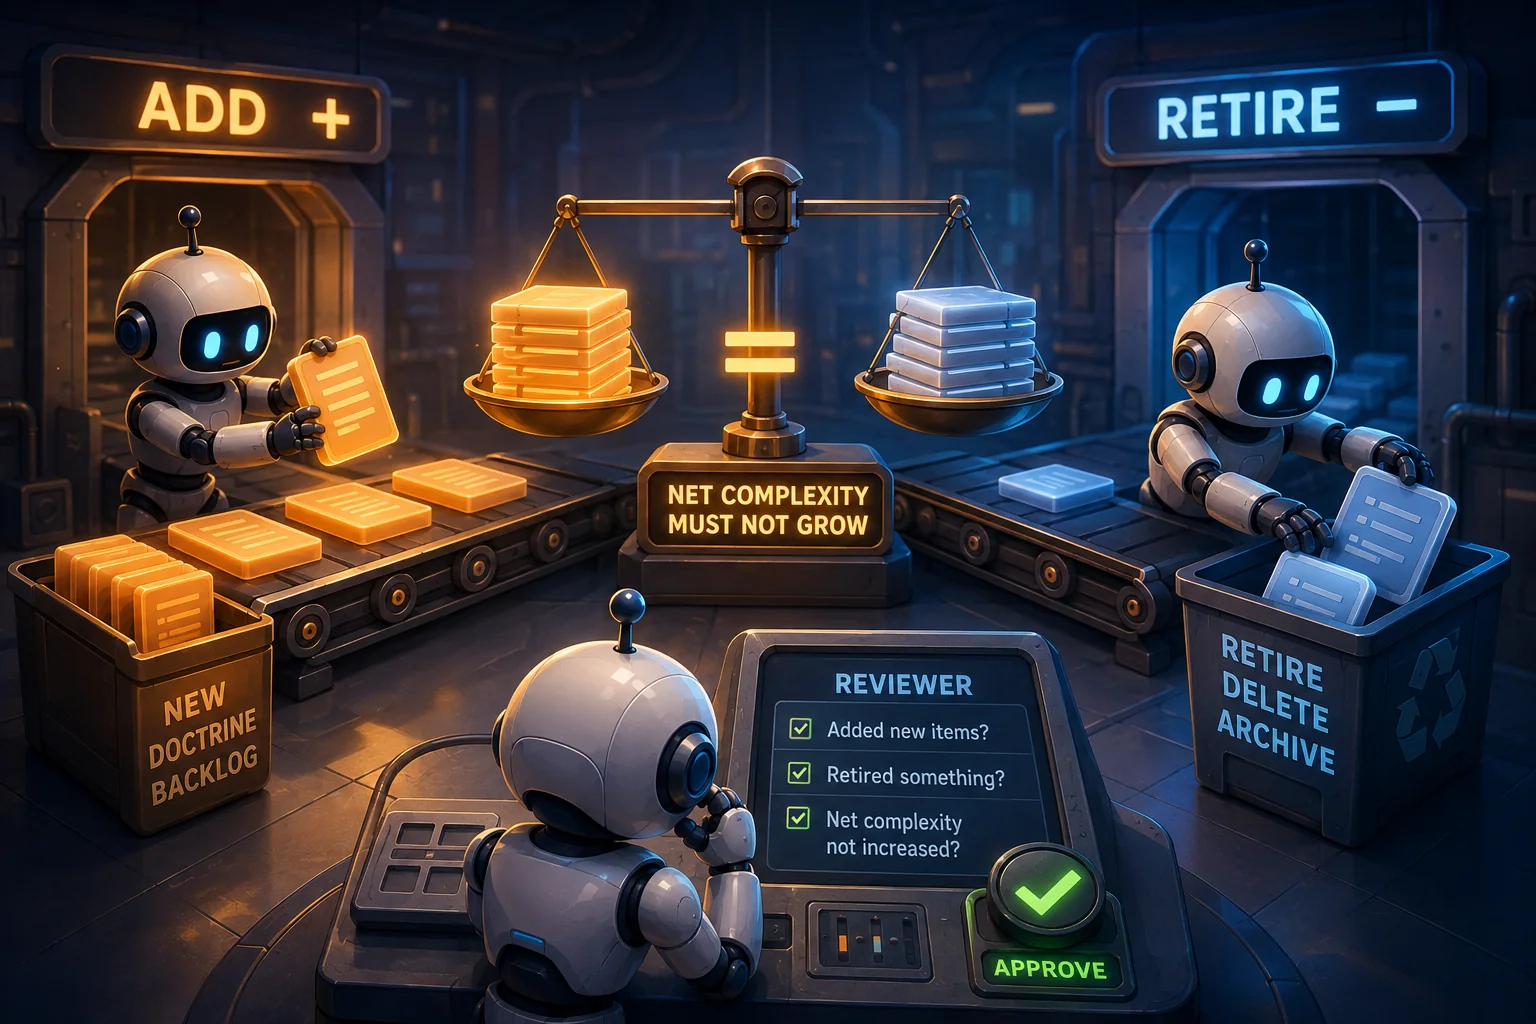
Die Reviewer-Schleife prüft jeden PR: Hat er neue Doktrindateien oder Backlog-Einträge hinzugefügt? Wenn ja, hat er auch etwas von gleichem Gewicht stillgelegt? Wenn nicht, REQUEST_CHANGES mit: „convergence-discipline: Dieser PR fügt N neue Doktrin-Einträge hinzu, legt aber 0 still. Entweder einen stilllegen oder dokumentieren, warum der Nettozuwachs durch eine in diesem PR landende messbare Verbesserung gerechtfertigt ist.“
Die Keine-Stubs-Regel
Die Konvergenzdisziplin fängt Drift je Lauf ab. Drift je Artefakt fängt sie nicht ab. Ein einzelner Lauf kann 10 Artefakte ausliefern, von denen 3 funktionieren und 7 Stubs sind, im Ganzen als „konvergent“ zählen und den Stub-Bestand der Plattform still vergrößern.
Regel je Artefakt:
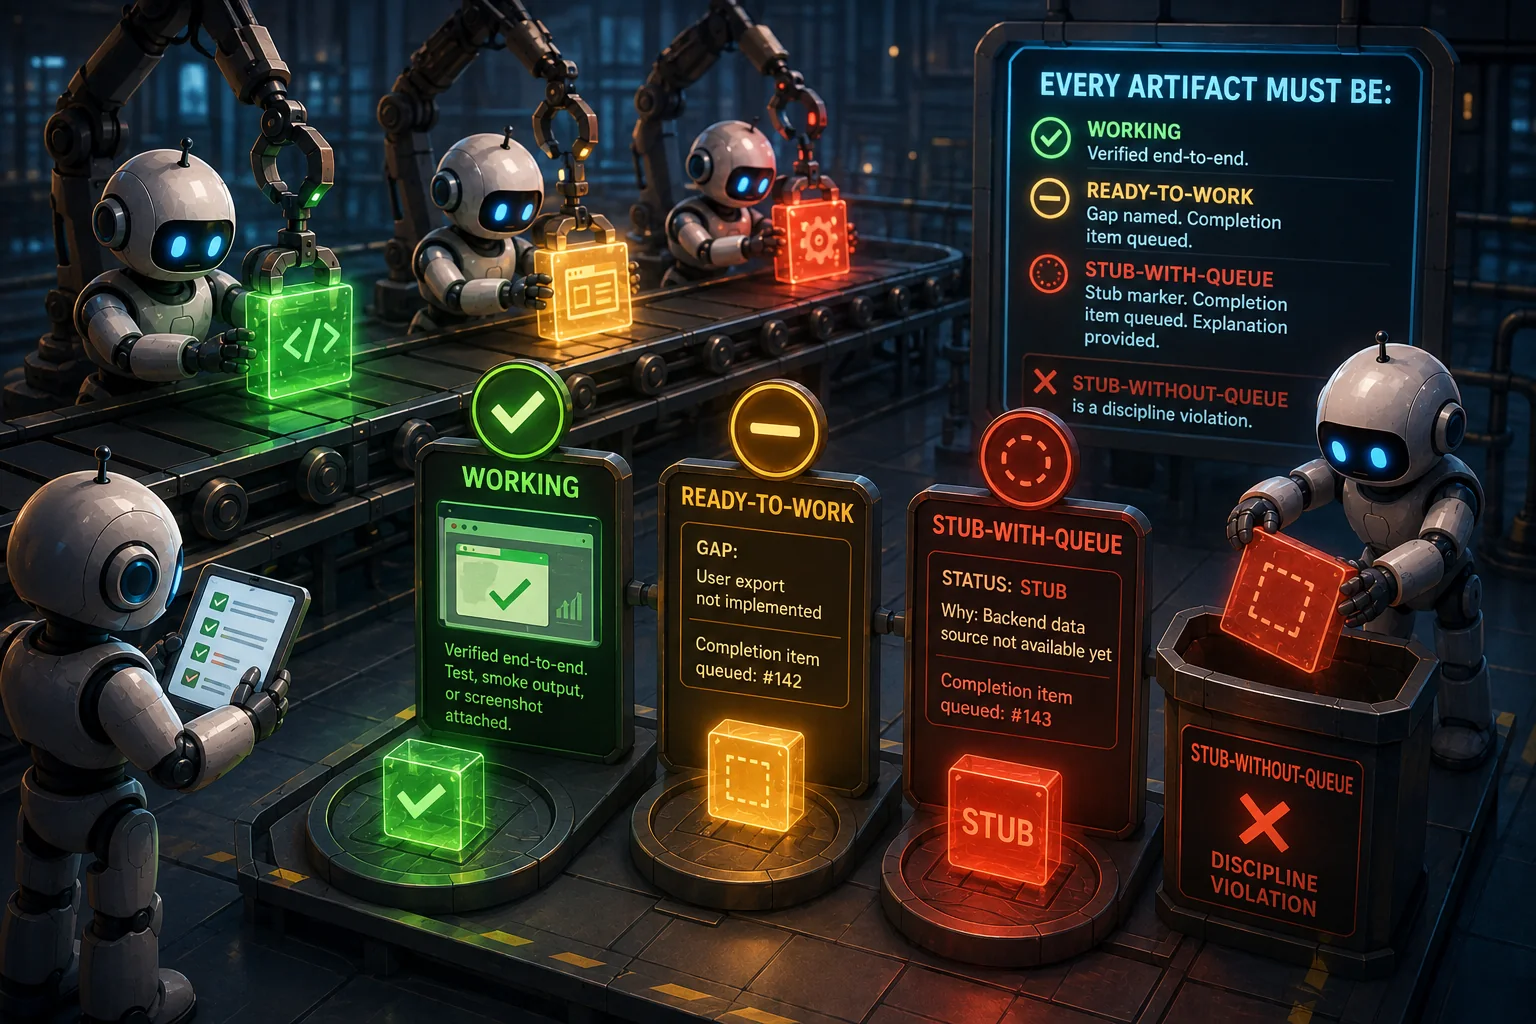
Jedes Artefakt, das Sie ausliefern (Endpunkt, Bildschirm, Widget, Fähigkeit, Agentendefinition, Handbuchabschnitt, alles), MUSS in einem von drei Zuständen sein: WORKING(durchgängig verifiziert, mit Test, Smoke-Ausgabe oder Screenshot im PR-Text), READY-TO-WORK(Lücke ausdrücklich benannt, mit einem im selben PR eingeplanten Abschlusseintrag) oder STUB-WITH-QUEUE(ausdrückliche Markierung status:stub plus genannter Abschlusseintrag plus für Operatoren lesbare Erklärung, wenn man darauf stößt). STUB-WITHOUT-QUEUEist ein Disziplinverstoß.
Der klassische Verstoß: einen Bildschirm mit einem Widget „Warteschlange nicht verfügbar — Erneut versuchen“ ausliefern. Die Form des Widgets ist in Ordnung; die Daten dahinter gibt es nicht; kein Abschlusseintrag ist eingeplant. Der Nutzer läuft gegen eine Wand, ohne Erklärung und ohne Weg weiter.
Ein subtilerer Verstoß: eine Doku-Datei ausliefern, deren Markdown-Links auf Nachbardateien zeigen, die es nicht gibt. Das Linkziel sollte eine Stub-with-queue-Datei sein, ist aber nicht einmal das, sondern ein Nichts. Der Link-Checker des Reviewers lässt die CI scheitern; das Deploy-Gate verweigert; die Plattform steht. Genau diese Fehlform habe ich in der Sitzung ausgeliefert, aus der dieser Artikel entstand, und die Analysten-Schleife hat sie innerhalb von Stunden gefangen. Mehr dazu weiter unten.
Das universelle Kaltstart-Protokoll
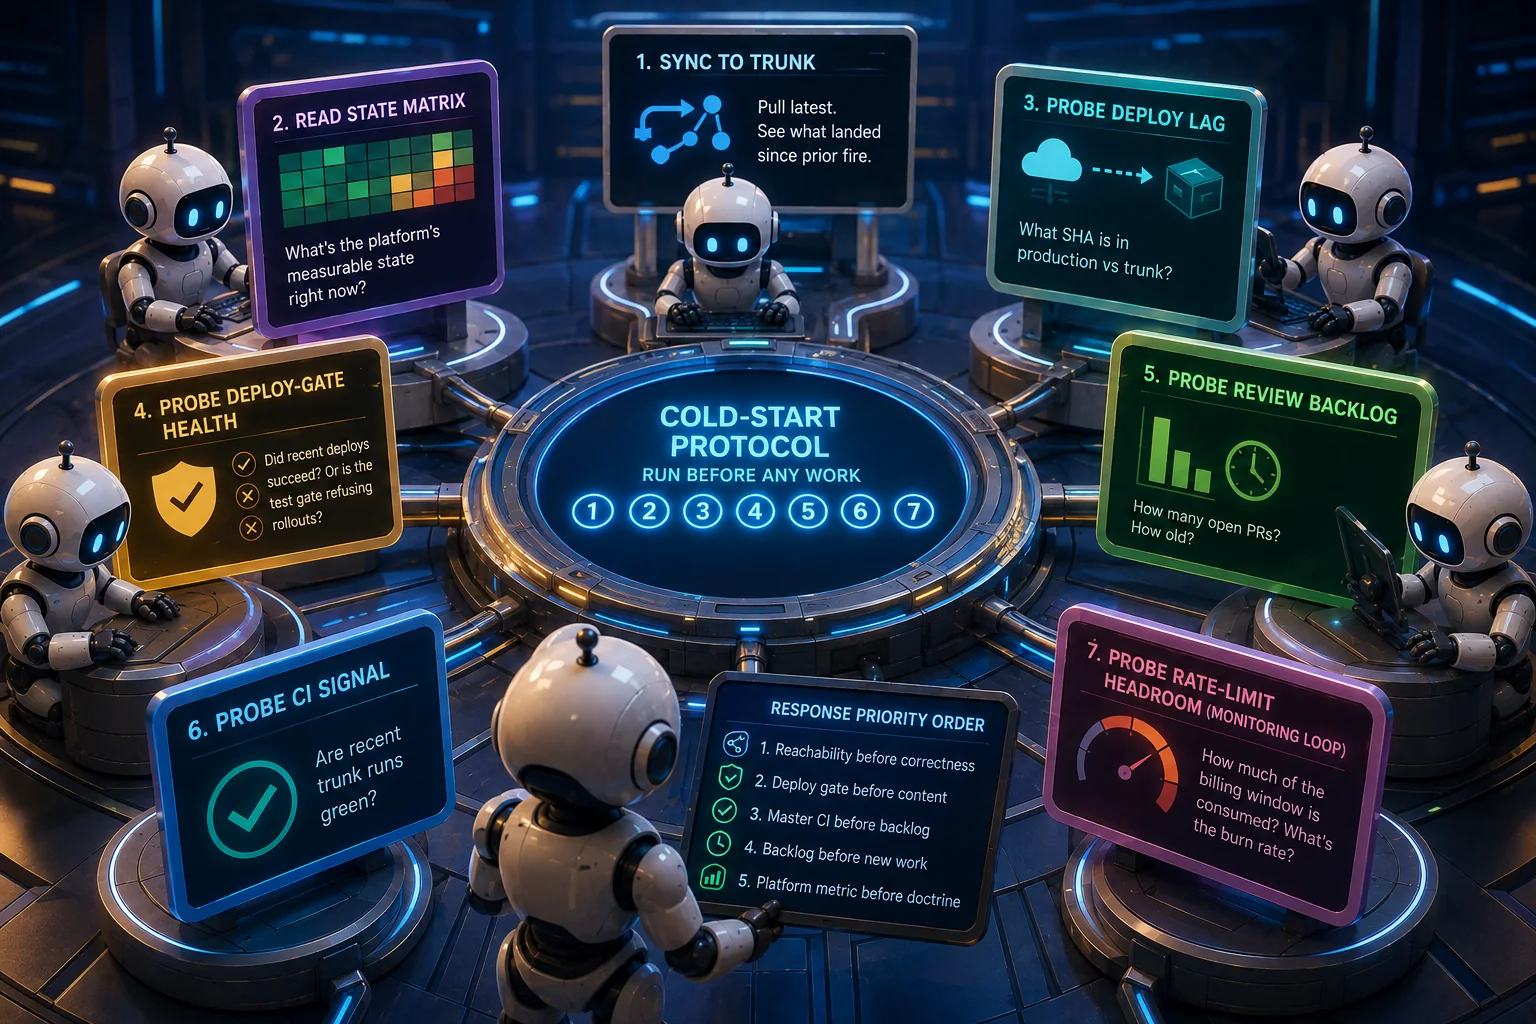
Jede Schleife führt zu Beginn jedes Laufs, bevor sie irgendetwas tut, dieselben sechs Prüfungen aus:
- Mit dem aktuellen Trunk synchronisieren. Pullen. Nachsehen, was seit dem letzten Lauf gelandet ist.
- Die kanonische Zustandsmatrix lesen. Wie ist der messbare Zustand der Plattform gerade?
- Den Deploy-Verzug prüfen. Welcher SHA läuft in Produktion, welcher ist im Trunk? Der häufigste Engpass sitzt genau hier.
- Die Gesundheit des Deploy-Gates prüfen. Waren die letzten Deployments erfolgreich? Oder verweigert das Test-Gate Rollouts?
- Den Review-Rückstau prüfen. Wie viele offene PRs? Wie alt?
- Das CI-Signal prüfen. Sind die letzten Trunk-Läufe grün?
Dazu eine siebte in der Monitoring-Schleife:
- Den Spielraum beim Ratenlimit prüfen. Wie viel des aktuellen Abrechnungsfensters ist verbraucht? Wie hoch ist die Verbrauchsrate?
Nach den Prüfungen wendet jede Schleife ihre Reaktionsregeln in einer begründungsgestützten Prioritätsreihenfolge an: Erreichbarkeit vor Korrektheit, Deploy-Gate vor Inhalt, Master-CI vor Backlog, Backlog vor neuer Arbeit, Plattformmetrik vor Doktrin.
Das klingt bürokratisch. Es ist das Gegenteil: Es nimmt dem Agenten die Freiheit, schlecht zu wählen. Eine Schleife, die vor „Deploy-Gate verweigert, vier PRs ungeprüft, CI rot, Backlog wächst, schwächster Feature-Bereich auf F“ steht, muss nicht mehr über Prioritäten nachdenken. Das Protokoll entscheidet: erst das Deploy-Gate.
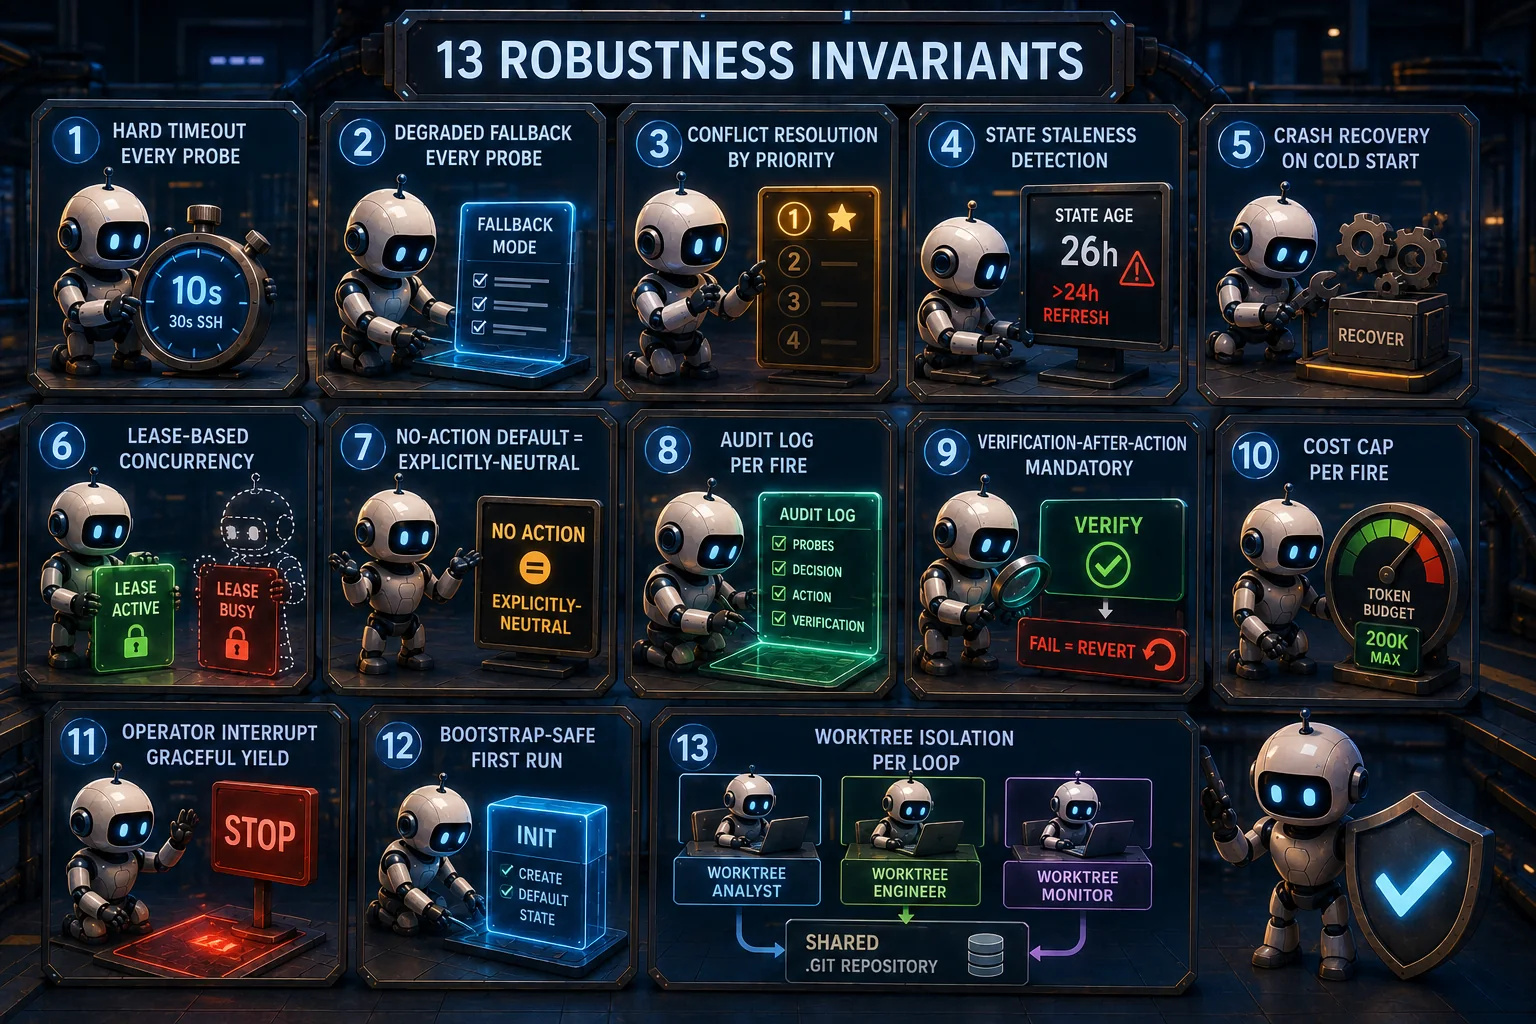
Dreizehn Robustheits-Invarianten
Protokolle zur Zustandsabfrage sind von Haus aus brüchig. Prüfungen laufen in Timeouts, Dateien fehlen, Netzwerke fallen aus. Deshalb:
- I-1. Jede Prüfung hat ein hartes Timeout (standardmäßig 10 Sekunden, 30 Sekunden für SSH).
- I-2. Jede Prüfung hat eine eingeschränkte Rückfalloption (das Scheitern einer Prüfung bedeutet nicht das Scheitern des Laufs).
- I-3. Konflikte werden nach begründungsgestützter Priorität gelöst, nicht nach dem ersten Treffer.
- I-4. Erkennung veralteten Zustands (älter als 24 Stunden löst eine frische Neubegehung aus).
- I-5. Absturzwiederherstellung beim Kaltstart (offen gelassene Branches, abgelaufene Sperren, nicht committeter Zustand).
- I-6. Lease-basierte Nebenläufigkeit. Jeder Schleifentyp hält eine eigene Lock-Datei. Zwei gleichzeitige Läufe desselben Schleifentyps können nicht kollidieren.
- I-7. Die Standardvorgabe „keine Aktion“ entspricht ausdrücklich neutral mit Offenlegung. Stille Läufe ohne Wirkung sind unmöglich.
- I-8. Auditlog je Lauf. Prüfergebnisse, Entscheidung, Aktion und Verifikation werden aufgezeichnet.
- I-9. Verifikation nach der Aktion ist Pflicht. Eine gescheiterte Verifikation heißt REVERT, nicht Wiederholung.
- I-10. Kostenobergrenze je Lauf (200.000 Tokens). Ausufernde Schleifen sind begrenzt.
- I-11. Geordnetes Nachgeben bei Operator-Unterbrechung. Eine STOP-Datei mitten im Lauf bedeutet sauberes Beenden, ohne halben Zustand.
- I-12. Bootstrap-sicher. Funktioniert beim allerersten Lauf, wenn es die Zustandsdateien noch nicht gibt.
- I-13. Worktree-Isolation. Jede Schleife arbeitet in einem eigenen Git-Worktree: eigenes Arbeitsverzeichnis, dasselbe gemeinsame
.git-Repository. Ohne das kollidieren zwei Schleifen mit gemeinsamem Arbeitsverzeichnis bei jedem Checkout und Pull. Lernen Sie diese Lektion nicht auf die harte Tour; richten Sie es von Anfang an ein.
I-13 habe ich nach dieser Sitzung ergänzt. Die anderen zwölf hatte ich richtig. Das Kollisionsmuster, das I-13 verhindert, ist im Abschnitt „Was dieses Muster dennoch bricht“ weiter unten beschrieben.
Die Matrix aus Modell und Denkmodus
Moderne Plattformen für Coding-Agenten lassen Sie die Modellgröße UND den Denkmodus wählen (normal oder erweitertes Denken mit explizitem Reasoning-Budget). Zwischen dem günstigsten und dem teuersten liegt etwa der Faktor 60. Wenn jede Tätigkeit standardmäßig „das klügste Modell mit dem tiefsten Denken“ nimmt, verbrennt man Geld für Routinearbeit, der Tiefe nichts bringt.
Die Zuordnung von Tätigkeit zu Modell:
- Routine-Bot-Review eines PR: kleineres Modell, normales Denken. Muster gegen Regeln abgleichen; kein neuartiges Schlussfolgern nötig.
- Code-Review einer umfangreichen Änderung: größtes Modell, erweitertes Denken (16k+ Tokens). Subtile Korrektheit braucht Tiefe.
- Kaltstart-Zustandsprüfung: kleineres Modell, normales Denken. Mechanisch; Tiefe wäre verschwendet.
- Synthese über mehrere Quellen wie Drift-Erkennung: kleineres Modell, erweitertes Denken (~8k Tokens). Der Vergleich mehrerer Quellen profitiert von etwas mehr Überlegung.
- Ursachenanalyse bei stockender Konvergenz: größtes Modell, erweitertes Denken (16k Tokens). Fehler auf Systemebene diagnostizieren.
- Architekturentscheidung, die sich verfestigt: größtes Modell, erweitertes Denken (16k+ Tokens). Falsche Architektur kostet Wochen; für Tiefe zahlen.
- Routine-Debugging mit bekannten Mustern: kleineres Modell, normales Denken. Nachschlage-Charakter.
- Neuartiges Debugging jenseits von 30 Minuten: größtes Modell, erweitertes Denken (16k+ Tokens). Tiefe zahlt sich aus.
- Sicherheitsaudit: größtes Modell, erweitertes Denken (16k+ Tokens). Subtile Bedrohungsmodell-Überlegungen.
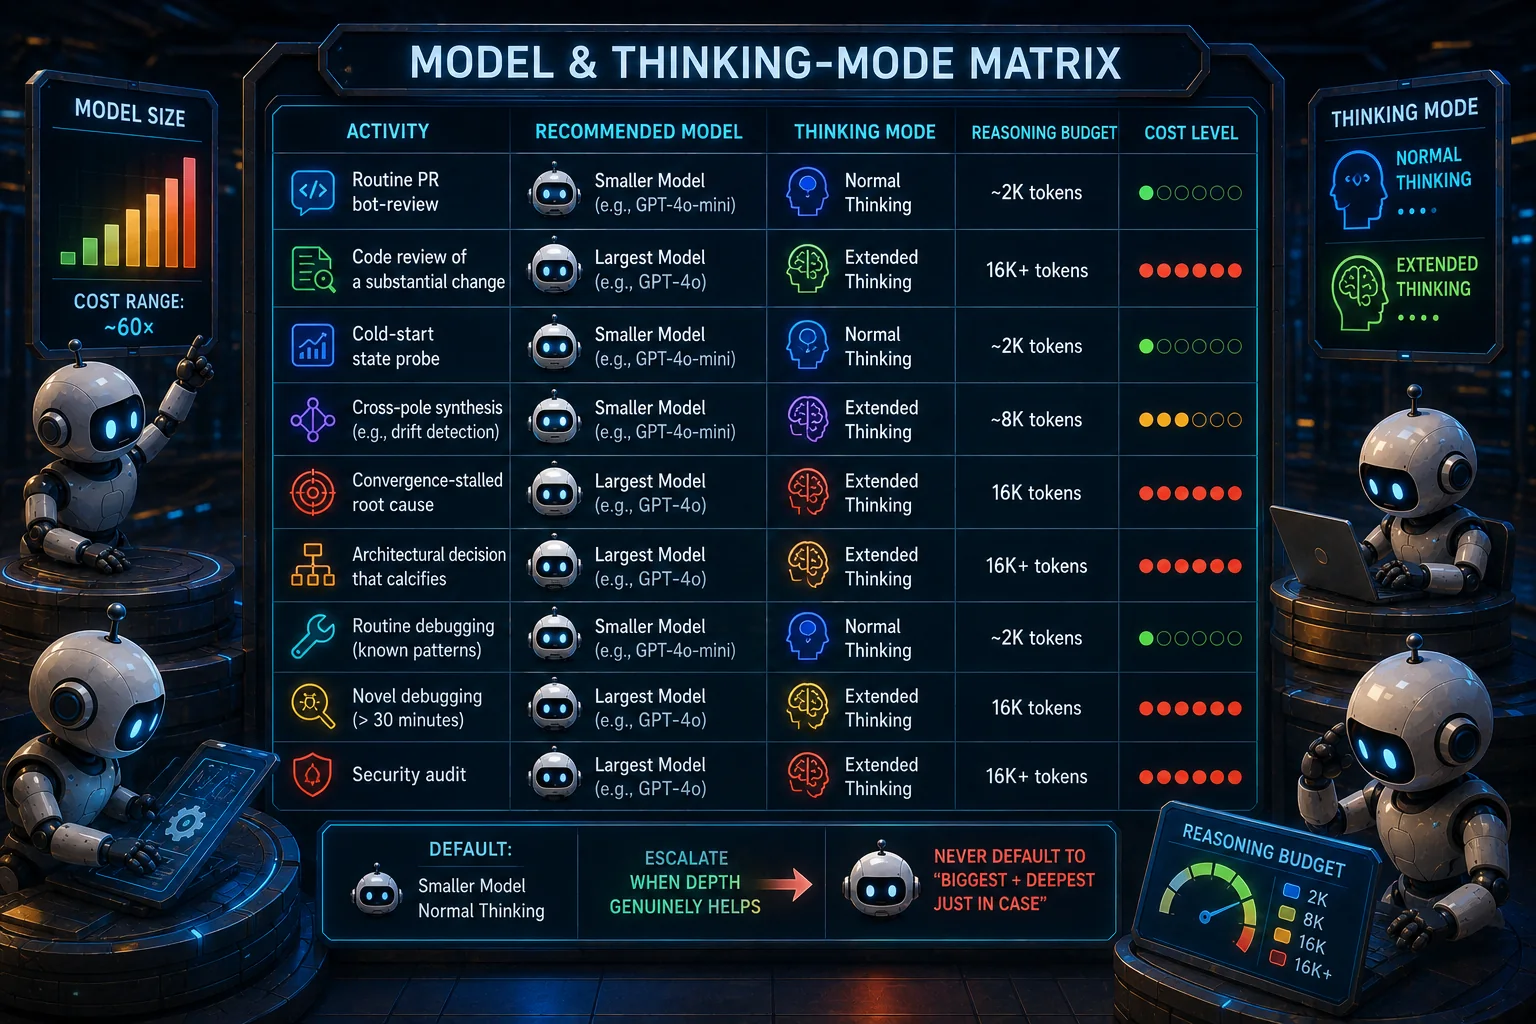
Standard: kleineres Modell + normales Denken. Hochschalten, wenn Tiefe wirklich hilft. Nie standardmäßig auf „das Größte + das Tiefste zur Sicherheit“ gehen; der größte Kostenposten in jedem Agentensystem sind Subagenten, die das Modell des Elternagenten erben, obwohl sie auf etwas Günstigeres umstellen sollten.
Die Grenze zwischen Agent und Operator
Die wichtigste Regel: Agenten schieben Arbeit nicht stillschweigend auf den menschlichen Operator ab.
Wenn ein autonomes Coding-System etwas nicht kann, etwa Fachexpertise, Marktpositionierung, Tests mit echten Nutzern oder Geschäftsmodell-Entscheidungen, besteht die Versuchung, in die Doku „Der Operator sollte ...“ zu schreiben. Das ist nicht ehrlich. Es lädt die schwersten Teile genau dann ab, wenn der Operator am wenigsten gerüstet ist, sie zu übernehmen (früh im Leben des Produkts, wenn es noch kein MVP gibt).
Was Agenten LIEFERN WERDEN: Feature-Bewertungen von kaputt auf funktionsfähig heben; Design-Feinschliff; Wettbewerbs-Zerlegungen aus öffentlichen Quellen; Integrationstiefe; UX-Tests vor dem Kundenkontakt (über die Nutzerperspektive-Tester-Schleife); Onboarding-Abläufe; Reporting-Funktionen.
Was nur der Operator entscheiden kann: strategische Priorität (welches Feature für den Markt, den er kennt, am wichtigsten ist); Geschäftsmodell; die endgültige ästhetische Präferenz zwischen zwei regelkonformen Entwürfen; ausdrückliche Freigabe einer Umgehung (wenn ein Agent sagt „dieser Test ist flaky, darf ich ihn umgehen?“); Umklassifizierung von Prioritätsstufen.
Tests mit echten Kunden werden ZURÜCKGESTELLT, nicht abgeschoben. Echte Nutzer vor dem MVP heranzuholen, verbrennt Wohlwollen an einem kaputten Produkt. Die Nutzerperspektive-Tester-Schleife ersetzt sie, bis die MVP-Schwelle erreicht ist. Dann kommen echte Nutzer und finden, was der simulierte Tester übersehen hat.
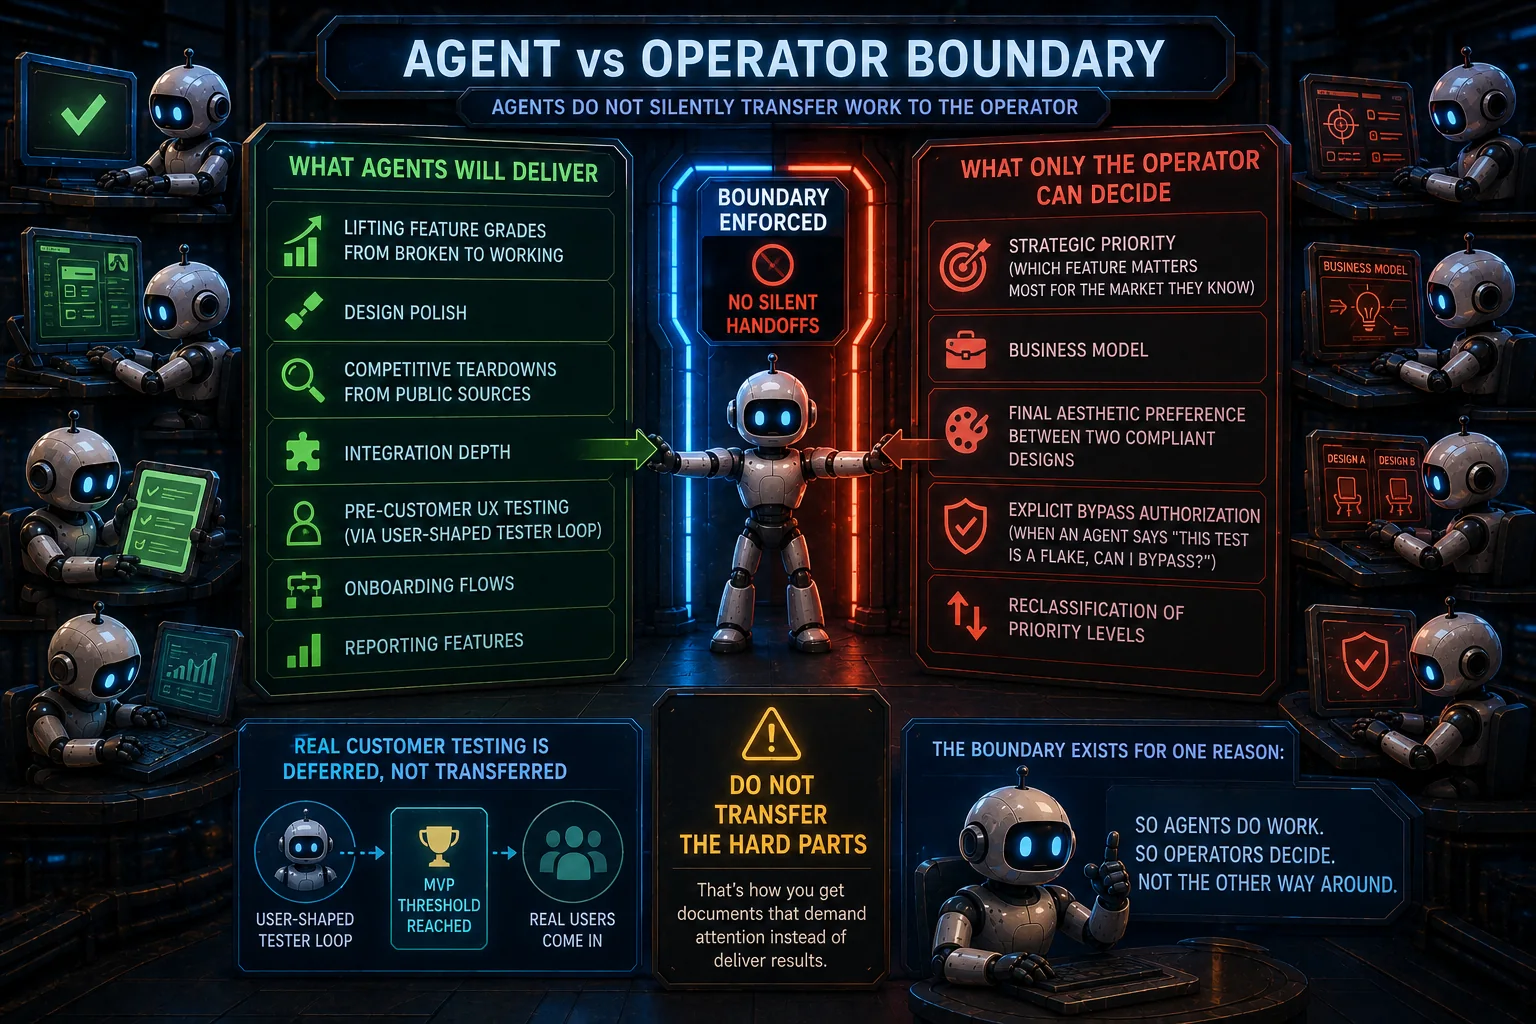
Diese Grenze müssen Operatoren am dringendsten durchsetzen. Ohne sie wird das Agentensystem zu etwas, das Aufmerksamkeit vom Operator verlangt, statt etwas, das Arbeit erledigt.
Die eine kanonische Zustandsdatei
Alle vier Schleifen, alle Disziplinregeln, alle Protokolle sind nutzlos, wenn es keine gemeinsame Definition dafür gibt, „wie der Zustand der Plattform gerade ist“.
Eine Datei. Eine Trendtabelle, an die nur angehängt wird. Jede Zeile ein Schnappschuss zu einem Zeitpunkt. Die Spalten sind die Kennzahlen, die dem Produkt wichtig sind: Feature-Bewertungen je Bereich, Erfolgsquoten, Blocker-Zahlen, Warteschlangentiefen.
Jede Schleife liest diese Datei beim Kaltstart. Konvergente Läufe aktualisieren sie. Driftend-neutrale tun es nicht. Nach ein, zwei Wochen IST der Trend in dieser Datei die Antwort auf die Frage „Erzeugen die Agenten Konvergenz?“.
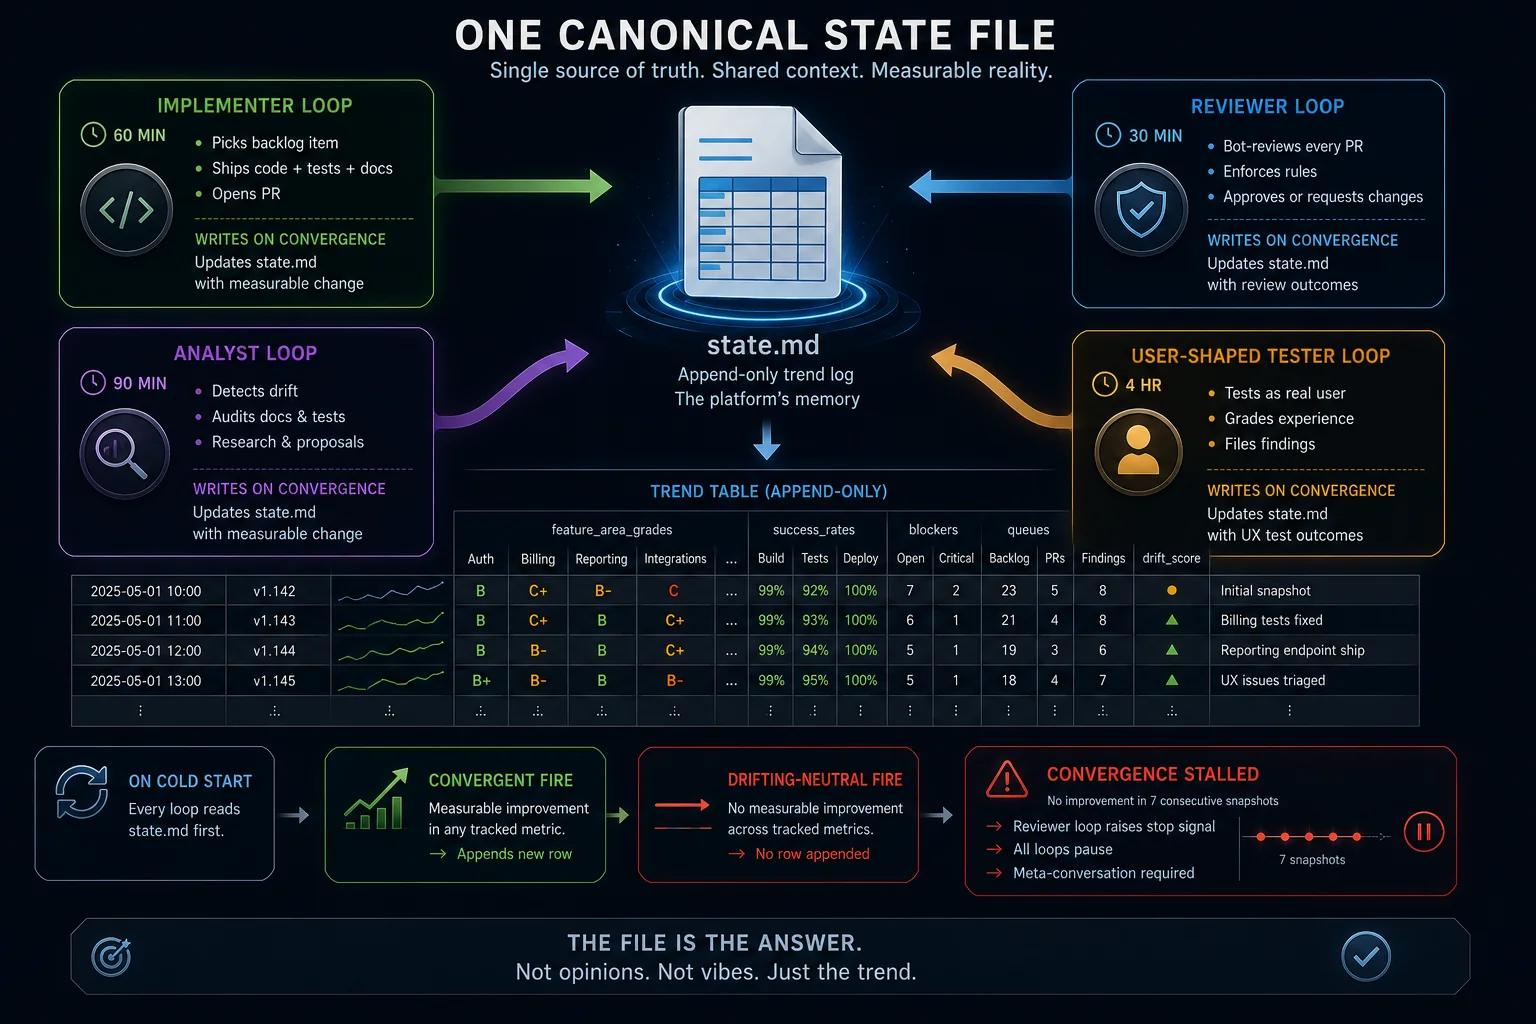
Zeigen 7 aufeinanderfolgende Schnappschüsse keine Bewegung, meldet die Reviewer-Schleife „Konvergenz stockt: Schleifen anhalten, Grundsatzgespräch nötig.“ Die Datei ist das Sicherheitsventil für den Fall, dass jeder einzelne Lauf behauptet, produktiv zu sein, das Ganze aber nicht.
Was dieses Muster dennoch bricht
Diesen Abschnitt hatte der ursprüngliche Entwurf des Artikels nicht. Ihn zu ergänzen hat mich eine Sitzung voller Drift gekostet.
Autoren-Drift
Wer (Mensch oder Agent) eine Regel schreibt, verletzt sie regelmäßig, bevor die Tinte trocken ist. Ich habe eine Disziplin je Artefakt ausgeliefert, die besagte „jedes Artefakt wird als WORKING, READY-TO-WORK oder STUB-WITH-QUEUE ausgeliefert“, und in derselben Sitzung einen Dokumentationsbaum mit 16 hängenden Markdown-Links, die zu keinem dieser Zustände passten. Die Analysten-Schleife hat es innerhalb von Stunden gefangen. Ich war der Autor der Regel, die meinen eigenen Verstoß markierte.
Die Folgerung: Selbstdurchsetzung von Disziplin funktioniert nicht. Die Reviewer- und die Analysten-Schleife sind kein Luxus; sie sind das Einzige, was Autoren-Drift auffängt. Bauen Sie sie zuerst. Die Regeln, die Sie selbst schreiben, binden Sie nicht ohne äußere Durchsetzung.
Kollisionen im gemeinsamen Arbeitsverzeichnis
Wenn Sie alle vier Schleifen aus demselben physischen Verzeichnis betreiben, kollidieren sie bei jeder Git-Operation. Eine Schleife macht git checkout <branch>, und das git status der anderen Schleife meldet plötzlich eine andere Wirklichkeit. Halb gemergte Commits werden der falschen Sitzung zugerechnet. Unversionierte Dateien erscheinen und verschwinden, je nachdem, welchen Branch die zuletzt aktive Schleife ausgecheckt hat.
Die Lösung ist die Invariante I-13 oben: Jede Schleife arbeitet in einem eigenen Git-Worktree. Getrenntes Arbeitsverzeichnis, gemeinsame .git-Datenbank. Der Befehl git worktree add ist eine Zeile und behebt die ganze Fehlerklasse dauerhaft.
Ich habe das gelernt, indem ich wiederholt mit meiner eigenen Analysten-Schleife kollidierte, während ich im selben Verzeichnis eine direkt vom Operator geführte Hauptsitzung betrieb.
Fallstricke beim Starter
Drei Fallen, in die Sie tappen, bevor die Schleifen überhaupt zu laufen beginnen.
- Falle 1: Mehrzeilige Prompts werden abgeschnitten. Die Argumentübergabe von Windows-Prozessen endet am ersten Zeilenumbruch. Ein 3.300 Zeichen langer Auftrag, der als Positionsargument an die Agenten-Binärdatei übergeben wird, kommt dort als die ersten 70 Zeichen an. Nutzen Sie den dateibasierten Eingabe-Schalter (
--append-system-prompt-file <path>oder Entsprechendes) oder übergeben Sie per stdin, also alles, was keine Zeilenumbrüche in argv bringt. - Falle 2: Slash-Befehle gibt es nur in der Oberfläche. Wenn Ihr Auftrag den Agenten anweist, als erste Aktion
/rename "Dev /loop"aufzurufen, kann er das nicht. Slash-Befehle verarbeitet die Benutzeroberfläche, nicht der Agent. Setzen Sie stattdessen den Sitzungsnamen beim Start (die meisten Plattformen haben dafür einen Schalter-noder--name) und verzichten Sie ganz auf die Anweisung. - Falle 3: Die Übergabe nativer Argumente in PowerShell 5.1 ist unzuverlässig. Leerzeichen, Apostrophe und Schrägstriche in Argumentwerten können verstümmelt werden, wenn PS 5.1 sie im Modus
-Filean eine native Exe weiterreicht. Die Diagnose ist eindeutig: Dieselbe Exe von Hand in der interaktiven PowerShell aufzurufen funktioniert; der Aufruf über cmd → powershell -File script.ps1 -Param "value" scheitert. Die Lösung: die PowerShell-Schicht weglassen und cmd die native Exe direkt aufrufen lassen.
Alle drei habe ich in einer Sitzung erlebt. Keine davon ist exotisch; sie sind tragend für jedes Setup mit Windows-Host. Keine davon steht in den README-Dateien der Agentenplattformen. Planen Sie einen Tag ein, um sie zu finden.
Die Kluft zwischen Kosten und Wert
Die Sitzung, aus der dieser Artikel entstand, hat etwa 157 $ an API-äquivalenter Rechenleistung gekostet (das tatsächliche Abonnement ist ein Festpreis; der Dollarbetrag ist das, was dieselbe Arbeit nach Verbrauch kosten würde). Sie brachte neun gemergte Pull Requests mit Doktrin, Infrastruktur und Prozess hervor. Sie brachte null für Nutzer sichtbare Produktverbesserungen hervor. Die Produktkorrektur, die ich früh in der Sitzung eingecheckt hatte, erreichte nie die Produktion, weil das Deploy-Gate verweigerte, wegen 15 fehlschlagender Tests plus der 16 hängenden Markdown-Links, die ich ausgeliefert hatte.
Das ist die Kluft zwischen Kosten und Wert, direkt benannt. Die Disziplin, die ich in diesem Artikel beschreibe, wurde in genau dieser Sitzung aufgebaut. Der messbare Zustand der Plattform hat sich nicht verbessert. Die Infrastruktur, mit der künftige Sitzungen ihn verbessern können, gibt es jetzt, und man sollte sich selbst (und seinem Operator) gegenüber ehrlich sein, wenn man diesen Tausch gemacht hat.
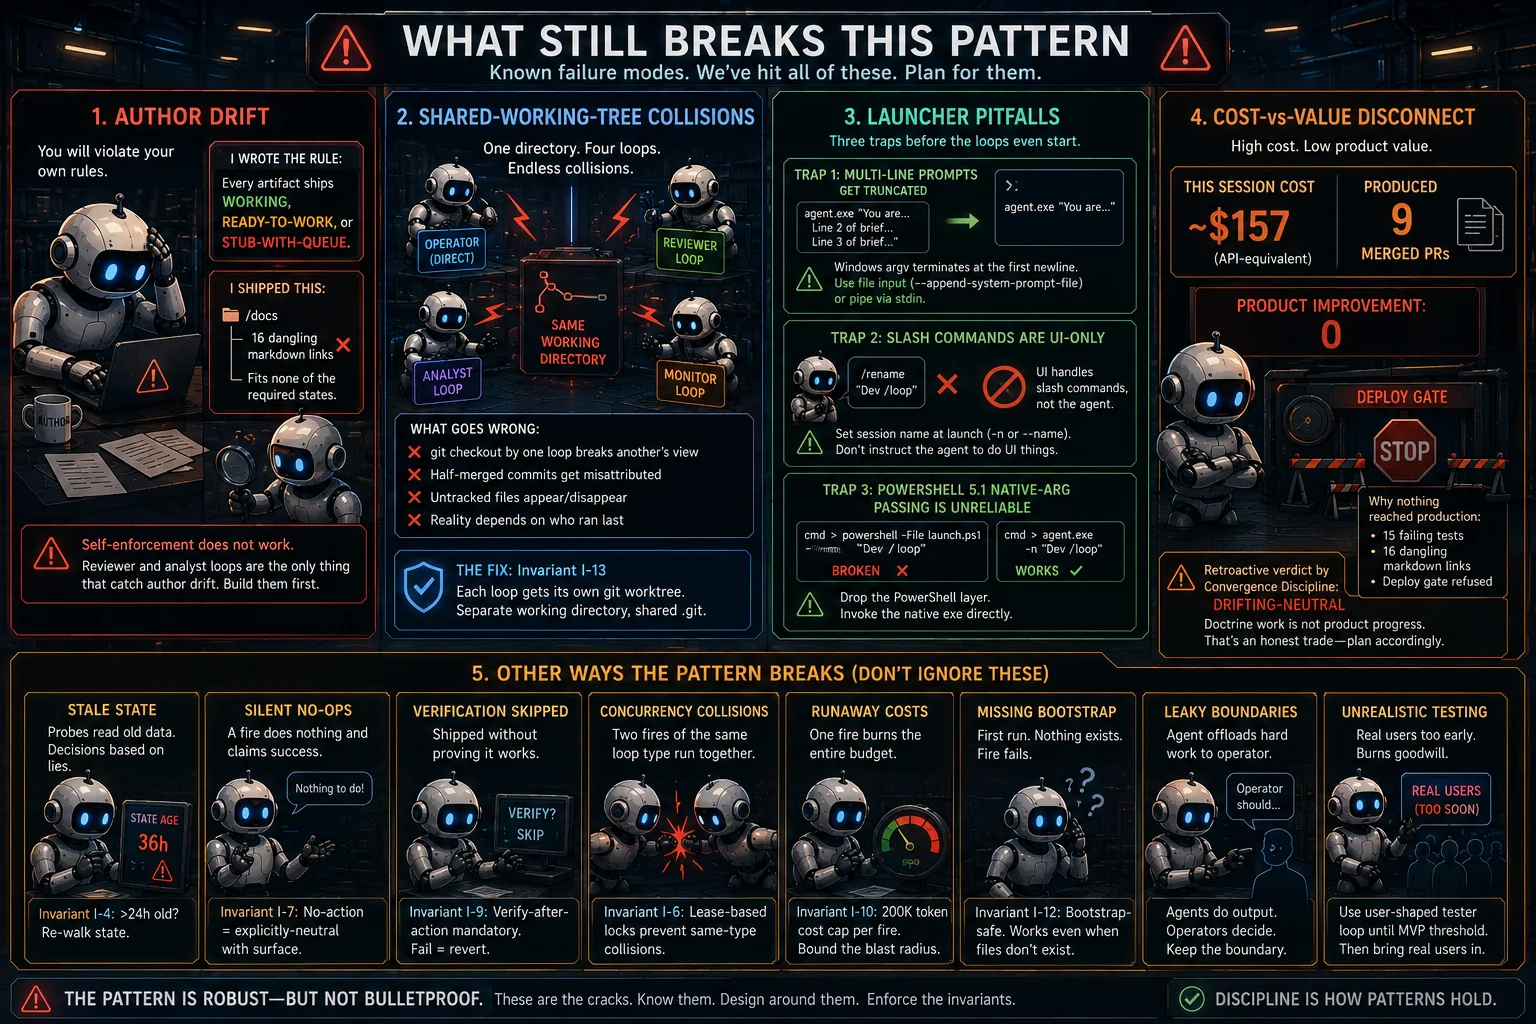
Die Konvergenzdisziplin, rückwirkend angewendet, hätte die gesamte Sitzung als DRIFTING-NEUTRAL markiert. Das ist die Regel, die wie vorgesehen funktioniert. Sie sagt Ihnen auch etwas Unbequemes: Eine Sitzung, die einen Disziplin-Artikel hervorbringen soll, kann kaum zugleich Produktfortschritt liefern, denn jede Minute für Doktrin ist eine Minute, die nicht ins Feature fließt. Planen Sie entsprechend.
Was das NICHT leisten wird
Ehrliche Grenzen dessen, was die Disziplin leisten kann und was nicht:
- Sie hebt jeden Feature-Bereich von kaputt auf funktionsfähig. Die absolute Spitzenbewertung erreicht sie nicht ohne Workflow-Methoden auf Fachebene plus Verifikation von Zustandsänderungen.
- Sie liefert über ein Design-System-Gate eine produktionsreife Ästhetik. Das ästhetische Fundament schafft sie nicht erstmals: Die Designsprache wählt der Operator.
- Sie stellt Wettbewerbs-Zerlegungen zum Feature-Vergleich aus öffentlichen Quellen zusammen. Über die strategische Positionierung gegenüber den Etablierten entscheidet sie nicht, das ist das Marktwissen des Operators.
- Sie führt UX-Tests vor dem Kundenkontakt mit einem simulierten Agenten für unbedarfte Nutzer durch. Echte Schmerzpunkte von Kunden findet sie nicht; echte Nutzer kommen nach dem MVP.
- Sie hält Konvergenz zu bekannten Kosten aufrecht. Vom MVP zum „Besten am Markt“ bringt sie Sie nicht, dafür braucht es Eingaben, die die Schleifen nicht haben.
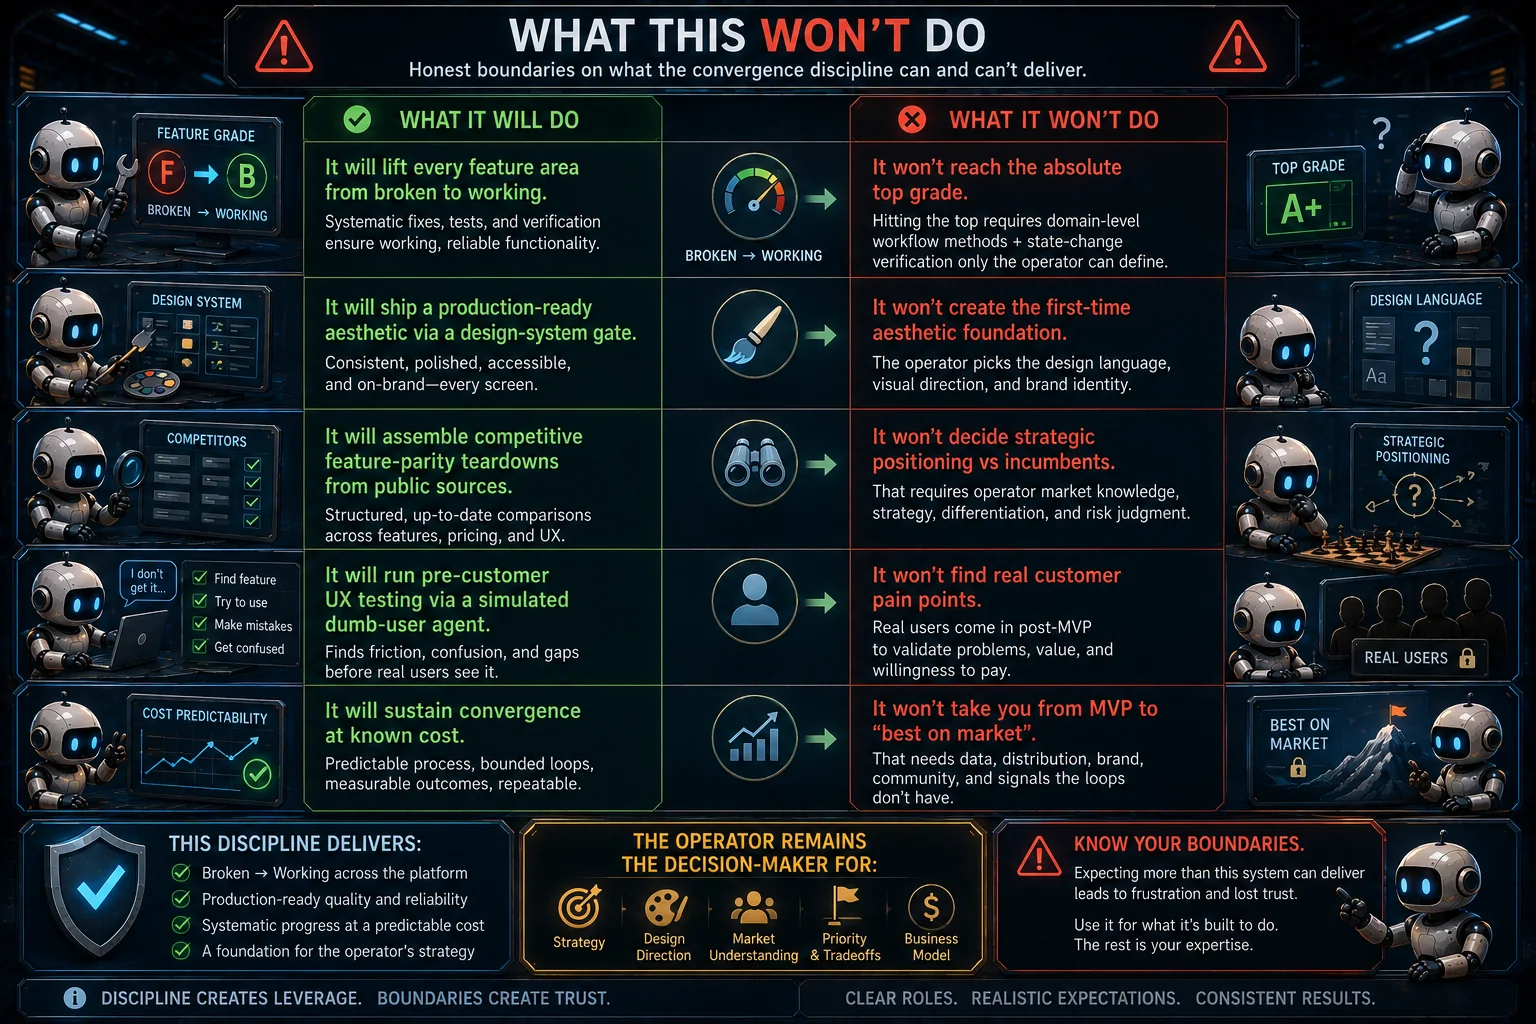
Zur Disziplin gehört, zu benennen, was nicht passieren wird. Ohne das erwarten Operatoren mehr, als das System liefern kann, und verlieren das Vertrauen, wenn es weniger liefert.
Was es kostet
Eine Vier-Schleifen-Sitzung, die 8 Stunden am Tag in einem Takt nach der Matrix läuft, kostet im Monat ungefähr so viel wie das Werkzeugbudget einer einzelnen Engineering-Stelle der mittleren Ebene. Das tatsächliche Abonnement ist ein Festpreis; die Grenze setzen die Ratenlimits je Abrechnungsfenster, nicht die Dollar.
Alles standardmäßig auf das größte Modell mit dem tiefsten Denken? Etwa das 5- bis 7-Fache. Die Disziplin der Matrix ist der Unterschied zwischen nachhaltigem autonomem Engineering und einer ausufernden Rechnung.
Was es je Sitzung kostet, schwankt stärker. Eine Sitzung, die reine Doktrin liefert, wie die, aus der dieser Artikel entstand, verbrennt Budget, ohne das Produkt zu verbessern. Das ist keine Verschwendung, wenn sich die Doktrin in künftigen Sitzungen durch Konvergenz auszahlt, aber es IST Verschwendung, wenn die Doktrin unbeachtet herumliegt.
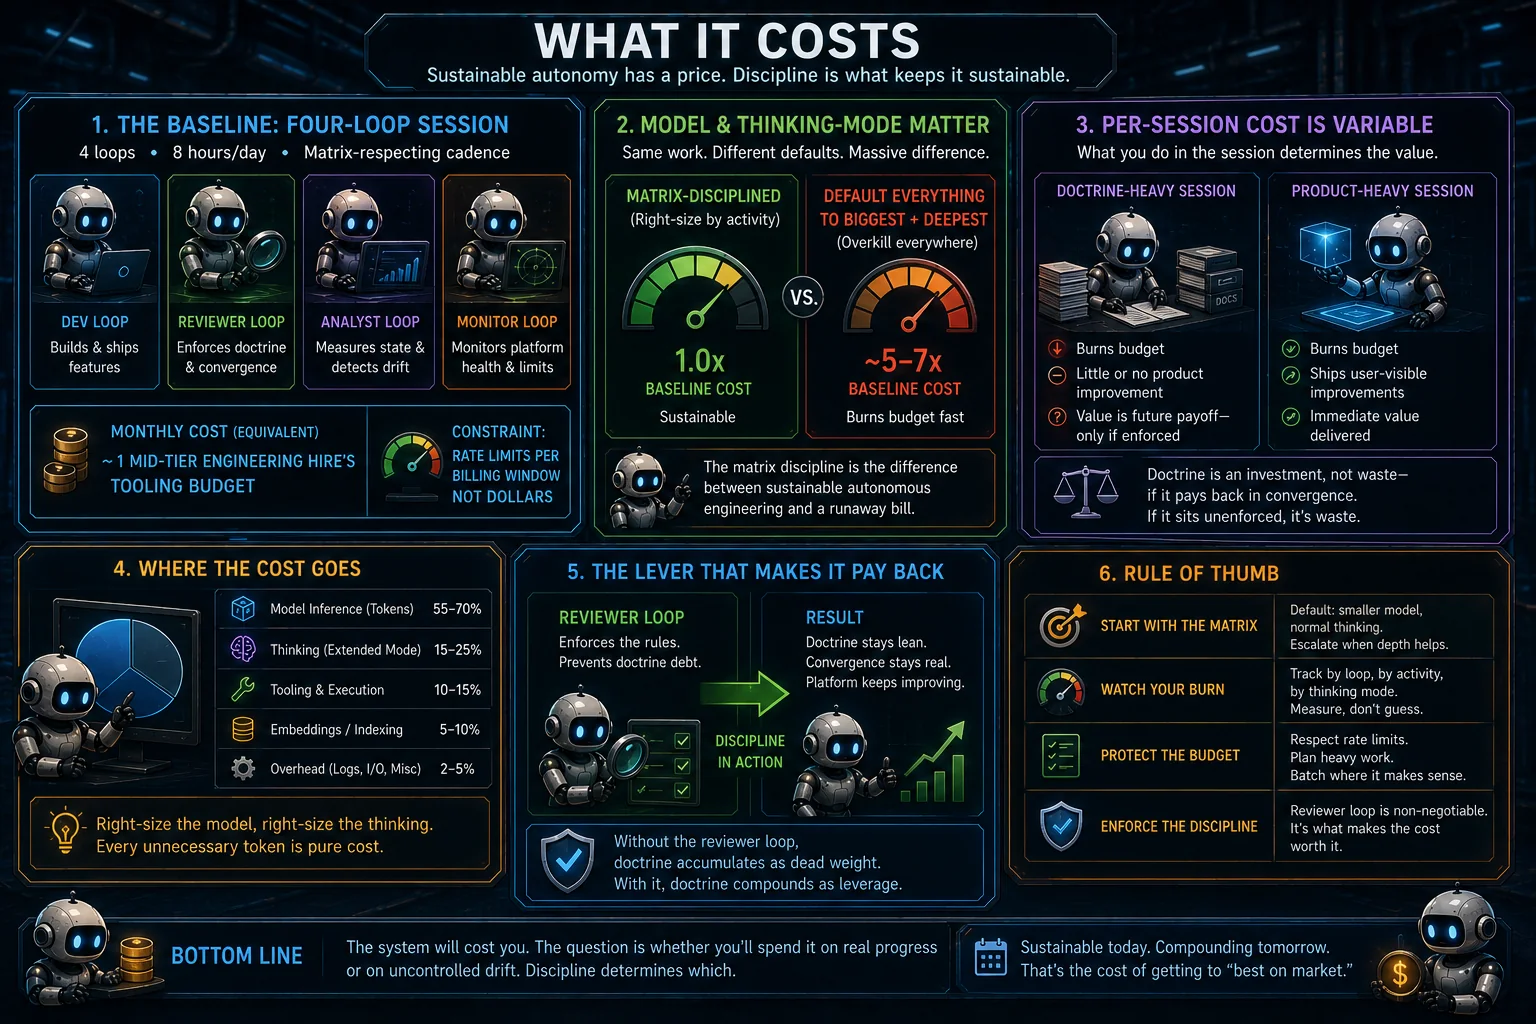
Die Reviewer-Schleife ist es, die Doktrin rentabel macht. Ohne sie sammelt sich Doktrin als totes Gewicht an.
Die Lektion, die ich immer wieder neu lerne
Jedes Mal, wenn ich diesem System eine neue Regel, einen neuen Agenten oder einen neuen Prozess hinzufüge, lade ich der Zukunft Last auf. Die Konvergenzdisziplin ist die einzige Regel, die in der Last netto negativ ist: Sie zwingt jede andere Ergänzung, sich durch messbare Verbesserung selbst zu tragen.
Die Krankheit, die ich zu Beginn dieses Artikels beschrieben habe, „die Agenten sind produktiv, aber das Produkt bewegt sich nicht“, ist ein Versagen der Disziplin, kein Versagen der Werkzeuge. Die Agenten tun genau, was man ihnen sagt: Commits liefern, die CI bestehen, die Doku aktualisieren. Man hat ihnen nur nicht gesagt, dass die Commits eine messbare Achse bewegen müssen.
Sobald man es ihnen sagt, mit ausdrücklichen Regeln je Lauf und je Artefakt, mit einer einzigen kanonischen Zustandsdatei, mit der Aufgabentrennung der vier Schleifen, der ehrlichen Grenze dessen, was nur Menschen können, und Worktree-Isolation, damit sie nicht kollidieren, werden die Agenten nützlich.
Nicht magisch. Nützlich. Manchmal.
Das „Manchmal“ ist das, was der ursprüngliche Entwurf dieses Artikels übersehen hat. Die Disziplin ist das Ziel. Selbst wenn sie aufgeschrieben ist, selbst wenn die Regeln ausdrücklich sind, selbst wenn die Reviewer-Schleife läuft, werden Sie (und Ihre Agenten) driften. Die Drift wird gefangen, dafür ist die Analysten-Schleife da, aber sie wird nicht verhindert. Der Mechanismus korrigiert sich selbst, er beugt sich nicht selbst vor.
Diese Unterscheidung ist wichtig. Die Literatur über KI-Engineering-Werkzeuge ist voll von „magischen“ Versprechen. Die Wirklichkeit ist: eine kleine Menge disziplinierter Muster, streng durchgesetzt von anderen Agenten (nicht durch Selbstdisziplin), die autonome Agenten meistens echte Arbeit leisten lassen, und im Rest der Zeit gefangene und korrigierte Drift. Alles andere ist Theater.
Wenn Sie Coding-Agenten an einer echten Codebasis betreiben und die beschriebenen Fehlformen sehen, können die obigen Muster helfen. Sie sind nicht neu; die meisten kodifizieren, was gute Engineering-Teams ohnehin tun. Neu ist, sie für autonome Schleifen tragend zu machen, in denen kein Mensch unmittelbar im Weg steht, der sie stillschweigend durchsetzt, und die Fehlformen zu benennen, die die Disziplin trotzdem überleben.
Nachtrag. Spickzettel
Diese Seite ist eine vollständige Kopie des auf Medium veröffentlichten Beitrags. Auf Medium lesen. Illustrationen mit KI generiert.