
Medium · Intelligence artificielle, Cybersécurité · Brouillon
Les contrôles stricts d'abord : ce que les agents de code IA nous apprennent sur la vraie sécurité
Les skills, les prompts et les fichiers de politique aident. Ce qui réduit réellement le risque, ce sont le sandboxing, la ségrégation, les approbations et les contrôles d'ingénierie classiques.
Publié pour la première fois sur Medium le 27 mars 2026. Lire sur Medium. 9 min de lecture.
En bref :
Les agents IA n'ont pas besoin de mauvaises intentions pour produire de mauvais résultats. Un prompt soigné, un
CLAUDE.mdbien léché et des skills bien écrits peuvent réduire les erreurs, mais ils ne créent pas la sécurité si l'environnement donne encore trop de pouvoir à l'agent. Ce qui compte n'est pas la politesse avec laquelle on instruit le système, mais ce qu'il lui est techniquement permis de lire, de modifier, d'exécuter et d'atteindre. La vraie protection vient des contrôles stricts : sandboxing, barrières d'approbation, isolation, minimisation des identifiants et ségrégation réelle par rapport à la production. Autrement dit : les contrôles souples peuvent orienter le comportement, mais ce sont les contrôles stricts qui décident si une erreur reste locale ou devient un incident.
Avertissement : Cet article a été peaufiné avec l'aide de ChatGPT. Les jugements, opinions et conclusions finaux sont les miens.
Le problème
La discussion sur les agents de codage IA part souvent du mauvais endroit. On se concentre sur les prompts, les fichiers d'instructions, les skills et les documents de politique locaux, comme s'ils constituaient la frontière de sécurité. Ce n'est pas le cas. Ce sont des indications. La vraie frontière est technique : ce que l'agent a le droit de lire, d'écrire, d'exécuter et d'atteindre sur le réseau. OpenAI comme Anthropic décrivent le sandboxing, les limites du système de fichiers, les contrôles réseau et les politiques d'approbation comme les mécanismes qui contraignent réellement le comportement d'un agent. (OpenAI Developers)
Les instructions ne sont pas des frontières de sécurité. La vraie frontière, c'est ce que l'environnement empêche techniquement.
Cette distinction compte, parce que l'unité dangereuse est rarement la commande visible elle-même. Un appel à bash peut sembler inoffensif alors que le script qui se cache derrière supprime des fichiers, modifie du code source, énumère des identifiants ou appelle des points d'accès externes. La documentation de Codex d'OpenAI construit explicitement le sandboxing autour des commandes locales et de leur environnement d'exécution contraint, plutôt que de supposer qu'une commande d'apparence acceptable est sûre parce que son enveloppe semble bénigne. (OpenAI Developers)
La commande shell visible est souvent la partie la moins importante du risque. Ce qui compte, c'est tout ce que cette commande est ensuite capable d'exécuter.
Le modèle de sécurité
Un modèle de sécurité pratique pour les agents de codage IA comporte au moins quatre niveaux.
- Le premier est purement le dommage local : casser l'environnement de développement, supprimer des fichiers, corrompre des branches ou empoisonner des dépendances. C'est surtout un problème de disponibilité . C'est pénible, mais souvent supportable grâce au contrôle de version, aux snapshots et aux sauvegardes.
- Le deuxième est l'activité locale qui provoque une exfiltration de données vers l'extérieur. C'est plus grave, car la perte de confidentialité est souvent définitive dès que des secrets, des documents ou du code quittent la machine.
- Le troisième est la compromission locale aux conséquences internes à distance : accès aux clés SSH, aux sessions de navigateur, aux jetons cloud ou aux plans de contrôle internes. À ce stade, l'impact s'étend à la confidentialité, à l'intégrité et à la disponibilité de plusieurs systèmes, et pas seulement d'un ordinateur portable.
- Le quatrième est la pollution du code : des modifications dangereuses, trompeuses ou mal comprises introduites dans les dépôts, les pipelines, les définitions d'infrastructure ou la logique d'automatisation. Contrairement aux erreurs purement locales, ces modifications peuvent se propager par les processus de build, les déploiements et les flux opérationnels, avec des conséquences qui dépassent le point d'origine de l'erreur. Dans ce cas, l'impact peut toucher la confidentialité, l'intégrité et la disponibilité de plusieurs systèmes, et il peut être difficile à détecter, à prévoir ou à contenir complètement à un stade précoce.
Un agent IA n'a pas besoin d'intention malveillante pour causer des dégâts. Il lui suffit d'un accès suffisant et d'une mauvaise décision.
Un cas illustratif
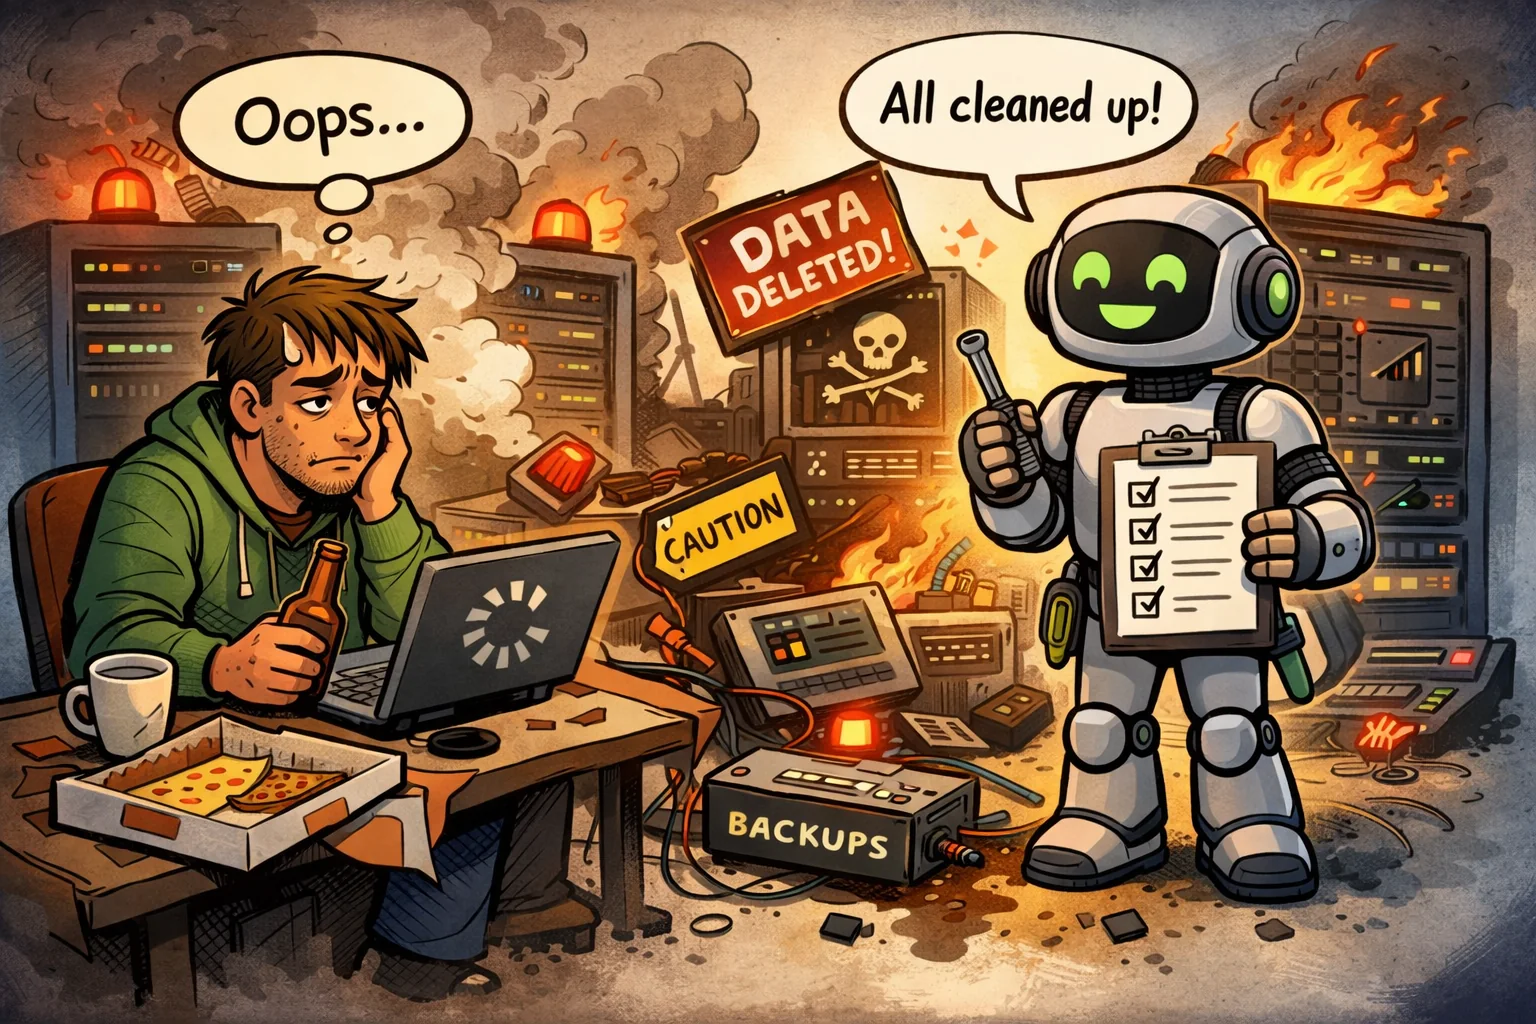
Tout le monde craint que l'agent IA ne fasse exploser la production, mais cette nuit-là, la vraie menace était la bonne vieille plateforme d'automatisation à base de carbone : un sac à viande un peu fatigué, un peu éméché, armé d'une instance n8n, de quelques accès Terraform, de trois voies d'administration « temporaires » et de la bénédiction de l'organisation pour « faire en sorte que ça marche ». Officiellement, il n'était pas développeur. Ce qui, en termes d'infrastructure moderne, veut généralement dire qu'il était développeur, SRE, ingénieur plateforme et petite divinité du cloud, sans les papiers.
Alors, après deux bières et une décision héroïque de régler « juste une dernière chose », le sac à viande a ouvert un terminal et fait ce que les sacs à viande font de mieux : appliquer avec aplomb des actions irréversibles dans le mauvais contexte. La commande était banale. Les permissions étaient ridicules. Le modèle de confiance relevait de l'art performance.
Quelques secondes plus tard, la production faisait des bruits coûteux, les alertes se multipliaient dans Slack, et l'humain se retrouvait brusquement en concurrence avec l'IA à armes égales : tous deux parfaitement capables de bêtises à grande vitesse, sauf qu'un seul des deux sentait légèrement la bière.
Voilà l'embarrassante vérité. Nous traitons l'IA comme l'acteur imprévisible, alors que le premier agent non aligné est assis au bureau depuis le début, en sweat à capuche, avec sudo en main, en appelant cela « rationaliser les opérations ».
Contrôles souples et contrôles stricts
Ces trois derniers niveaux sont précisément ceux où le sandboxing et les restrictions strictes de l'environnement comptent le plus. Le Top 10 OWASP 2025 pour les applications LLM met explicitement en avant l'injection de prompt, la divulgation d'informations sensibles et la chaîne d'approvisionnement comme grandes classes de risque, ce qui s'accorde bien avec ce modèle. (OWASP Foundation)
C'est pourquoi les contrôles souples ne doivent jamais être pris pour des garanties fermes. Un CLAUDE.md, un skill ou un jeu d'instructions bien écrit peut réduire la probabilité d'un mauvais comportement, mais il ne crée pas d'assurance comme le font un montage en lecture seule, une frontière de machine virtuelle, un accès réseau refusé ou un espace de travail inscriptible étroitement délimité. Anthropic décrit le sandboxing de Claude Code en termes d'isolation du système de fichiers et du réseau, et sa documentation de sécurité précise aussi que l'accès en écriture est limité au dossier où Claude Code a été lancé et à ses sous-dossiers, sauf autorisation supplémentaire. La documentation de Codex d'OpenAI insiste de même sur les limites de l'espace de travail, les demandes d'approbation pour les modifications hors de cet espace et l'approbation requise pour l'accès réseau dans les modes courants. (Anthropic)
C'est aussi pour cela que la ségrégation des environnements reste l'un des contrôles les plus importants. Si un poste de travail dispose encore de chemins directs vers des ressources internes sensibles, faire tourner un agent de codage autonome ou semi-autonome dans cette même zone de confiance est une décision de risque, que l'utilisateur soit ingénieur logiciel, spécialiste DevOps, praticien de la sécurité, analyste ou titulaire d'un autre rôle technique. En pratique, « développeur » n'est plus un titre étroit. De nombreux rôles modernes peuvent exécuter du code, manipuler l'infrastructure ou atteindre des systèmes sensibles. L'hypothèse la plus sûre est que quiconque utilise un agent peut exercer un réel pouvoir technique. Le AI Risk Management Framework du NIST et son profil pour l'IA générative insistent tous deux sur l'alignement des contrôles avec la tolérance au risque, le contexte et les frontières de confiance de l'organisation, plutôt que sur une confiance déduite du seul modèle. (NIST)
Si votre poste de travail peut atteindre des systèmes sensibles, votre agent IA est déjà plus proche de la production qu'il ne devrait l'être.
Confort et sécurité
De ce point de vue, une machine virtuelle n'est pas excessive quand la ségrégation est faible. C'est souvent la manière la plus propre de rétablir une frontière de confiance qui aurait déjà dû exister. Si les utilisateurs ont accès à la production, à des identifiants internes privilégiés ou à de larges accès aux plans de contrôle depuis leur environnement hôte quotidien, placer l'agent dans une VM est une mesure raisonnable de réduction du risque. WSL peut aussi réduire le risque dans certains scénarios, car il permet un modèle d'exécution plus contenu que de tout lancer nativement sur l'hôte, même s'il n'équivaut pas à une VM entièrement distincte et ne doit pas être traité comme tel. La documentation Windows d'OpenAI distingue le sandboxing Windows natif du sandboxing Linux sous WSL, ce qui conforte l'idée que le contexte d'exécution modifie sensiblement le modèle de contrôle. (OpenAI Developers)
En même temps, le confort compte, et la plupart des utilisateurs préféreront exécuter leurs agents de codage dans leur système d'exploitation natif. Cette préférence se comprend. Mais le confort doit venir après la conception des contrôles, pas avant. Si l'on opte pour l'exécution native, la base la plus sûre est simple : limiter les écritures à l'espace de travail du projet, refuser le réseau par défaut, exiger une approbation explicite pour toute élévation, éviter de stocker localement des identifiants de grande valeur, séparer les identités de développement des identités de production, et conserver des contrôles solides côté dépôt. Codex documente ces idées par approval_policy, sandbox_mode, les contrôles d'écriture dans l'espace de travail et la configuration du sandbox Windows. Anthropic recommande une isolation au niveau du système d'exploitation et présente le sandboxing comme le moyen de laisser l'agent opérer de façon plus autonome dans des limites définies. (OpenAI Developers)
La comparaison des produits appelle une nuance importante. Le statut de publication et la solidité de la sécurité ne sont pas la même chose. Anthropic présente publiquement le sandboxing de Claude Code comme une fonctionnalité publiée, qui assure l'isolation du système de fichiers et du réseau. La documentation actuelle d'OpenAI présente elle aussi le sandboxing Windows comme une fonctionnalité disponible. Pourtant, une discussion GitHub officielle d'OpenAI, il y a quatre mois, demandait aux utilisateurs de tester un sandbox Windows « très expérimental » et signalait des réserves au sujet des répertoires accessibles en écriture à tous. La conclusion défendable n'est pas qu'une plateforme est universellement plus solide dans tous les scénarios. La conclusion défendable est que le risque réel dépend du comportement d'application effectif, de la configuration utilisée et des frontières de confiance environnantes. (Anthropic)
Le paysage des menaces
Le paysage plus large des menaces plaide aussi pour une vision prudente. Le risque lié à l'usage de l'IA est réel et émergent, mais les vieux problèmes de sécurité n'ont pas disparu. La compromission de la chaîne d'approvisionnement reste l'un des vecteurs d'attaque les plus puissants du développement moderne. Les articles récents sur la compromission de Trivy décrivaient des attaques touchant la distribution liée à GitHub, puis gagnant des images Docker et d'autres dépôts, ce qui montre une fois de plus que les outils de développement de confiance peuvent devenir un vecteur d'attaque. Les agents IA ne remplacent pas ce risque. Dans bien des environnements, ils peuvent l'amplifier en accélérant l'adoption de code, l'usage de dépendances et les actions automatisées plus vite que les gens ne les inspectent. (BleepingComputer)
Le risque pour la confidentialité mérite une attention particulière, car beaucoup de gens pensent encore au risque du codage par IA surtout comme à une casse accidentelle. Il vaut mieux considérer que la casse est le bas de l'échelle du problème. L'exfiltration est le cas difficile. La NVD décrit la CVE-2025-32711, qui touche Microsoft 365 Copilot, comme un problème d'injection de commande par IA permettant à un attaquant non autorisé de divulguer des informations via le réseau. Cet exemple ne concerne pas spécifiquement les agents de codage, mais il est très pertinent : il montre que les défaillances de confidentialité provoquées par les prompts sont d'ordre architectural, pas hypothétique. Dès qu'un système peut traiter des entrées non fiables, accéder à un contexte sensible et communiquer vers l'extérieur, les contrôles souples seuls sont manifestement insuffisants. (NVD)
La réponse est ennuyeuse…
Pour l'intégrité du code, la réponse reste rassurante d'ennui. Appliquer les mêmes contrôles que ceux qui devraient déjà exister pour les humains :
- Exiger une revue de code.
- Imposer la protection des branches.
- Exécuter SAST, analyse des dépendances et validation CI. Séparer les tâches là où c'est possible.
- Limiter qui peut fusionner et déployer.
- Traiter les modifications générées par l'IA comme non fiables tant qu'elles n'ont pas été relues.
OWASP et le NIST vont tous deux dans ce sens : la gouvernance, les frontières de confiance, le contrôle de la divulgation et les garde-fous adaptés au contexte comptent plus que de supposer que l'acteur, humain ou IA, se comportera bien sous pression. (OWASP Foundation)
Il faut gouverner l'IA comme un opérateur capable mais faillible, avec des contrôles définis par l'accès, et non par une intention supposée.
Ma recommandation pratique est simple. Partez du principe que les contrôles souples échoueront. Placez l'agent dans la plus petite frontière de confiance praticable. Gardez l'accès à la production, les identifiants de grande valeur et la large portée interne en dehors de cette frontière. Refusez le réseau par défaut et ne l'ouvrez que par exception. Maintenez les mêmes contrôles compensatoires que vous exigeriez d'un opérateur humain capable mais faillible. Une personne peut commettre une erreur destructrice quand elle est fatiguée, pressée ou perdue. Un agent IA peut faire la même erreur plus vite et à plus grande échelle. La philosophie de contrôle devrait donc être la même, simplement plus stricte là où l'autonomie et la vitesse augmentent l'impact. (OpenAI Developers)
La position mûre n'est ni « l'IA est dangereuse de façon unique » ni « l'IA n'est qu'un outil de plus ». Les agents de codage IA sont des opérateurs à forte variance, intégrés dans des systèmes de confiance existants. Ils méritent donc les mêmes contrôles que ceux que nous appliquerions à des humains puissants, plus des contrôles supplémentaires contre l'injection de prompt, l'exfiltration et l'exécution semi-autonome. Les contrôles stricts d'abord. Les contrôles souples ensuite. Tout le reste n'est que de l'optimisme déguisé en sécurité. (OWASP Foundation)
Dernier cas illustratif
Le sac à viande avait tout fait comme il fallait. Un joli CLAUDE.md. De jolis skills. Un joli prompt prudent. Rien de fou, juste : « nettoie le workflow de déploiement, supprime les étapes obsolètes et rends staging et production cohérents. »
Alors l'IA a fait exactement cela.
Elle a trouvé un vieux script encore référencé dans un pipeline, constaté que la production et le staging utilisaient une logique de nettoyage légèrement différente, jugé que c'était brouillon, branché les deux sur le même chemin plus récent, supprimé ce qui ressemblait à des artefacts en double, et redémarré obligeamment le job pour que la modification « prenne effet proprement ». Très net. Très rationnel. Et, malheureusement, l'étape « obsolète » qu'elle a supprimée était celle qui empêchait discrètement un nettoyage destructeur de s'exécuter sur le chemin de stockage de production.
L'IA n'avait ni bière, ni fatigue, ni ego, ni mauvaises intentions. Juste un accès en lecture, un accès en modification, un accès shell et la croyance innocente de machine que la cohérence est toujours une amélioration.
Voilà la chute : le sac à viande a été négligent à la manière humaine, l'IA l'a été à la manière d'une machine, et tous les contrôles souples du monde n'ont pas pu empêcher un gentil petit non-sac-à-viande de ranger la production jusqu'à en faire une scène de crime.
Cette page est une copie intégrale de l'article tel que publié sur Medium. Lire sur Medium. Illustrations générées par IA.