
Medium · Ingénierie IA, Développement logiciel · Brouillon
Le schéma à quatre boucles : faire tourner des agents de code autonomes sans dérive
Comment garder une ingénierie IA disciplinée quand les agents vont plus vite que vous ne pouvez relire — y compris quand l'auteur de la discipline s'en écarte lui-même.
Publié pour la première fois sur Medium le 12 mai 2026 ; dernière modification le 13 mai 2026. Lire sur Medium. 17 min de lecture.
Comment garder une ingénierie IA disciplinée quand les agents vont plus vite que vous ne pouvez relire — y compris quand l'auteur de la discipline s'en écarte lui-même.
Il s'agit d'un article exploratoire, pas d'une prescription. Sa valeur n'est pas que le modèle à quatre boucles soit déjà éprouvé, mais qu'il donne des mots à un mode de défaillance réel : des agents autonomes peuvent être occupés, justes localement, et pourtant ne pas faire avancer le produit.
Si vous faites tourner des agents de codage sur une vraie base de code depuis plus d'une semaine, vous avez sans doute buté sur le même mur que moi. Les agents sont productifs : ils livrent des commits, passent la CI, mettent la documentation à jour. Le dépôt grossit. Des tests s'ajoutent. De nouveaux mécanismes se construisent.
Et puis vous prenez du recul, vous regardez votre produit, et vous vous rendez compte que rien n'a réellement progressé.
Les agents sont occupés. Le résultat est réel. Mais l'expérience côté utilisateur est à peu près où elle en était il y a un mois. La base de code est plus grosse, la doctrine plus épaisse, la méta-architecture plus élégante — et la fonctionnalité que vous vouliez livrer ne marche toujours pas de bout en bout.
Cet article décrit le modèle auquel je suis parvenu pour faire tourner des agents de codage autonomes de façon à faire réellement avancer le produit. Ce n'est pas une solution miracle. C'est une discipline. Et — point important — c'est une discipline que je me suis surpris à enfreindre plusieurs fois au cours de la même session qui a produit cet article. Cela fait aussi partie du propos : les modes de défaillance qui survivent même une fois les règles écrites.
Le mode de défaillance
Cette pathologie a un nom : les déclenchements à dérive neutre. Un « déclenchement » est une exécution unique d'une boucle d'agent. Un déclenchement à dérive neutre est un déclenchement où l'agent travaille, livre des commits, passe la CI, et ne change rien que l'utilisateur puisse voir ou mesurer.
Variantes courantes :
- L'inflation de doctrine. L'agent écrit un nouveau guide de style, une nouvelle règle d'architecture, une nouvelle convention de nommage. La base de code ne change pas ; la doctrine que devront lire les futurs agents grossit. Au bout de quelques semaines, chaque nouvelle session consacre 20 % de sa fenêtre de contexte à lire des règles qui ne servent directement aucune fonctionnalité.
- La prolifération de squelettes. L'agent livre une « fonctionnalité » — un nouvel écran, un nouveau type d'entité, un nouveau point d'accès d'API. La forme est correcte (le fichier existe, le schéma est valide, la CI est au vert). Le comportement est vide : l'écran n'a pas de données, l'entité n'a pas de méthodes, le point d'accès renvoie une 404 sur des entrées réelles. La surface du produit s'élargit et reste superficielle.
- Un mécanisme sans mesure. L'agent construit un cadre de test, une couche d'observabilité, une barrière de CI. Le cadre tourne. Rien de ce qu'il détecterait ne se déclenche jamais. Sa sortie : une coche verte, à chaque fois, sur un produit qui est cassé.
- Le ballottement de plan. L'agent édite la feuille de route, reclasse les priorités, ajoute de nouveaux éléments au backlog. La feuille de route grossit. Le travail livré à son égard reste mince.
Chacune de ces variantes donne une impression de productivité parce que l'agent livre bel et bien des commits. Le déclenchement est « réussi » au sens trivial : il n'a pas planté, la CI était verte, le diff a été fusionné. Mais l'état mesurable de la plateforme n'a pas changé. Multipliez par 50 déclenchements par semaine et vous obtenez un tapis roulant coûteux.
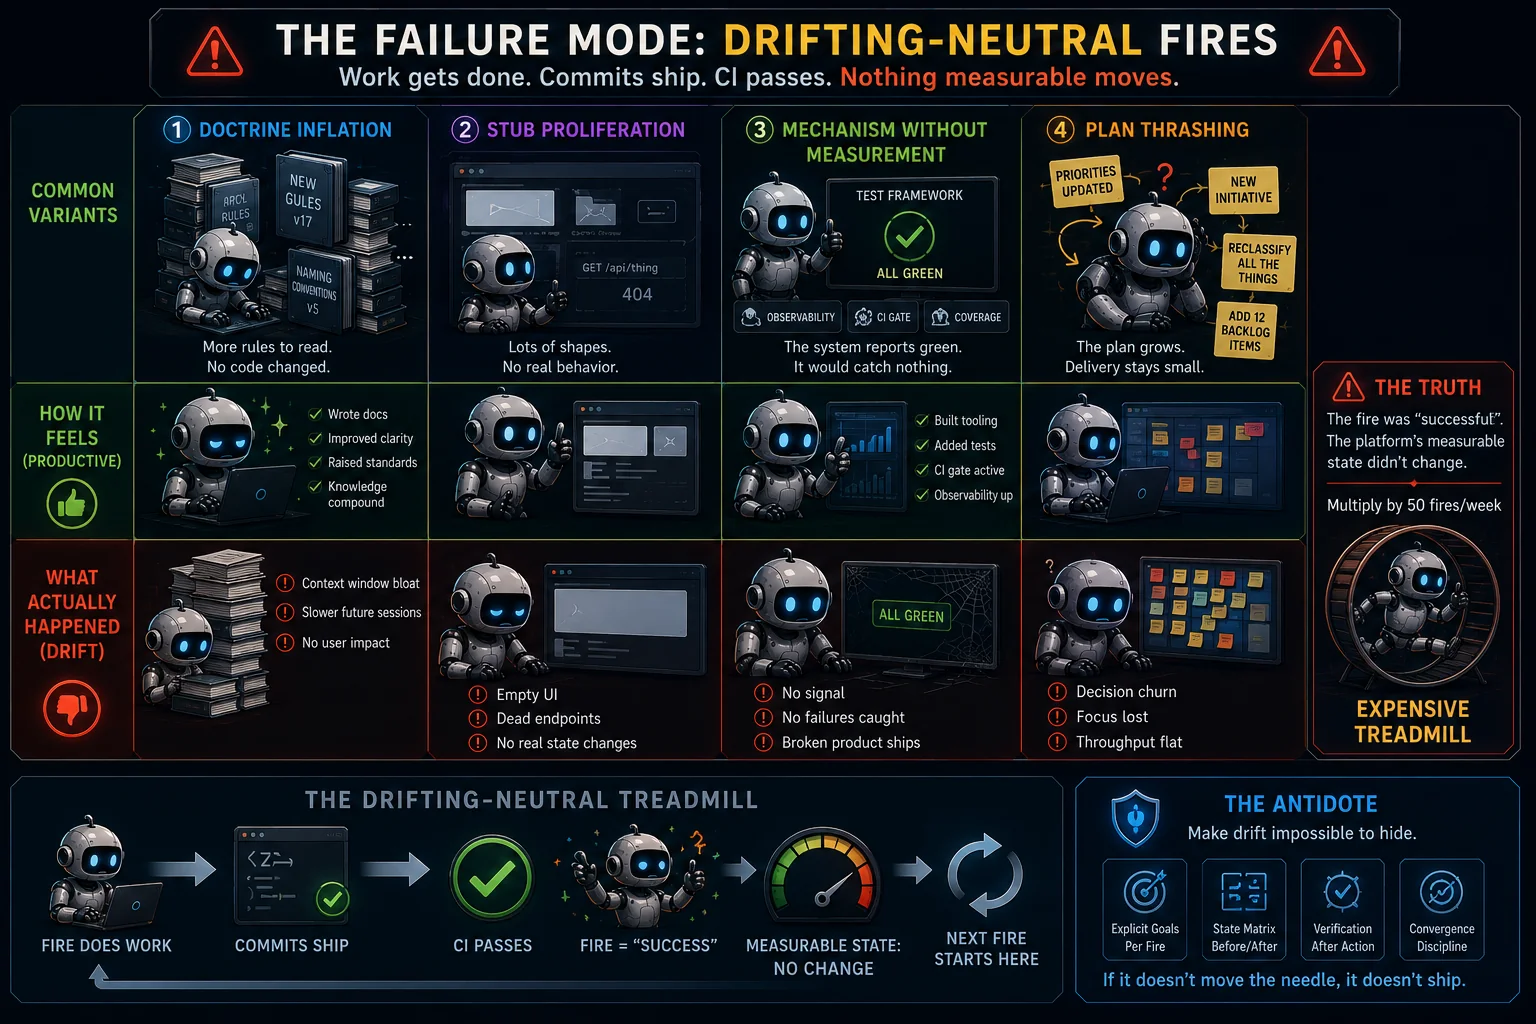
La discipline qui suit existe pour rendre ce mode de défaillance impossible à cacher.
L'architecture à quatre boucles
Refusez le modèle de « l'agent unique ». Une seule boucle qui essaie de tout faire (implémentation, relecture, supervision, tests utilisateur) dérive, parce que les priorités se font concurrence et qu'aucune séparation des responsabilités n'impose de cadre.
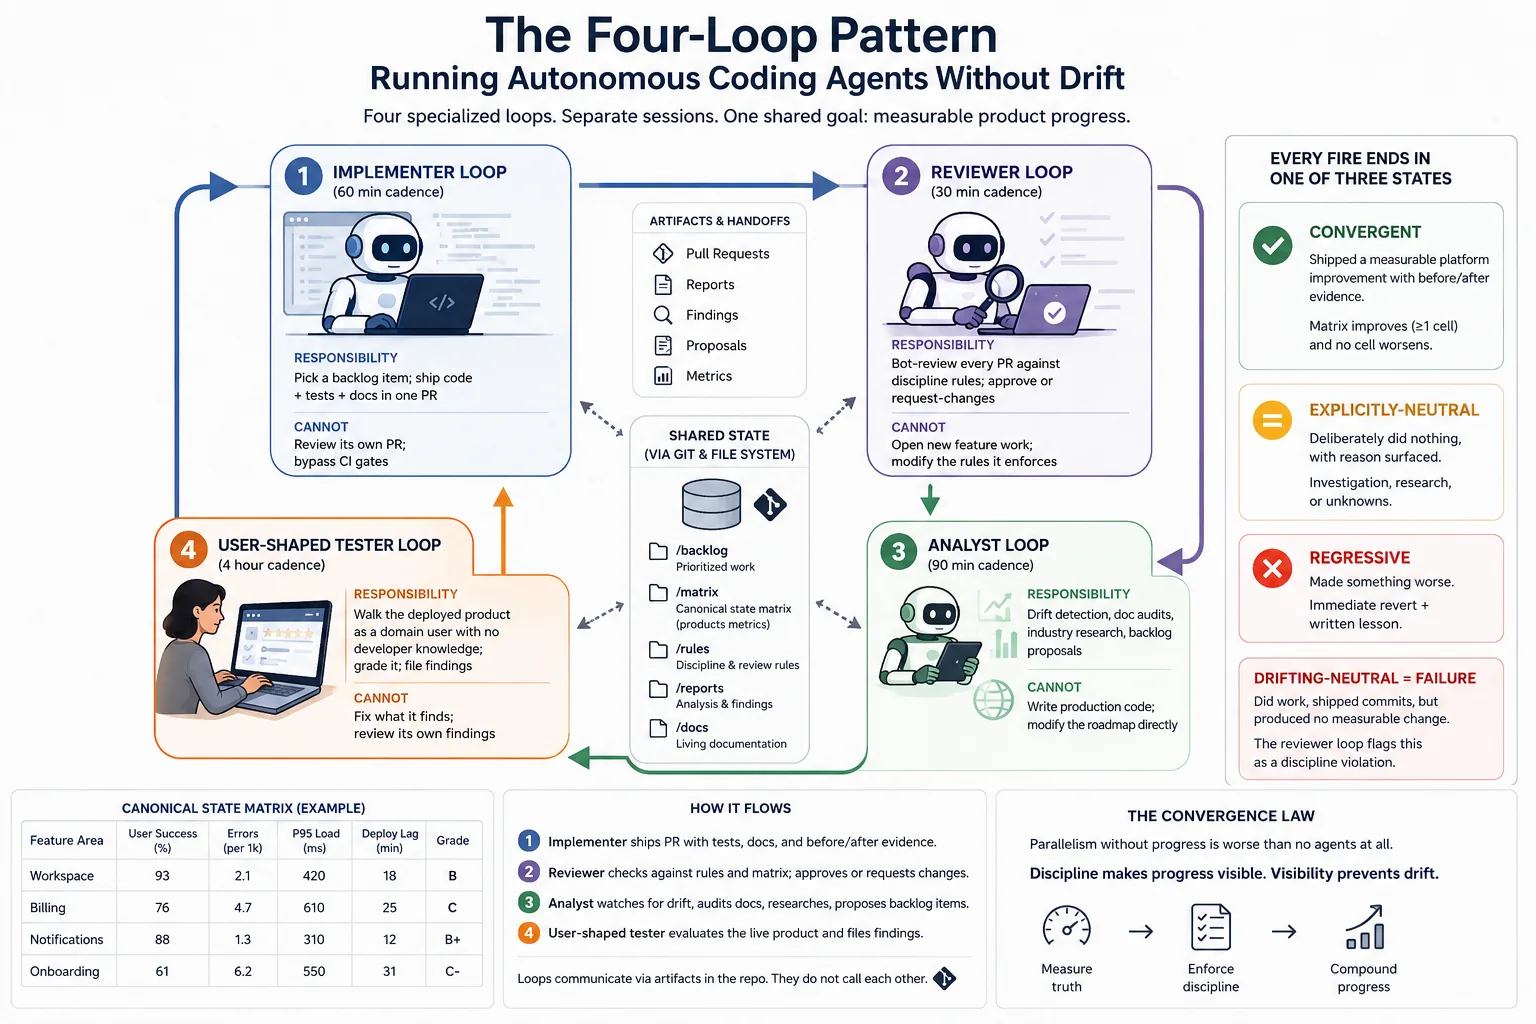
Quatre boucles, chacune avec une responsabilité close :
- Boucle d'implémentation — tourne toutes les 60 minutes. Prend un élément du backlog ; livre code, tests et documentation dans une seule PR. Ne peut pas : relire sa propre PR ; contourner les barrières de CI.
- Boucle de relecture — tourne toutes les 30 minutes. Relit automatiquement chaque PR au regard des règles de discipline ; approuve ou demande des modifications. Ne peut pas : ouvrir un nouveau travail de fonctionnalité ; modifier les règles qu'elle applique.
- Boucle d'analyse — tourne toutes les 90 minutes. Détection de dérive, audits de documentation, veille sectorielle, propositions de backlog. Ne peut pas : écrire du code de production ; modifier directement la feuille de route.
- Boucle de testeur à profil d'utilisateur — tourne toutes les 4 heures. Parcourt le produit déployé comme un utilisateur du domaine sans aucune connaissance de développeur ; le note ; consigne les constats. Ne peut pas : corriger ce qu'elle trouve ; relire ses propres constats.
Chaque boucle tourne dans sa propre session. Elles communiquent par le système de fichiers (git pour l'état partagé ; des fichiers de directives propres à chaque boucle pour les passations). Elles ne s'appellent pas directement.
L'orthogonalité est essentielle. L'implémentation ne peut pas se donner son propre feu vert ; la relecture ne peut pas faire sa propre implémentation ; l'analyse ne peut pas livrer les changements qu'elle propose ; le testeur ne peut pas corriger ce qu'il note. Chaque boucle est contrainte d'utiliser les sorties des autres.
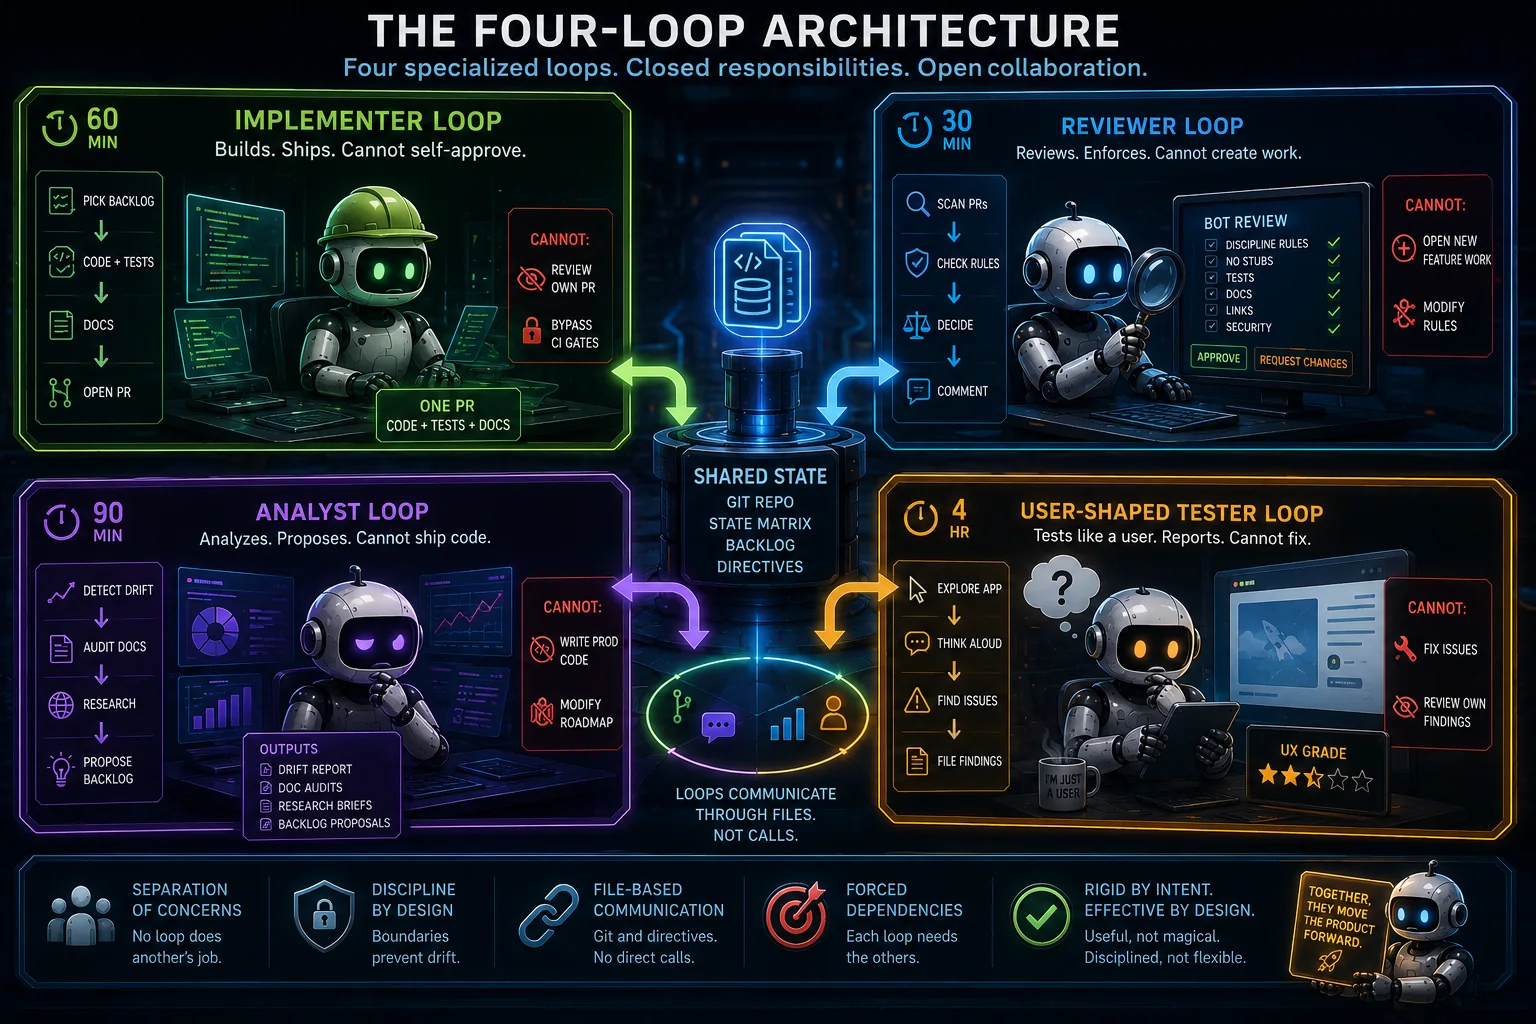
C'est la même séparation que celle d'une équipe d'ingénierie humaine en bonne santé — développeur, relecteur, QA, exploitation — codifiée pour des agents. Les boucles ne sont pas « plus souples » que des humains. Elles sont plus rigides. C'est tout l'intérêt.
La loi de convergence
Le parallélisme sans progrès est pire que l'absence d'agents. Pour obtenir du progrès, une règle stricte :
Chaque déclenchement se termine dans l'un de ces trois états : CONVERGENT (a livré une amélioration mesurable de la plateforme, avec preuves avant/après), EXPLICITEMENT NEUTRE (n'a délibérément rien fait, en indiquant la raison), ou RÉGRESSIF (a dégradé quelque chose — exige un retour arrière immédiat et une leçon écrite). Un déclenchement qui s'est exécuté, a fait des choses, mais n'a produit aucun changement mesurable est une DÉRIVE NEUTRE et constitue un mode de défaillance que la boucle de relecture signale comme une violation de la discipline.
« Mesurable » est le mot qui porte la charge. Il faut une matrice d'état de référence que chaque boucle lit au démarrage à froid : notes par domaine fonctionnel, taux de réussite, profondeur des files, retard de déploiement — quels que soient les axes principaux de votre produit. Un déclenchement est convergent si une case de cette matrice s'est améliorée ET qu'aucune ne s'est dégradée. L'amélioration doit être étayée par des preuves avant/après dans le corps de la PR.
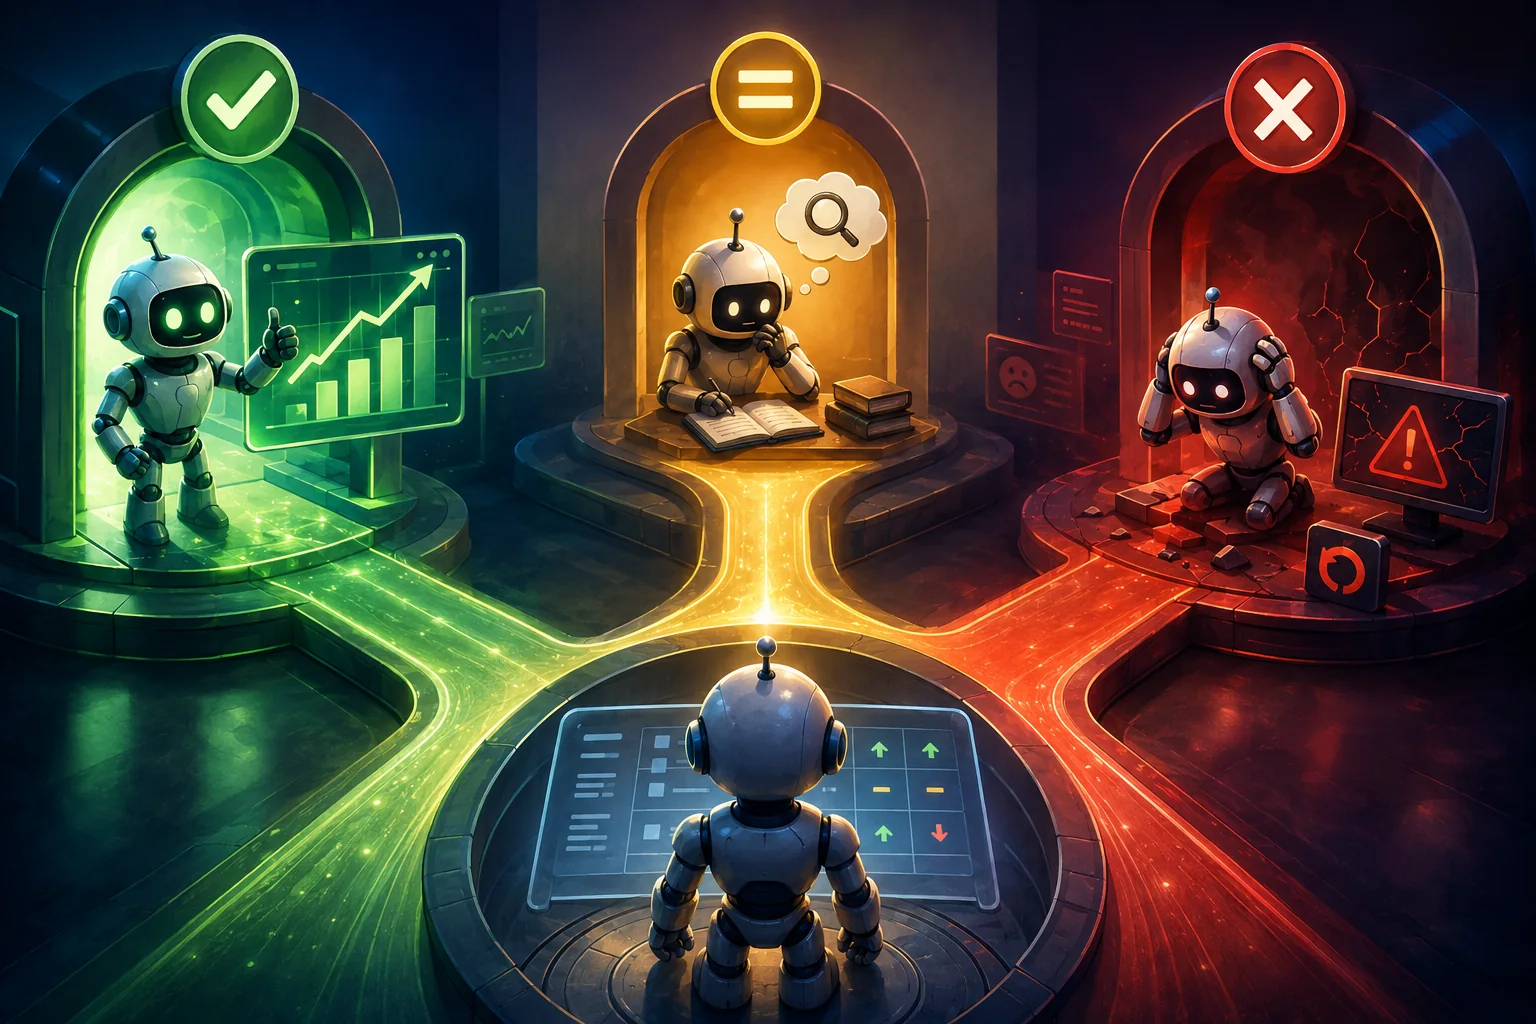
En pratique :
- Exemple convergent. « L'espace de travail X est passé de la note F à la note B (avant : ni liste ni bouton de création ; après : 93 entités visibles et un bouton de création fonctionnel). Capture d'écran avant jointe ; capture d'écran après jointe. Matrice d'état mise à jour. »
- Exemple explicitement neutre. « Investigation seulement — cause racine encore inconnue ; aucun correctif possible pour ce déclenchement. Constats consignés dans analysis/… »
- Exemple régressif. « Tentative de Y ; Z est cassé. Commit ABC annulé. Leçon rédigée. »
La boucle de relecture applique cette règle à chaque PR. Les PR qui n'entrent dans aucun des trois états reçoivent un REQUEST_CHANGES. L'auteur doit soit trouver l'amélioration mesurable, soit reclasser la PR comme neutre avec une raison, soit annuler.
Cette règle seule attrape environ 80 % du problème de dérive. Le reste demande davantage.
La règle du remboursement
Les règles s'accumulent. Chaque nouvelle règle qu'un futur agent doit lire est une taxe sur le budget de contexte de chaque déclenchement à venir. Donc :
Ajouter un nouveau document de doctrine, une nouvelle définition d'agent, un nouvel élément de backlog ou une nouvelle étape de processus EXIGE d'en retirer au moins un existant (le supprimer, le fondre dans un autre ou l'archiver). La complexité nette ne peut pas croître sans l'approbation explicite de l'opérateur. Exception : si le nouvel élément en remplace plusieurs anciens par convergence, c'est net-négatif et acceptable.
C'est la règle que j'enfreins le plus personnellement. Il est difficile de supprimer ce qu'on a écrit. Mais l'alternative est un document de doctrine qui demande 30 minutes de lecture au début de chaque session — ce qui signifie que les agents le survolent, donc ne le suivent pas, donc dérivent.
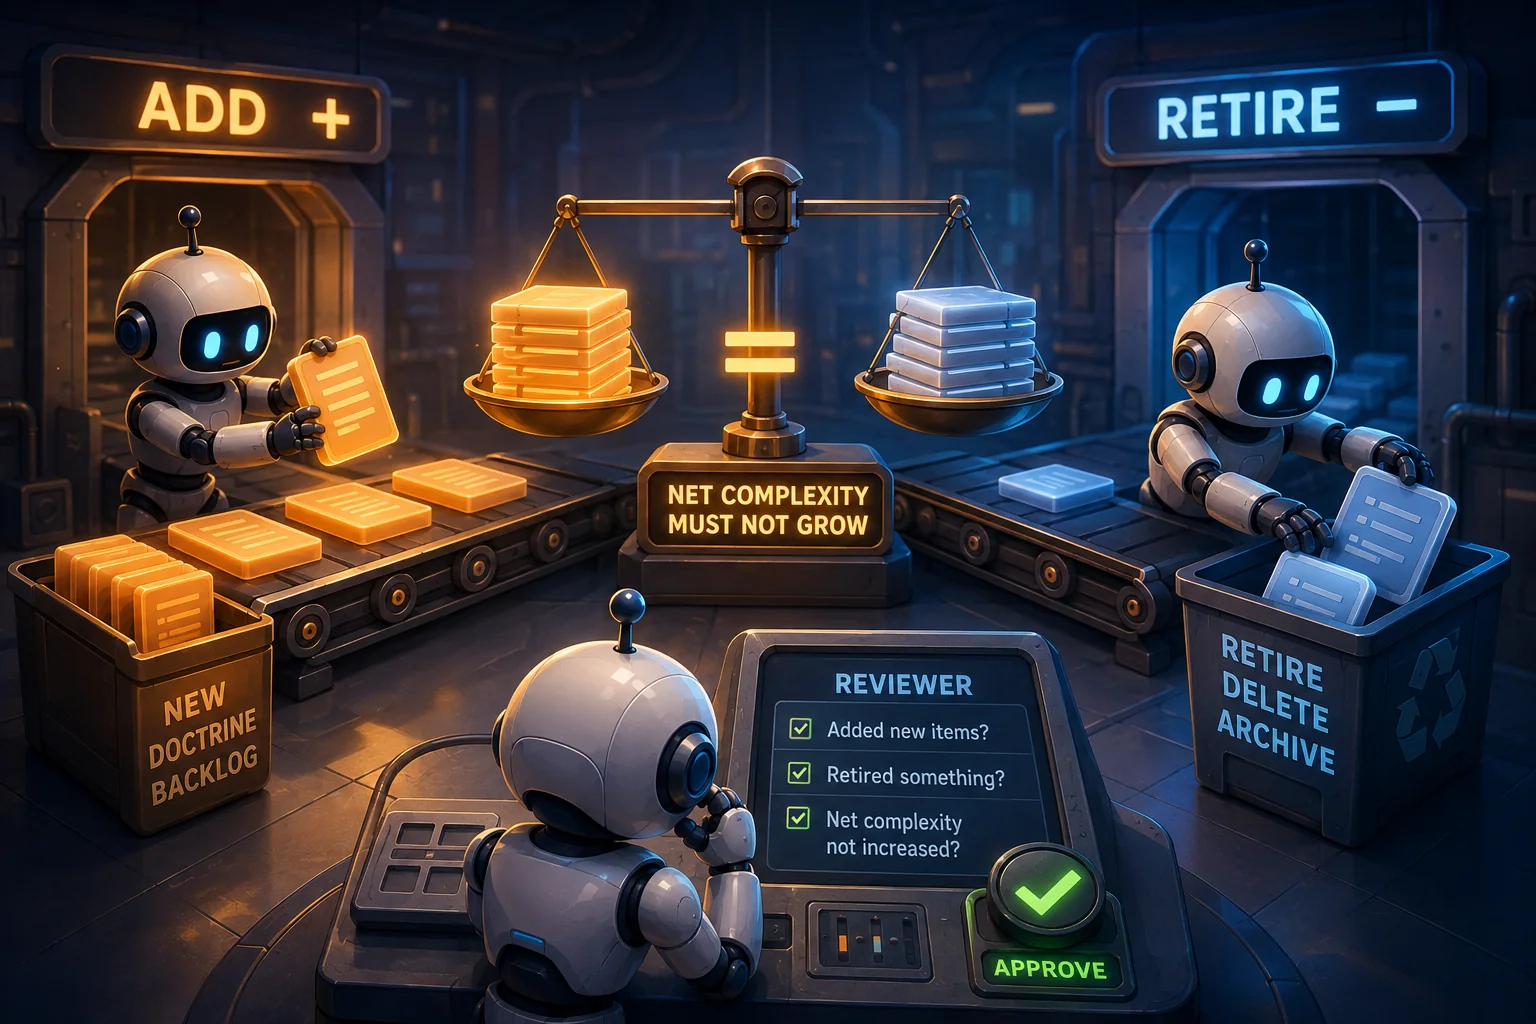
La boucle de relecture vérifie chaque PR : a-t-elle ajouté de nouveaux fichiers de doctrine ou éléments de backlog ? Si oui, a-t-elle aussi retiré quelque chose de poids équivalent ? Sinon, REQUEST_CHANGES avec : « convergence-discipline : cette PR ajoute N nouveaux éléments de doctrine mais en retire 0. Retirez-en un, ou documentez pourquoi cet ajout net est justifié par une amélioration mesurable livrée dans cette PR. »
La règle « pas de squelette livré »
La discipline de convergence attrape la dérive par déclenchement. Elle n'attrape pas la dérive par artefact. Un seul déclenchement peut livrer 10 artefacts dont 3 fonctionnent et 7 sont des squelettes, compter comme « convergent » dans l'ensemble, et faire discrètement grossir le nombre de squelettes de la plateforme.
Règle par artefact :
Chaque artefact que vous livrez — point d'accès, écran, widget, capacité, définition d'agent, section de manuel, n'importe quoi — DOIT être dans l'un de ces trois états : FONCTIONNEL(vérifié de bout en bout par un test, une sortie de smoke test ou une capture d'écran dans le corps de la PR), PRÊT-À-FONCTIONNER(écart explicitement nommé, avec la tâche d'achèvement planifiée dans la même PR), ou SQUELETTE-AVEC-SUITE(marqueur explicite status:stub, plus la tâche d'achèvement citée, plus une explication lisible par l'opérateur quand on y arrive). SQUELETTE-SANS-SUITEest une violation de la discipline.
La violation classique : livrer un écran avec un widget « File indisponible — Réessayer ». La forme du widget est correcte ; les données qu'il affiche n'existent pas ; aucune tâche d'achèvement n'est planifiée. L'utilisateur se heurte à un mur sans explication et sans issue.
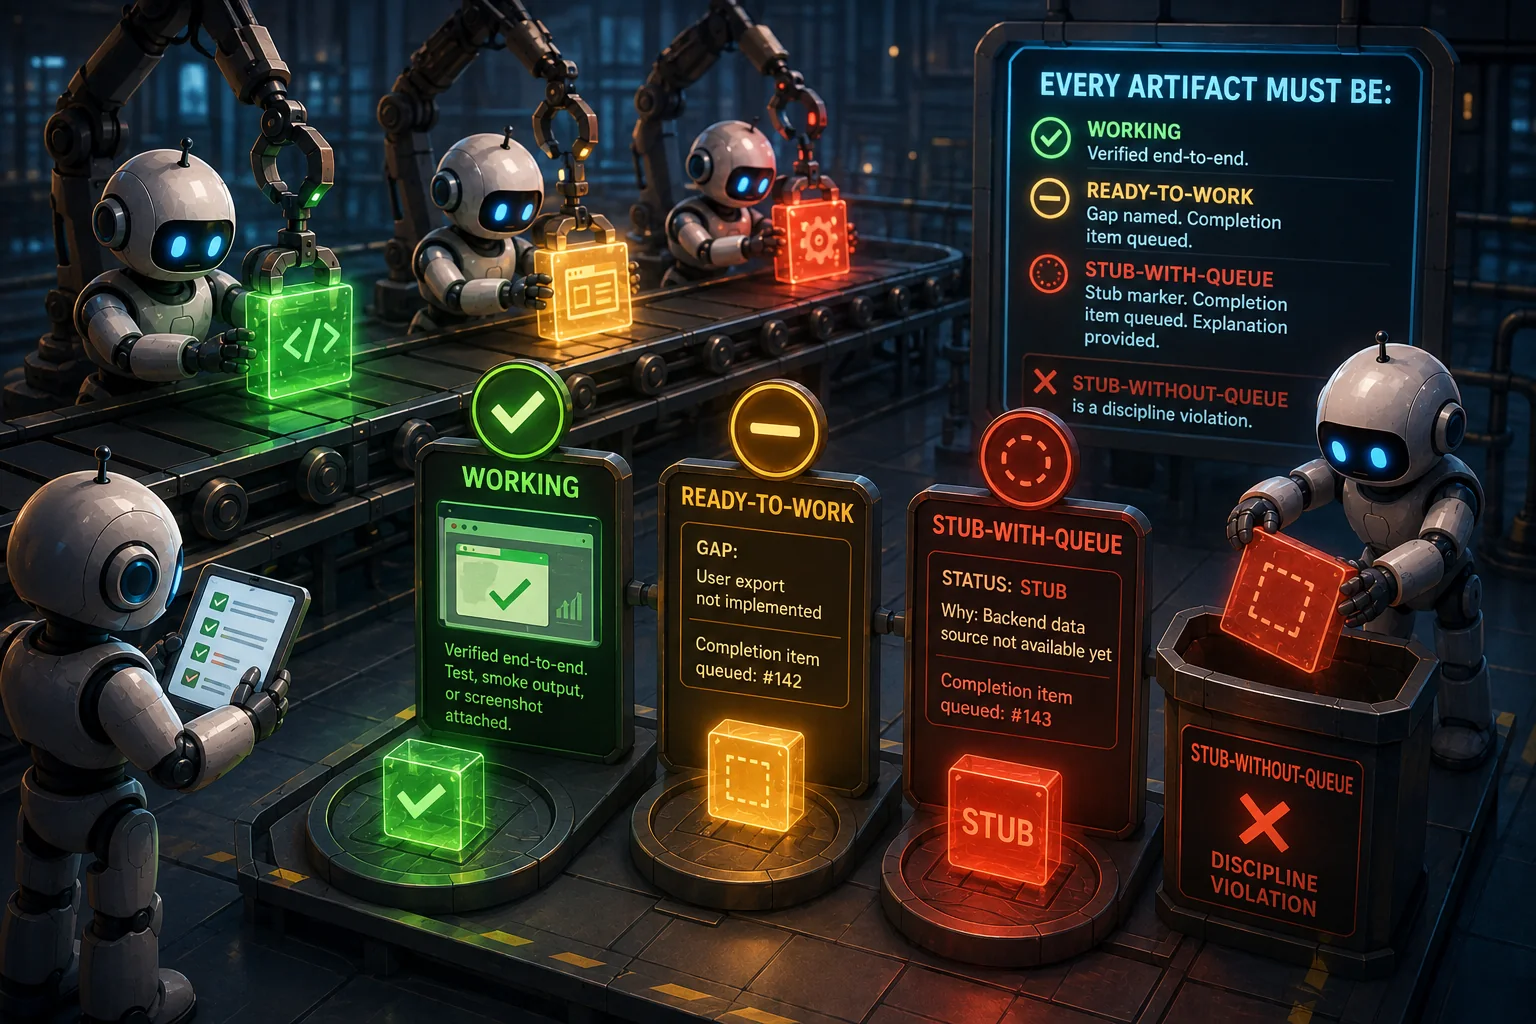
Une violation plus subtile : livrer un fichier de documentation avec des liens markdown vers des fichiers voisins qui n'existent pas. La cible du lien devrait être un fichier squelette-avec-suite, mais ce n'est même pas cela : c'est le vide. Le vérificateur de liens de la relecture fait échouer la CI ; la barrière de déploiement refuse ; la plateforme cale. J'ai livré exactement ce mode de défaillance dans la session qui a produit cet article — et la boucle d'analyse l'a repéré en quelques heures. J'y reviens plus bas.
Le protocole universel de démarrage à froid
Chaque boucle, au début de chaque déclenchement, exécute les mêmes six sondes avant tout travail :
- Se synchroniser sur la branche principale actuelle. Faire un pull. Voir ce qui a été intégré depuis le déclenchement précédent.
- Lire la matrice d'état de référence. Quel est l'état mesurable de la plateforme à cet instant ?
- Sonder le retard de déploiement. Quel SHA est en production par rapport à la branche principale ? Le goulot d'étranglement le plus fréquent est ici.
- Sonder la santé de la barrière de déploiement. Les derniers déploiements ont-ils réussi ? Ou bien la barrière de tests refuse-t-elle les mises en production ?
- Sonder le retard de relecture. Combien de PR ouvertes ? Depuis combien de temps ?
- Sonder le signal de CI. Les derniers passages sur la branche principale sont-ils verts ?
Plus une septième dans la boucle de supervision :
- Sonder la marge de limite de débit. Quelle part de la fenêtre de facturation actuelle est consommée ? Quel est le rythme de consommation ?
Après les sondes, chaque boucle applique ses règles de réponse dans un ordre de priorité ancré dans une justification : l'accessibilité avant l'exactitude, la barrière de déploiement avant le contenu, la CI de la branche principale avant le backlog, le backlog avant le nouveau travail, la métrique de plateforme avant la doctrine.
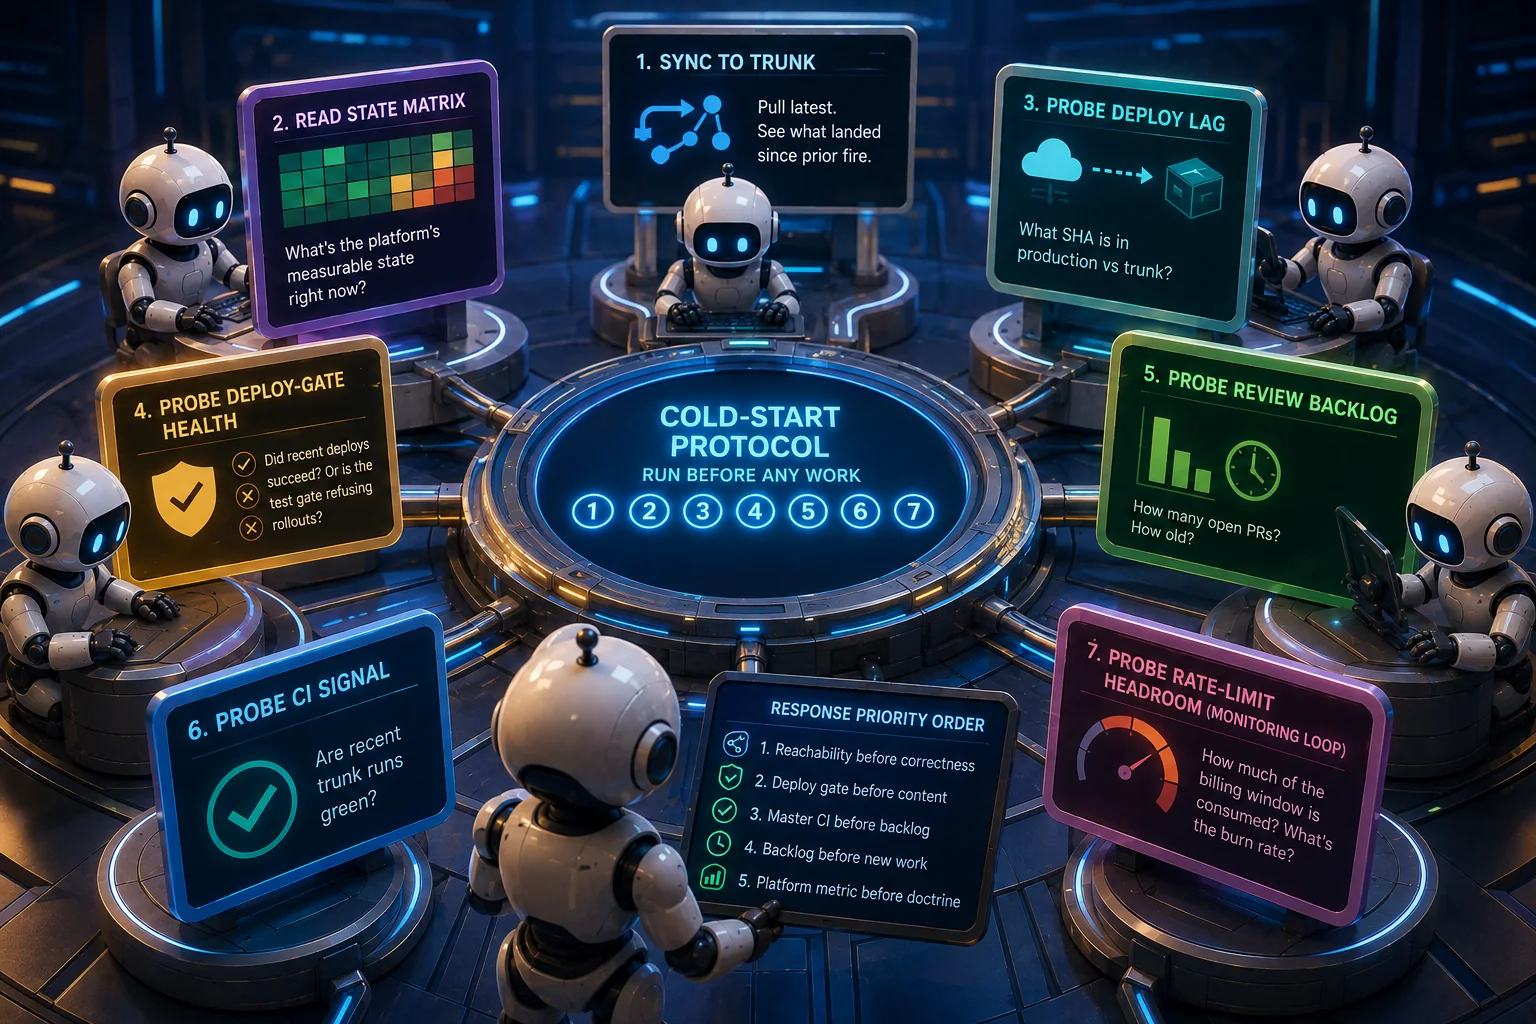
Cela semble bureaucratique. C'est l'inverse : cela retire à l'agent la liberté de mal choisir. Une boucle confrontée à « barrière de déploiement refusée, quatre PR non relues, CI rouge, backlog en croissance, domaine fonctionnel le plus mal noté à F » n'a plus à réfléchir à la priorité. Le protocole décide : la barrière de déploiement d'abord.
Treize invariants de robustesse
Les protocoles de sondage d'état sont fragiles par nature. Les sondes expirent, des fichiers manquent, les réseaux tombent. Donc :
- I-1. Chaque sonde a un délai d'expiration strict (10 secondes par défaut, 30 secondes pour SSH).
- I-2. Chaque sonde a un repli dégradé (l'échec d'une sonde n'entraîne pas l'échec du déclenchement).
- I-3. Résolution des conflits par priorité ancrée dans une justification, pas par première correspondance.
- I-4. Détection de l'obsolescence de l'état (plus de 24 heures déclenche un nouveau parcours complet).
- I-5. Reprise après crash au démarrage à froid (branches laissées ouvertes, verrous expirés, état non validé).
- I-6. Concurrence par bail. Chaque type de boucle détient son propre fichier de verrou. Deux déclenchements simultanés du même type de boucle ne peuvent pas entrer en collision.
- I-7. L'action par défaut « ne rien faire » équivaut à « explicitement neutre » avec signalement. Les déclenchements silencieux sans effet sont impossibles.
- I-8. Journal d'audit par déclenchement. Résultats des sondes, décision, action, vérification : tout est consigné.
- I-9. Vérification après action obligatoire. Une vérification échouée signifie ANNULER, pas réessayer.
- I-10. Plafond de coût par déclenchement (200 000 jetons). Les boucles qui s'emballent sont bornées.
- I-11. Interruption par l'opérateur avec arrêt propre. Un fichier STOP en plein déclenchement signifie sortie propre, sans état à moitié fait.
- I-12. Sûr à l'amorçage. Fonctionne dès la toute première exécution, quand les fichiers d'état n'existent pas encore.
- I-13. Isolation par worktree. Chaque boucle opère dans son propre worktree git — répertoire de travail distinct, même dépôt
.gitpartagé. Sans cela, deux boucles qui partagent un arbre de travail entrent en collision à chaque checkout et chaque pull. Ne découvrez pas cette leçon à la dure ; configurez-le dès le départ.
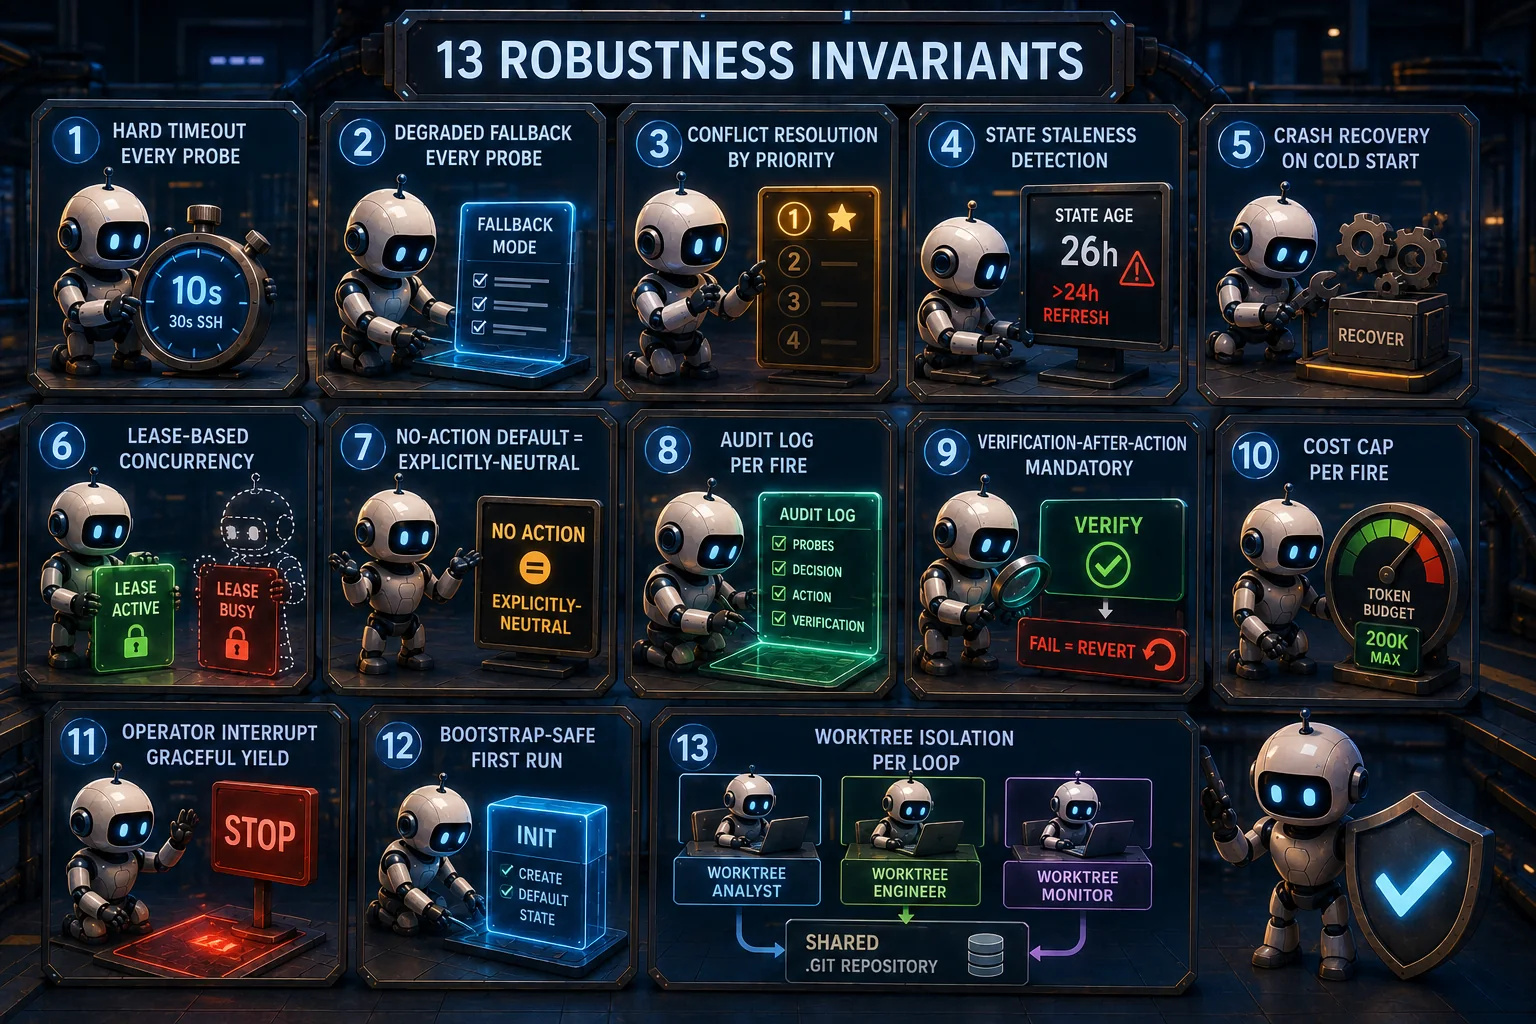
I-13 est celui que j'ai ajouté après cette session. Les douze autres, je les avais bien. Le schéma de collision que I-13 prévient est décrit dans la section « Ce qui met encore ce modèle en échec » plus bas.
La matrice des modèles et des modes de réflexion
Les plateformes modernes d'agents de codage permettent de choisir la taille du modèle ET le mode de réflexion (normal ou réflexion étendue avec un budget de raisonnement explicite). L'écart de coût entre le moins cher et le plus cher est d'environ 60×. Si chaque activité prend par défaut « le modèle le plus intelligent avec la réflexion la plus profonde », vous brûlez de l'argent sur du travail courant qui ne tire aucun bénéfice de la profondeur.
La correspondance entre activités et modèles :
- Relecture automatique courante d'une PR — modèle plus petit, réflexion normale. Il s'agit de comparer à des règles ; aucun raisonnement nouveau n'est nécessaire.
- Revue de code d'un changement substantiel — plus grand modèle, réflexion étendue (16k+ jetons). Une exactitude subtile demande de la profondeur.
- Sonde d'état au démarrage à froid — modèle plus petit, réflexion normale. Mécanique ; la profondeur est gaspillée.
- Synthèse transversale, comme la détection de dérive — modèle plus petit, réflexion étendue (~8k jetons). La comparaison de plusieurs sources profite d'un peu plus de raisonnement.
- Cause racine d'une convergence bloquée — plus grand modèle, réflexion étendue (16k jetons). Diagnostic de défaillances au niveau du système.
- Décision d'architecture qui se fige — plus grand modèle, réflexion étendue (16k+ jetons). Une mauvaise architecture coûte des semaines ; payez pour la profondeur.
- Débogage courant sur des schémas connus — modèle plus petit, réflexion normale. C'est de la consultation.
- Débogage inédit au-delà de 30 minutes — plus grand modèle, réflexion étendue (16k+ jetons). La profondeur est rentable.
- Audit de sécurité — plus grand modèle, réflexion étendue (16k+ jetons). Raisonnement subtil sur le modèle de menaces.
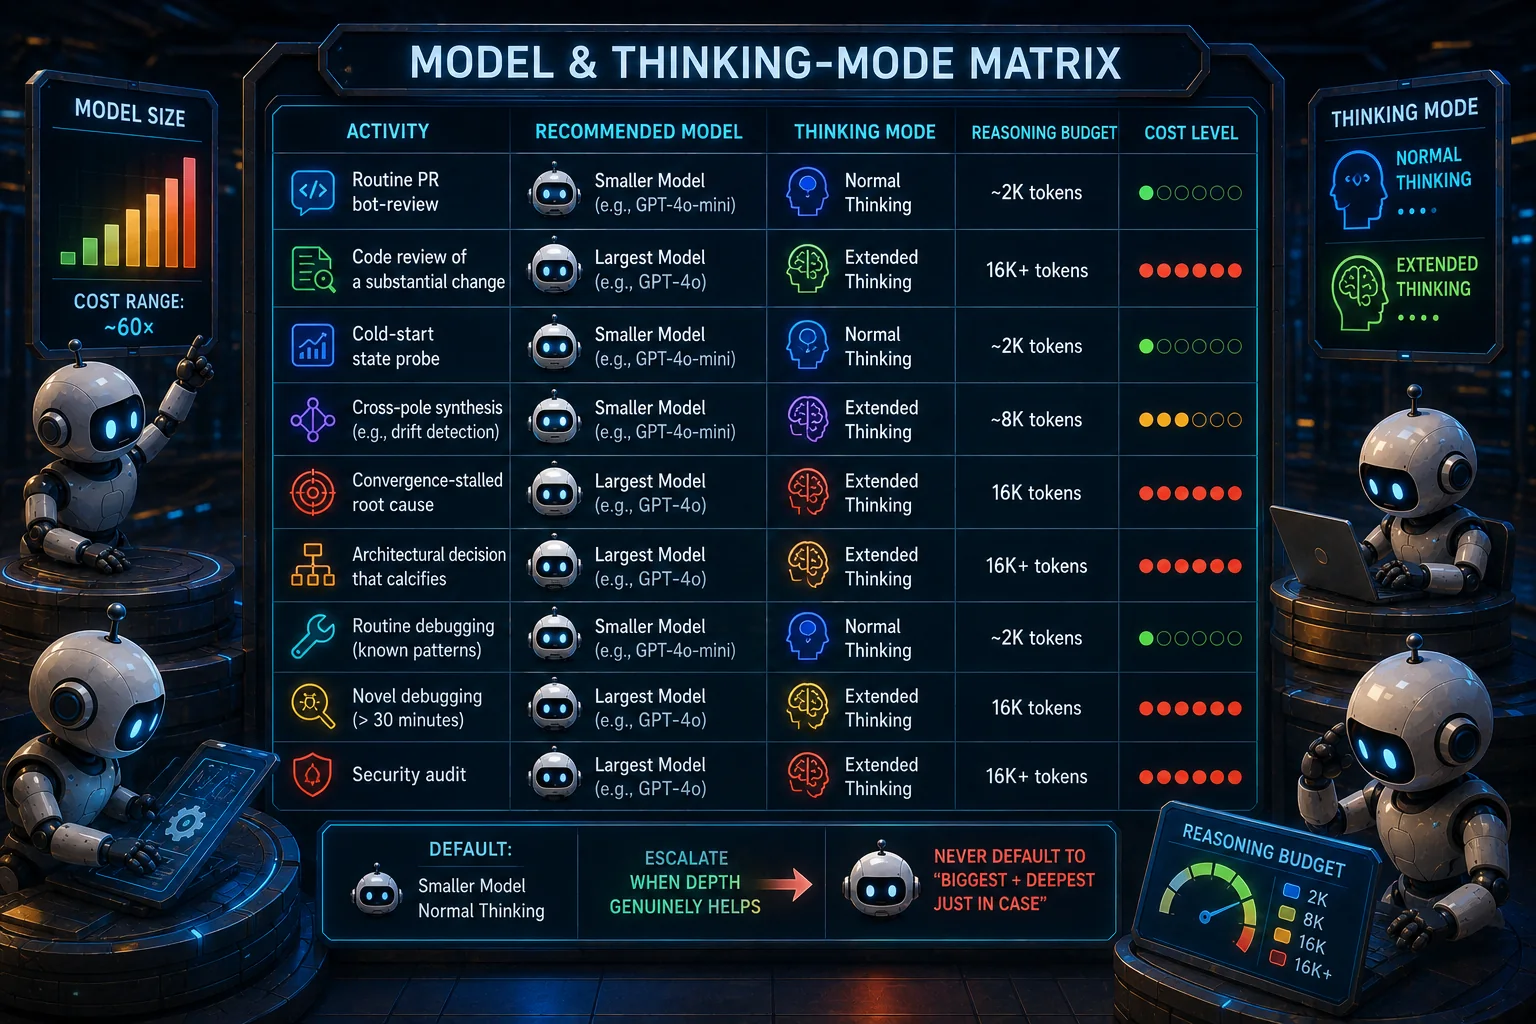
Par défaut : modèle plus petit + réflexion normale. Montez en gamme quand la profondeur aide vraiment. Ne prenez jamais par défaut « le plus gros + le plus profond, au cas où » — le plus gros poste de coût de tout système d'agents, ce sont les sous-agents qui héritent du modèle du parent alors qu'ils devraient passer à un modèle moins cher.
La frontière entre agent et opérateur
La règle la plus importante : les agents ne transfèrent pas silencieusement du travail à l'opérateur humain.
Quand un système de codage autonome ne peut pas faire quelque chose — expertise métier, positionnement sur le marché, tests avec de vrais utilisateurs, décisions de modèle économique — la tentation est d'écrire « l'opérateur devrait… » dans la documentation. Ce n'est pas honnête. C'est se décharger des parties difficiles au moment précis où l'opérateur est le moins équipé pour les assumer (au début de la vie du produit, quand il n'y a pas encore de MVP).
Ce que les agents LIVRERONT : faire passer les notes des fonctionnalités de cassées à fonctionnelles ; le polissage du design ; des analyses concurrentielles à partir de sources publiques ; la profondeur d'intégration ; des tests UX avant les clients (via la boucle de testeur à profil d'utilisateur) ; des parcours d'accueil ; des fonctions de reporting.
Ce que seul l'opérateur peut décider : la priorité stratégique (quelle fonctionnalité compte le plus pour le marché qu'il connaît) ; le modèle économique ; la préférence esthétique finale entre deux designs conformes ; l'autorisation explicite de contournement (quand un agent dit « ce test est instable, puis-je le contourner ») ; le reclassement des niveaux de priorité.
Les tests avec de vrais clients sont DIFFÉRÉS, pas transférés. Faire entrer de vrais utilisateurs avant le MVP consomme de la bonne volonté sur un produit cassé. La boucle de testeur à profil d'utilisateur fait office de substitut jusqu'à l'atteinte du seuil MVP. Ensuite, de vrais utilisateurs viennent trouver ce que le testeur simulé a manqué.
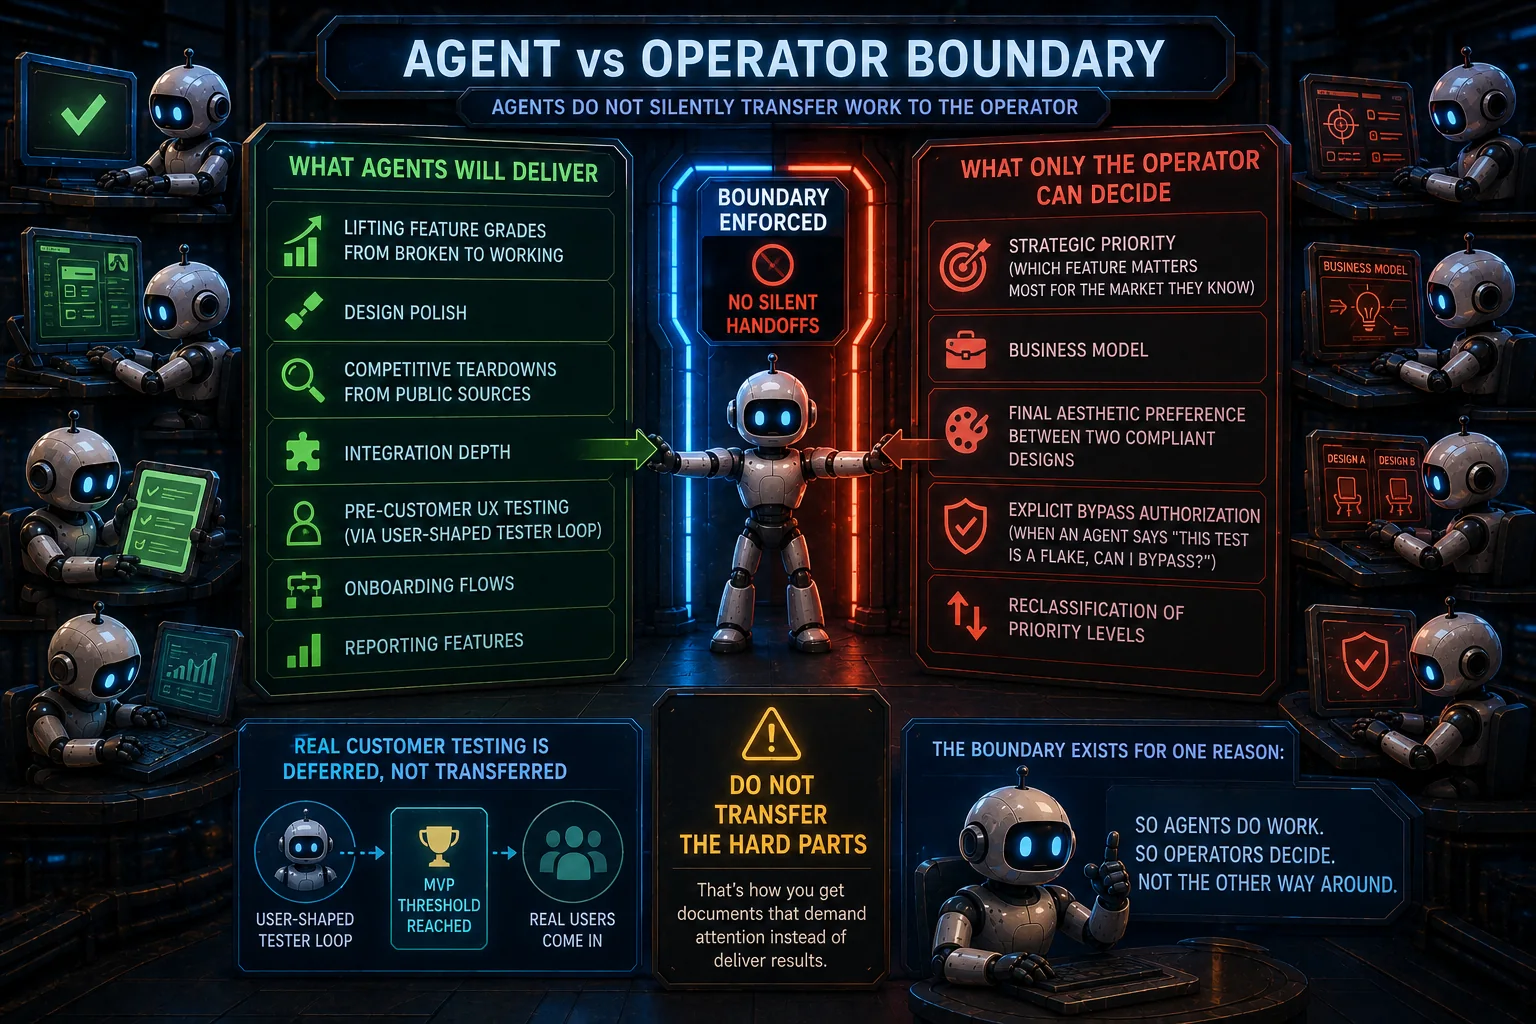
Cette frontière est celle que les opérateurs ont le plus besoin de faire respecter. Sans elle, le système d'agents devient quelque chose qui réclame l'attention de l'opérateur au lieu de quelque chose qui travaille.
Le fichier d'état unique de référence
Les quatre boucles, toutes les règles de discipline, tous les protocoles — tout cela est inutile s'il n'existe pas de définition partagée de « l'état de la plateforme à cet instant ».
Un seul fichier. Un tableau de tendance en ajout seul. Chaque ligne est un instantané dans le temps. Les colonnes sont les métriques qui comptent pour le produit : notes par domaine fonctionnel, taux de réussite, nombre de blocages, profondeur des files.
Chaque boucle lit ce fichier au démarrage à froid. Les déclenchements convergents le mettent à jour. Les déclenchements à dérive neutre, non. Après une ou deux semaines, la tendance de ce fichier EST la réponse à la question « les agents produisent-ils de la convergence ».
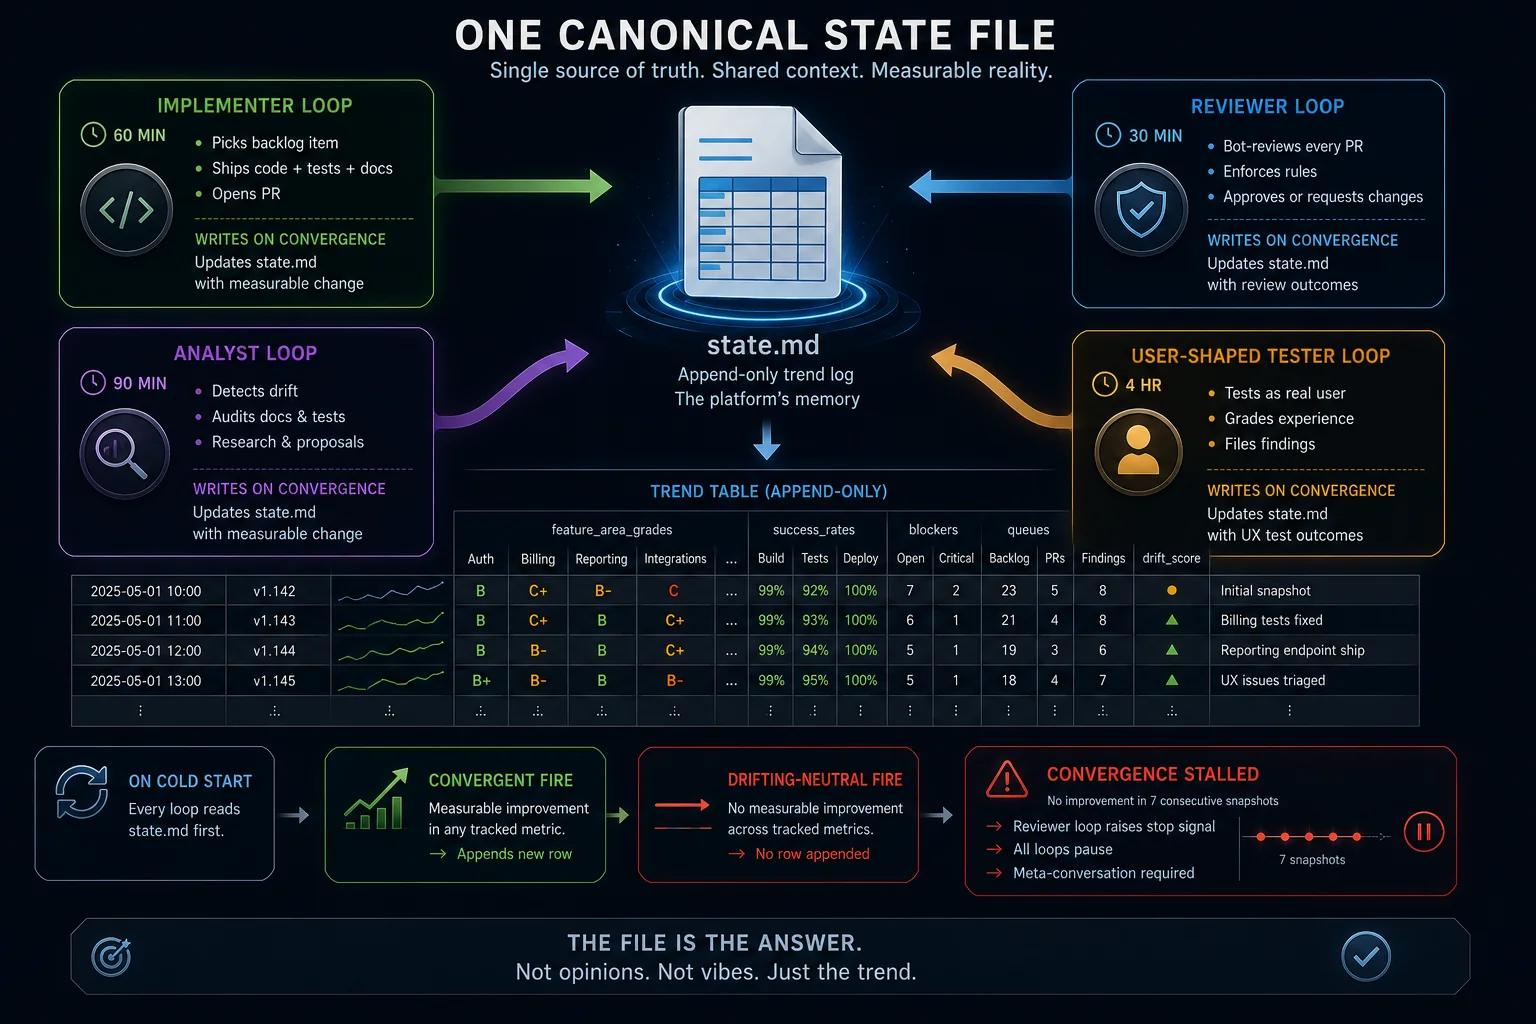
Si 7 instantanés consécutifs n'affichent aucun mouvement, la boucle de relecture fait remonter « convergence bloquée — mettre les boucles en pause, méta-discussion nécessaire. » Le fichier est la soupape de sécurité qui attrape le cas où chaque déclenchement se dit productif mais où l'ensemble ne l'est pas.
Ce qui met encore ce modèle en échec
C'est la section que le brouillon initial de cet article n'avait pas. Il m'a coûté une session de dérive pour l'ajouter.
La dérive de l'auteur
La personne (ou l'agent) qui écrit une règle l'enfreint couramment avant que l'encre ne soit sèche. J'ai livré une discipline par artefact qui disait « chaque artefact est livré FONCTIONNEL, PRÊT-À-FONCTIONNER ou SQUELETTE-AVEC-SUITE » — et dans la même session, j'ai livré une arborescence de documentation avec 16 liens markdown pendants qui ne correspondaient à aucun de ces états. La boucle d'analyse l'a repéré en quelques heures. J'étais l'auteur de la règle qui a signalé ma propre violation.
L'implication : l'autodiscipline ne fonctionne pas. Les boucles de relecture et d'analyse ne sont pas un luxe ; ce sont les seules choses qui attrapent la dérive de l'auteur. Construisez-les en premier. Les règles que vous écrivez vous-même ne vous lieront pas sans application extérieure.
Collisions d'arbre de travail partagé
Si vous faites tourner les quatre boucles depuis le même répertoire physique, elles entreront en collision à chaque opération git. Une boucle fait git checkout <branch> et le git status d'une autre boucle signale soudain une autre réalité. Des commits à moitié fusionnés sont attribués à la mauvaise session. Des fichiers non suivis apparaissent et disparaissent selon la branche que la dernière boucle a extraite.
Le remède est l'invariant I-13 ci-dessus : chaque boucle opère dans son propre worktree git. Répertoire de travail distinct, base .git partagée. La commande git worktree add tient en une ligne et règle définitivement toute cette classe de défaillances.
Je l'ai appris en entrant sans cesse en collision avec ma propre boucle d'analyse, alors que je faisais tourner une session principale pilotée directement par l'opérateur dans le même répertoire.
Pièges du lanceur
Trois pièges que vous rencontrerez avant même que les boucles ne commencent à se déclencher.
- Piège 1 : Les prompts multilignes sont tronqués. Le passage des arguments de processus sous Windows s'arrête au premier saut de ligne. Un brief de 3 300 caractères passé en argument positionnel au binaire de l'agent lui parvient sous la forme de ses 70 premiers caractères. Utilisez l'option d'entrée par fichier (
--append-system-prompt-file <path>ou équivalent) ou passez par stdin — tout ce qui ne met pas de sauts de ligne dans argv. - Piège 2 : Les commandes slash ne relèvent que de l'interface. Si votre brief demande à l'agent d'invoquer
/rename "Dev /loop"comme première action, il ne le peut pas. Les commandes slash sont gérées par l'interface utilisateur, pas par l'agent. Définissez plutôt le nom de la session au lancement (la plupart des plateformes ont une option-nou--name) et évitez complètement la directive. - Piège 3 : Le passage d'arguments natifs de PowerShell 5.1 n'est pas fiable. Les espaces, apostrophes et barres obliques dans les valeurs d'arguments peuvent être déformés quand PS 5.1 les transmet à un exécutable natif en mode
-File. Le diagnostic est sans ambiguïté : appeler le même exécutable à la main depuis PowerShell interactif fonctionne ; l'appeler via cmd → powershell -File script.ps1 -Param "value" échoue. Le remède : supprimer la couche PowerShell ; faire appeler directement l'exécutable natif par cmd.
Ces trois pièges, je les ai rencontrés en une seule session. Aucun n'est exotique — ils sont déterminants pour toute installation sur hôte Windows. Aucun n'est documenté dans les README des plateformes d'agents. Prévoyez une journée pour les trouver.
Le décalage entre coût et valeur
La session qui a produit cet article a coûté environ 157 $ de calcul en équivalent API (l'abonnement réel est forfaitaire ; ce montant est ce que le même travail coûterait en paiement à l'usage). Elle a produit neuf pull requests fusionnées de doctrine, d'infrastructure et de processus. Elle n'a produit aucune amélioration du produit visible par l'utilisateur. Le correctif de produit que j'avais commité en début de session n'est jamais arrivé en production parce que la barrière de déploiement a refusé — à cause de 15 tests en échec et des 16 liens markdown pendants que j'avais livrés.
C'est le décalage entre coût et valeur, nommé sans détour. La discipline que je décris dans cet article a été construite au cours de cette session précise. L'état mesurable de la plateforme ne s'est pas amélioré. L'infrastructure qui permettra aux futures sessions de l'améliorer existe désormais — et il faut être honnête avec soi-même (et avec son opérateur) quand c'est l'arbitrage que l'on a fait.
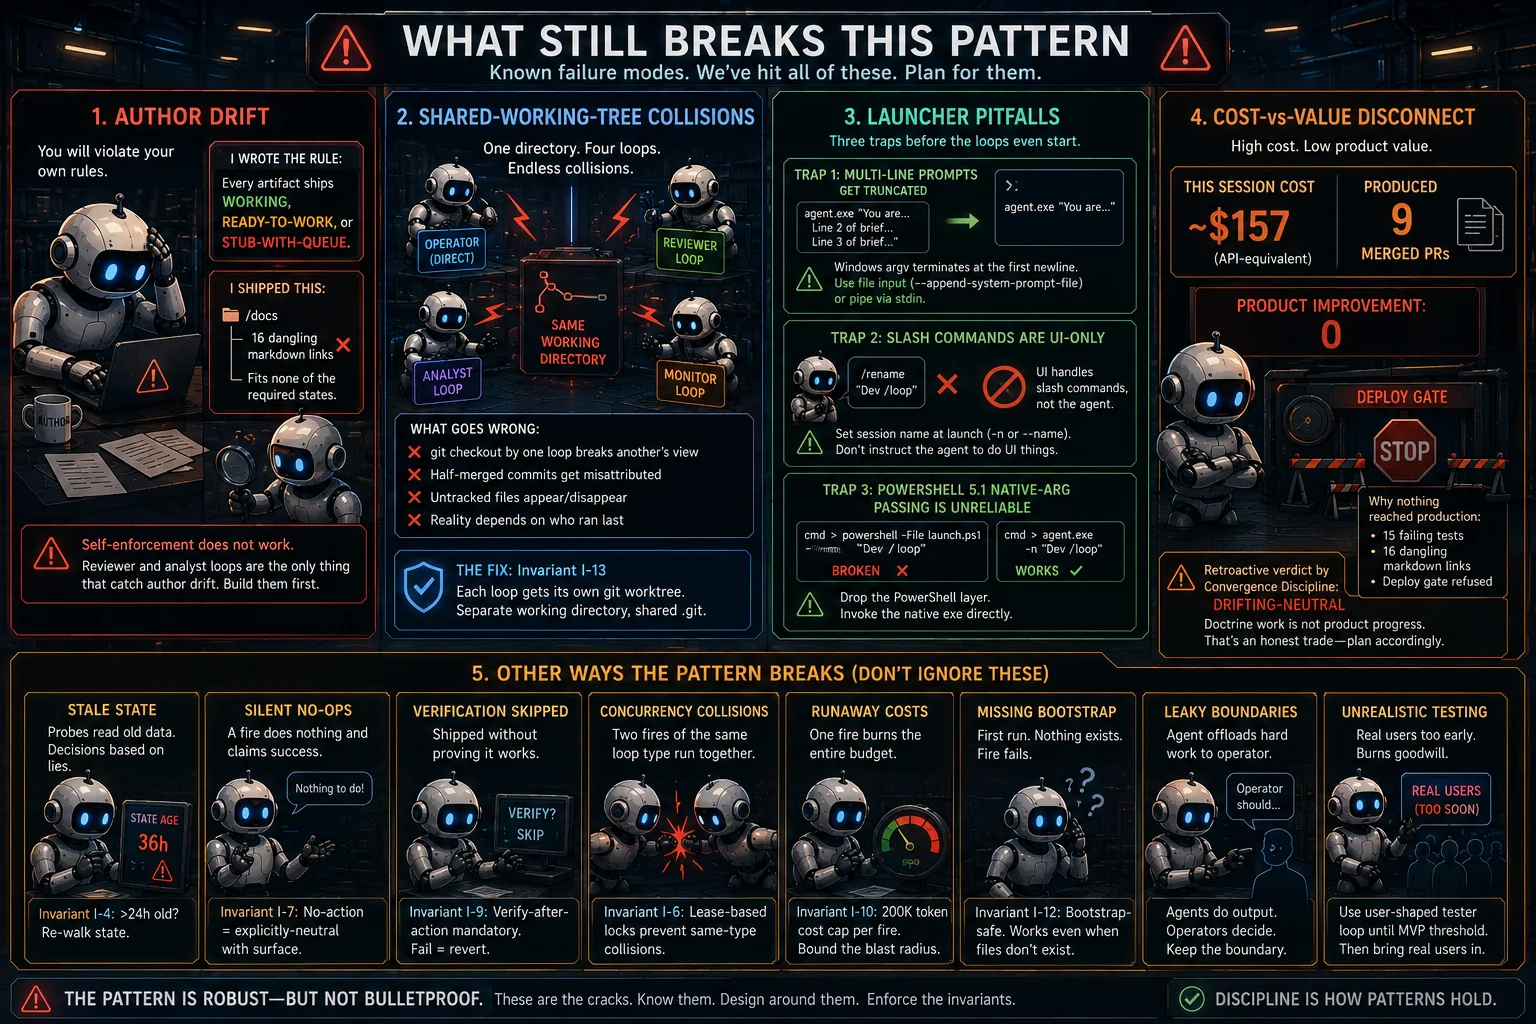
La règle de discipline de convergence, appliquée rétroactivement, aurait signalé toute la session comme DÉRIVE NEUTRE. C'est la règle qui fonctionne comme prévu. Cela vous dit aussi quelque chose d'inconfortable : une session conçue pour produire un article sur la discipline ne peut guère produire aussi du progrès produit, car chaque minute passée sur la doctrine est une minute qui n'est pas passée sur la fonctionnalité. Planifiez en conséquence.
Ce que cela NE fera PAS
Des limites honnêtes sur ce que la discipline peut et ne peut pas apporter :
- Elle fera passer chaque domaine fonctionnel de cassé à fonctionnel. Elle n'atteindra pas la note maximale sans méthodes de workflow au niveau du domaine et vérification des changements d'état.
- Elle livrera une esthétique prête pour la production grâce à une barrière de design system. Elle ne créera pas la première fondation esthétique — c'est l'opérateur qui choisit le langage de design.
- Elle assemblera des analyses de parité fonctionnelle avec la concurrence à partir de sources publiques. Elle ne décidera pas du positionnement stratégique face aux acteurs en place — cela relève de la connaissance du marché par l'opérateur.
- Elle réalisera des tests UX avant les clients grâce à un agent simulant un utilisateur novice. Elle ne trouvera pas les vrais points de douleur des clients — les vrais utilisateurs arrivent après le MVP.
- Elle soutiendra la convergence à un coût connu. Elle ne vous fera pas passer du MVP au « meilleur du marché » — il y faut des entrées que les boucles n'ont pas.
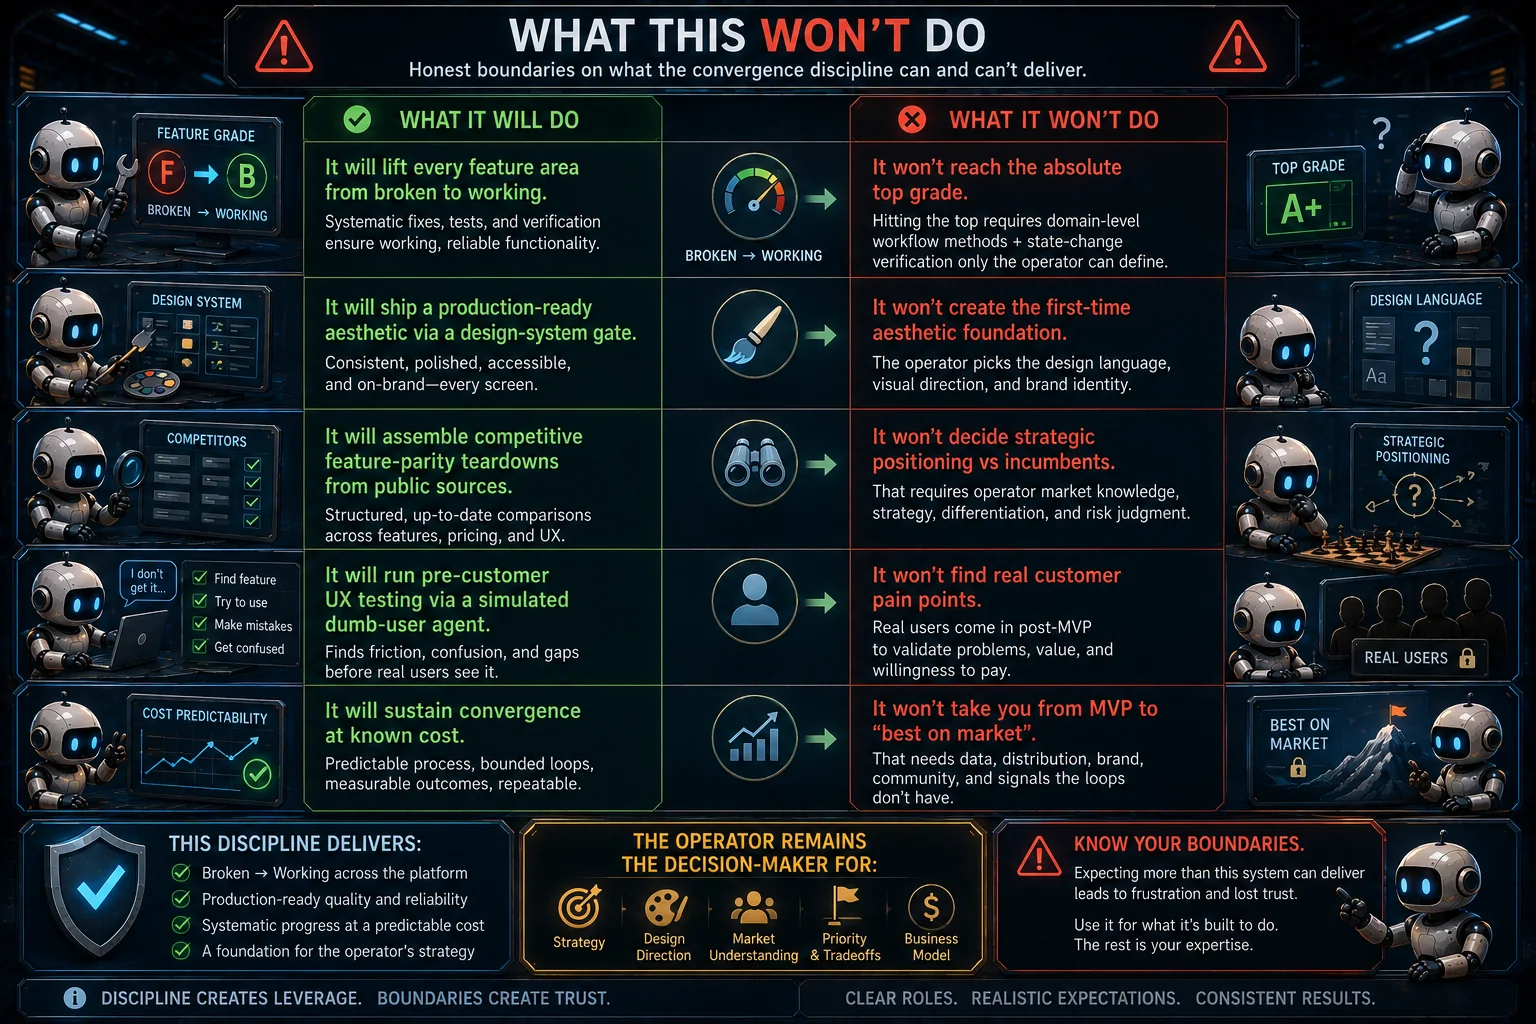
Nommer ce qui n'arrivera pas fait partie de la discipline. Sans cela, les opérateurs attendent plus que ce que le système peut livrer et perdent confiance quand il déçoit.
Ce que cela coûte
Une session à quatre boucles qui tourne 8 heures par jour à une cadence conforme à la matrice coûte à peu près l'équivalent du budget d'outillage mensuel d'un ingénieur de niveau intermédiaire. L'abonnement réel est forfaitaire ; la contrainte, ce sont les limites de débit par fenêtre de facturation, pas les dollars.
Tout mettre par défaut sur le plus grand modèle avec la réflexion la plus profonde ? Environ 5 à 7 fois plus. La discipline de la matrice fait la différence entre une ingénierie autonome durable et une facture qui s'emballe.
Le coût par session est plus variable. Une session qui ne livre que de la doctrine — comme celle qui a produit cet article — brûle du budget sans produire d'amélioration du produit. Ce n'est pas du gaspillage si la doctrine va être rentabilisée en convergence lors des sessions futures, mais c'en est bien si la doctrine reste sans application.
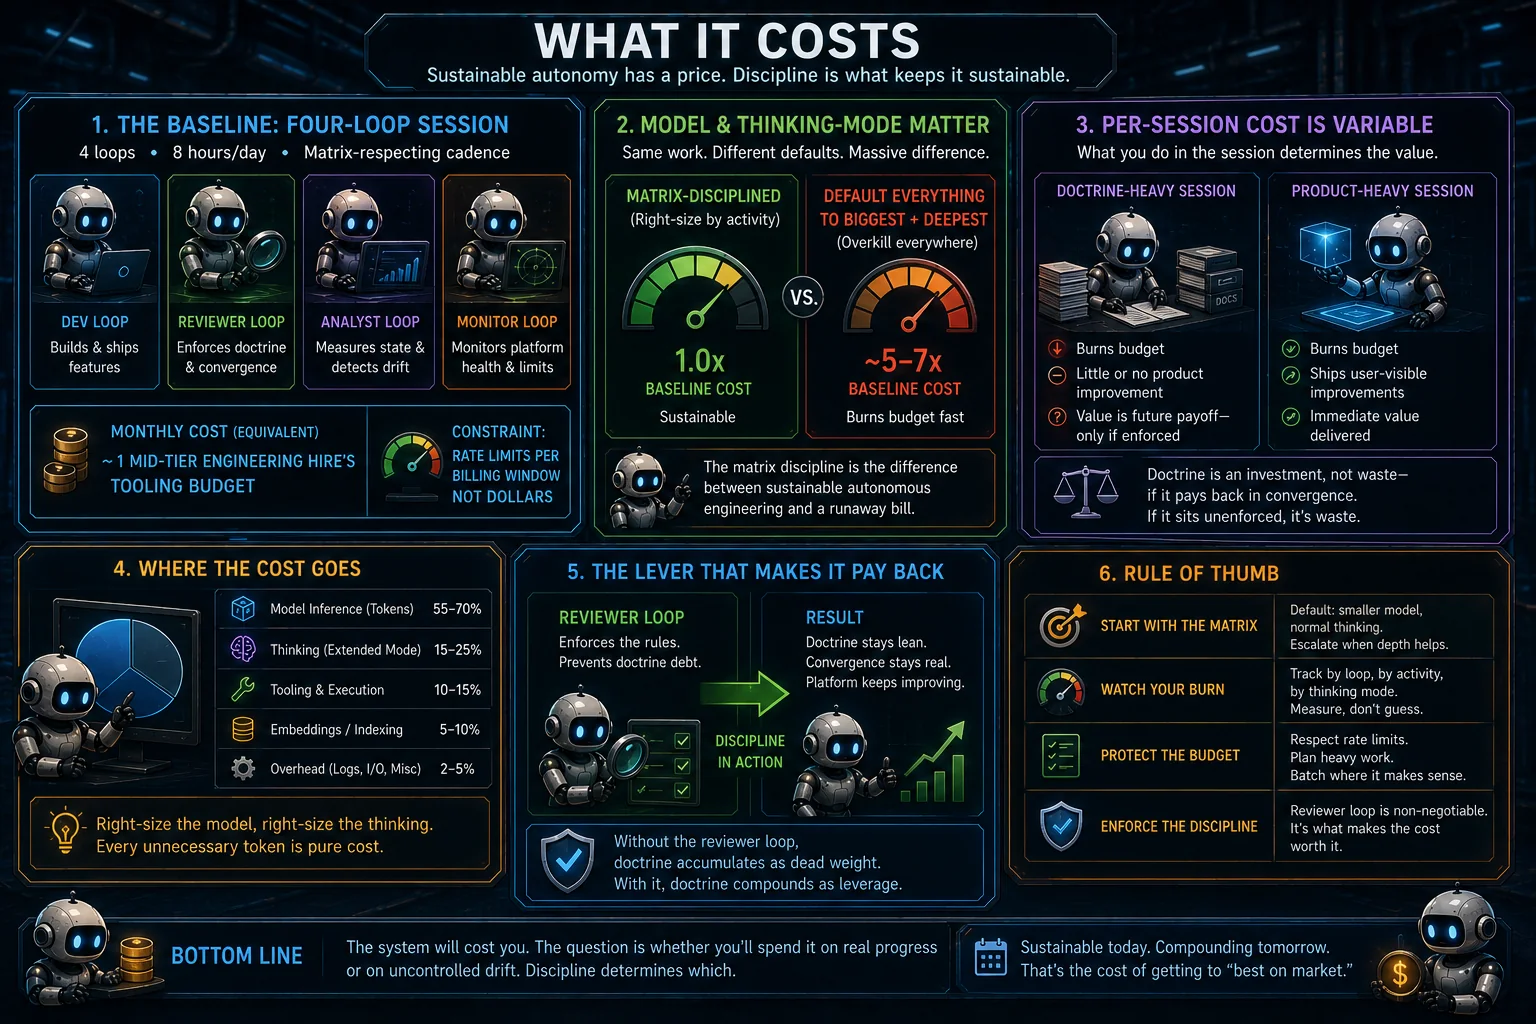
C'est la boucle de relecture qui rentabilise la doctrine. Sans elle, la doctrine s'accumule comme un poids mort.
La leçon que je ne cesse de réapprendre
Chaque fois que j'ajoute une règle, un agent ou un processus à ce système, j'ajoute de la charge pour l'avenir. La règle de discipline de convergence est la seule qui soit net-négative en charge : elle force chaque autre ajout à se rentabiliser en amélioration mesurable.
La pathologie que j'ai décrite au début de cet article — « les agents sont productifs mais le produit n'avance pas » — est un échec de discipline, pas un échec d'outillage. Les agents font exactement ce qu'on leur dit : livrer des commits, passer la CI, mettre la documentation à jour. On ne leur a simplement pas dit que ces commits devaient faire bouger un axe mesurable.
Une fois que vous le leur dites, avec des règles explicites par déclenchement et par artefact, un fichier d'état de référence unique, une séparation des responsabilités en quatre boucles, la frontière honnête sur ce que seuls les humains peuvent faire, et une isolation par worktree pour qu'ils n'entrent pas en collision — les agents deviennent utiles.
Pas magiques. Utiles. Parfois.
Le « parfois » est la partie que le brouillon initial de cet article avait manquée. La discipline est la cible. Même écrite, même avec des règles explicites, même avec la boucle de relecture en marche, vous (et vos agents) dériverez. La dérive est rattrapée — c'est le rôle de la boucle d'analyse — mais elle n'est pas évitée. Le mécanisme se corrige tout seul ; il ne se prémunit pas tout seul.
Cette distinction compte. La littérature sur les outils d'ingénierie IA regorge d'affirmations « magiques ». La réalité : un petit ensemble de schémas disciplinés, appliqués rigoureusement par d'autres agents (et non par autodiscipline), qui font que des agents autonomes accomplissent un vrai travail la plupart du temps, avec une dérive repérée et corrigée le reste du temps. Tout le reste est du théâtre.
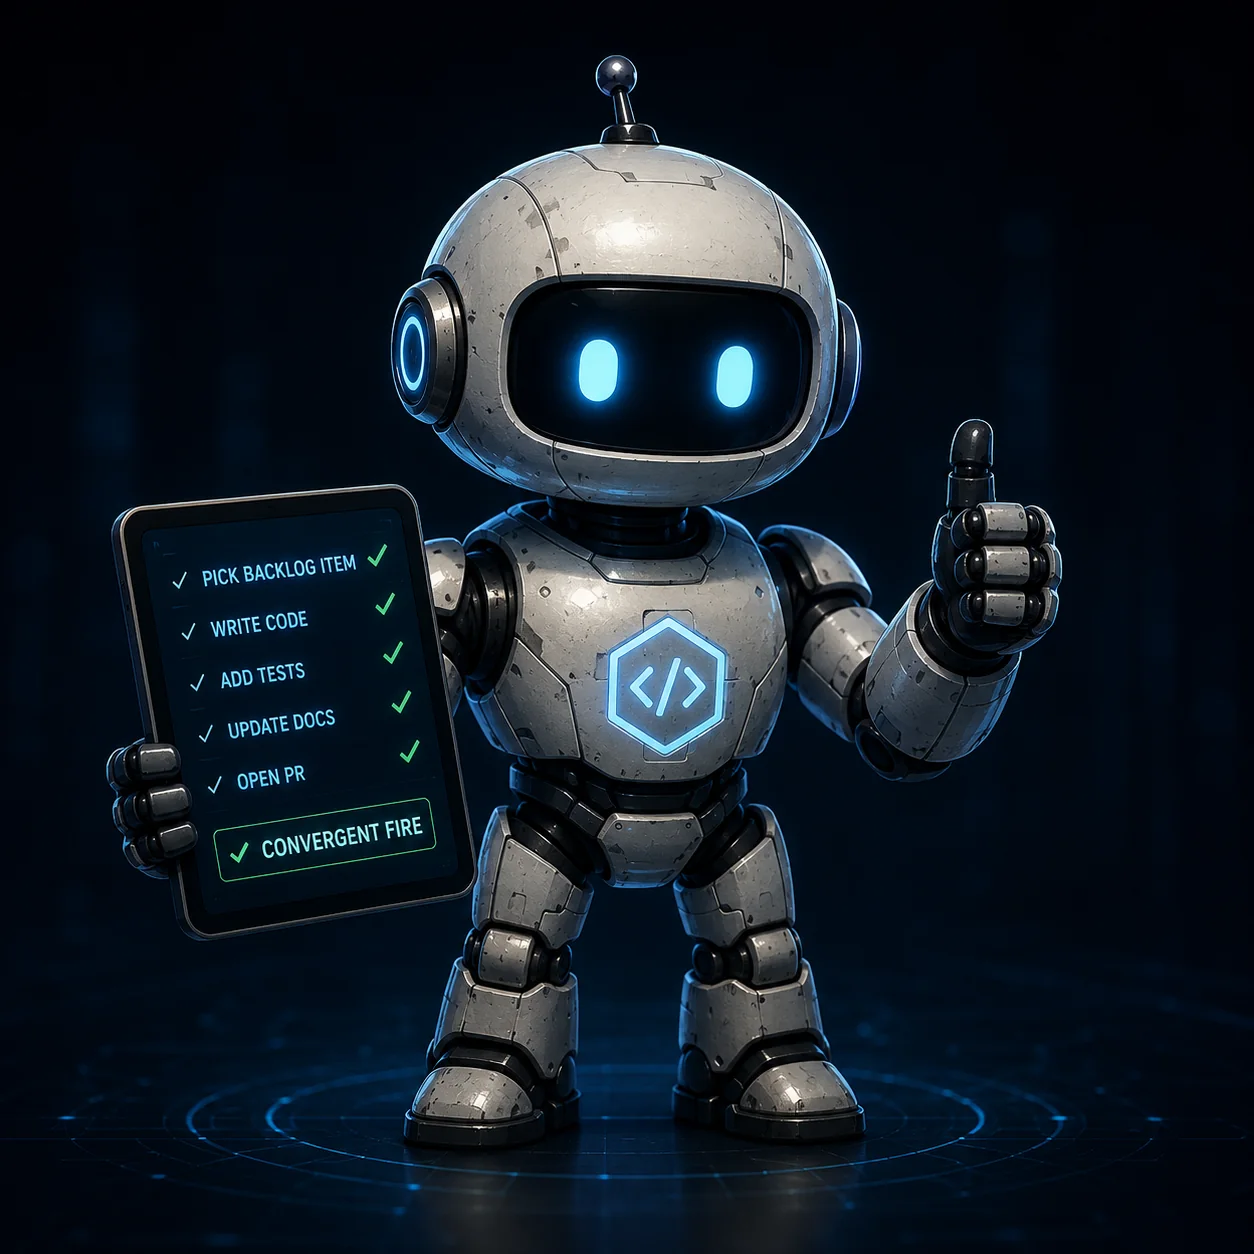
Si vous faites tourner des agents de codage sur une vraie base de code et que vous observez les modes de défaillance que j'ai décrits, les schémas ci-dessus peuvent vous aider. Ils ne sont pas nouveaux ; la plupart codifient ce que font déjà les bonnes équipes d'ingénierie. La nouveauté est de les rendre porteurs pour des boucles autonomes, où aucun humain n'est sur le chemin immédiat pour les faire respecter implicitement — et de nommer les modes de défaillance qui survivent malgré tout à la discipline.
Addendum. Aide-mémoire
Cette page est une copie intégrale de l'article tel que publié sur Medium. Lire sur Medium. Illustrations générées par IA.