
Medium · Автоматизация, веб-скрапинг · Черновик
Когда API недостаточно: извлечение данных через браузер от имени пользователя
Современные SaaS-платформы часто предоставляют публичные API. В теории это должно упрощать интеграции, отчётность, сбор доказательств для комплаенса, аналитику и автоматизацию.
Впервые опубликовано на Medium 26 мая 2026 года. Читать на Medium. Время чтения: 8 минут.
На практике доступного API не всегда хватает:
- Иногда публичного API нет вовсе.
- Иногда он есть, но отдаёт лишь ограниченную часть данных.
- Иногда данные видны в веб-приложении, но недоступны через документированные конечные точки.
- А иногда экспорт ограничен CSV-файлом без метаданных, связей, комментариев, истории или журнала аудита, которые нужны для законной деловой цели.
Возникает практическая проблема: пользователь вправе получить информацию, информация видна в приложении, но подходящего официального способа получить её в структурированном и повторяемом виде нет.
В таких случаях извлечение данных с помощью браузера может стать практическим обходным путём.
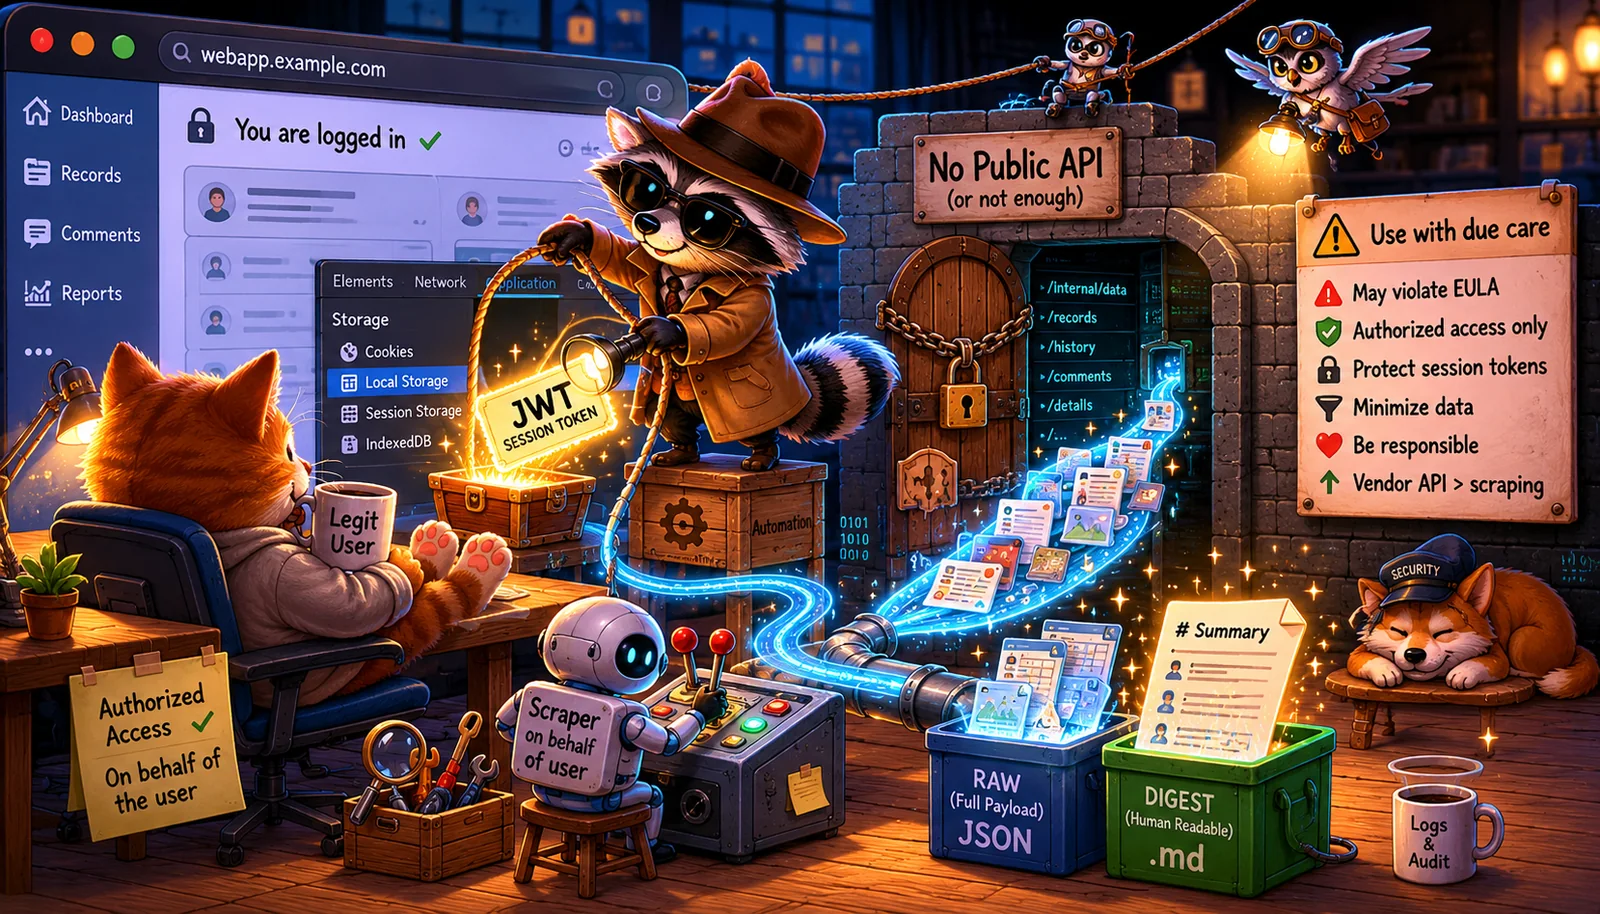
1. Это не роботизированная автоматизация процессов (RPA)
Такой подход может напоминать роботизированную автоматизацию процессов (RPA), но это не совсем одно и то же.
Традиционная RPA, как правило, имитирует пользовательский интерфейс: нажимает кнопки, заполняет формы, прокручивает страницы, ждёт загрузки экранов и считывает видимые элементы. Она рассматривает веб-приложение как визуальное рабочее пространство и автоматизирует те же шаги, которые человек выполнил бы вручную.
Извлечение с помощью браузера работает на другом уровне. Браузер по-прежнему используется для законной аутентификации пользователя и контроля доступа, но сам сбор данных выполняется через наблюдение и повторное использование собственного обмена приложения с его бэкендом. Вместо того чтобы копировать значения с экрана, автоматизация получает структурированные данные, которые приложение само уже получает, чтобы отрисовать этот экран.
Проще говоря:
- RPA автоматизирует то, что пользователь делает на странице.
- Извлечение с помощью браузера автоматизирует то, что страница делает за кулисами от имени пользователя.
Это различие важно. Извлечение с помощью браузера, как правило, стабильнее, быстрее и полнее визуальной автоматизации интерфейса, потому что работает со структурированными данными, а не с отрисованными элементами интерфейса. В то же время оно требует большей осторожности, так как может опираться на внутреннее поведение приложения, недокументированные конечные точки, cookie, session storage, local storage и прочие артефакты сессии.
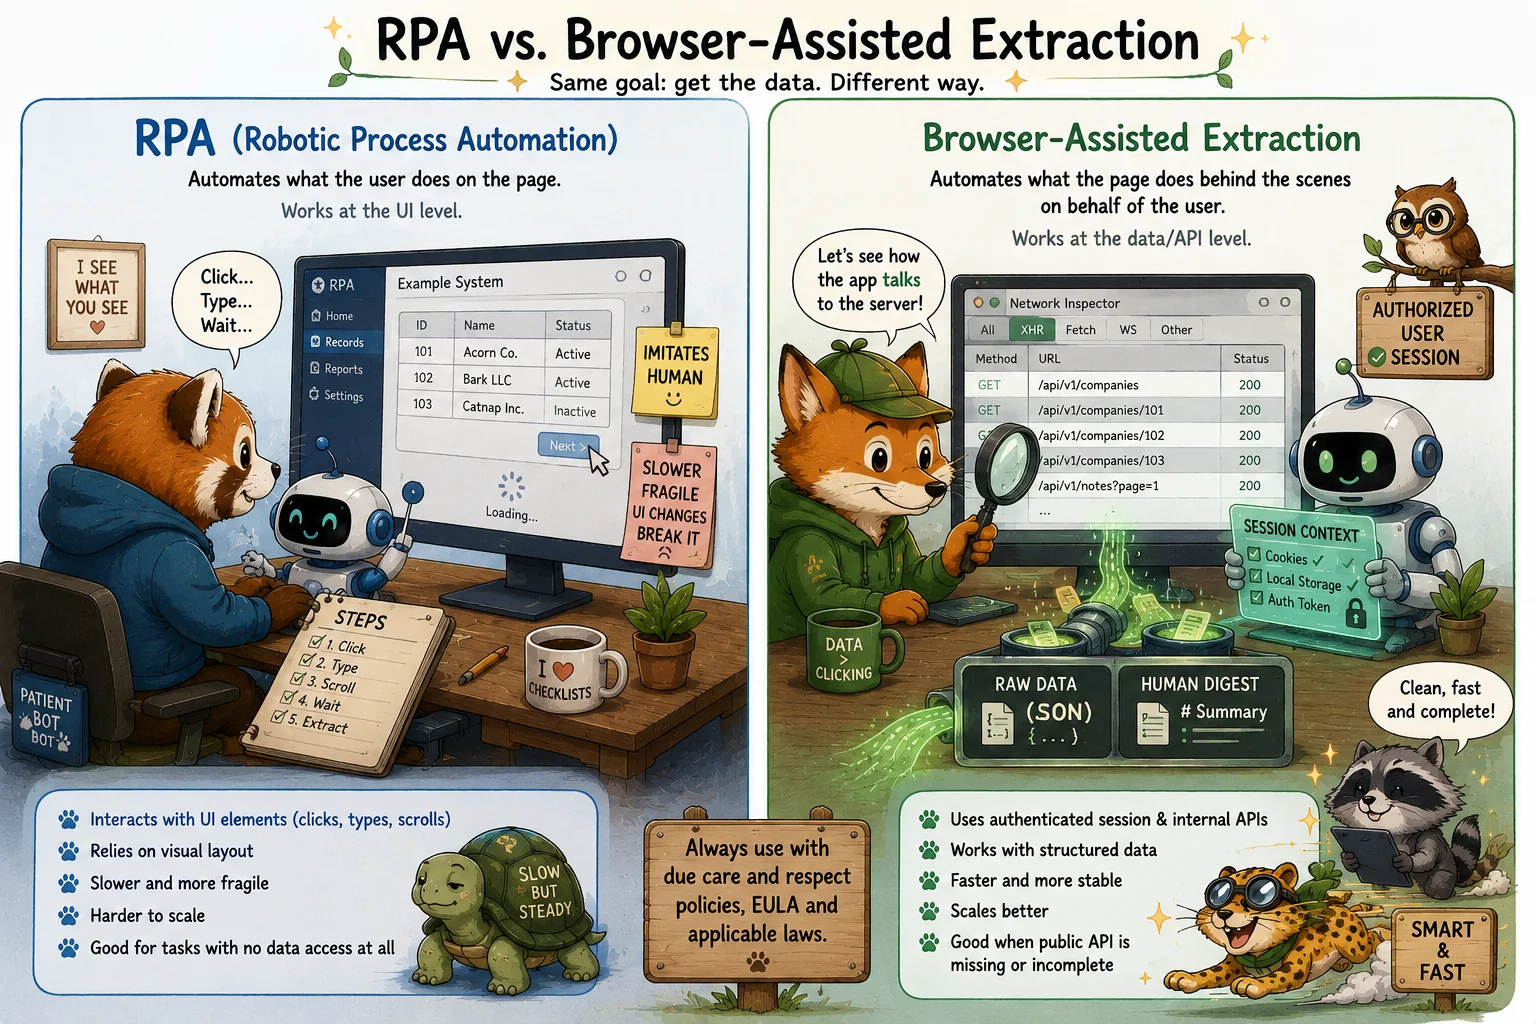
Поэтому этот приём следует считать контролируемым обходным путём. Он не заменяет ни официальный API, ни поддерживаемую интеграцию, ни должным образом документированную функцию экспорта. Он ближе к «обнаружению API через аутентифицированную сессию браузера», чем к классической RPA.
Принцип остаётся неизменным: автоматизация должна действовать только от имени уполномоченного пользователя, собирать только те данные, к которым у него есть право доступа, и применяться с учётом правовых, договорных, а также требований конфиденциальности и безопасности.
2. Сценарий
Допустим, в компании есть система для управления, комплаенса, операций или внутреннего администрирования.
У системы есть веб-интерфейс. Уполномоченные пользователи могут входить, просматривать записи и детали, вручную экспортировать или копировать информацию. Но у системы есть одно из следующих ограничений:
- Публичного API нет.
- Публичный API неполон и не отдаёт все нужные данные.
- Функции экспорта недостаточно для нужд бизнеса, аудита, миграции или отчётности.
- Важные метаданные видны в браузере, но недоступны через документированные способы интеграции.
- Ручное извлечение было бы медленным, подверженным ошибкам и трудно воспроизводимым.
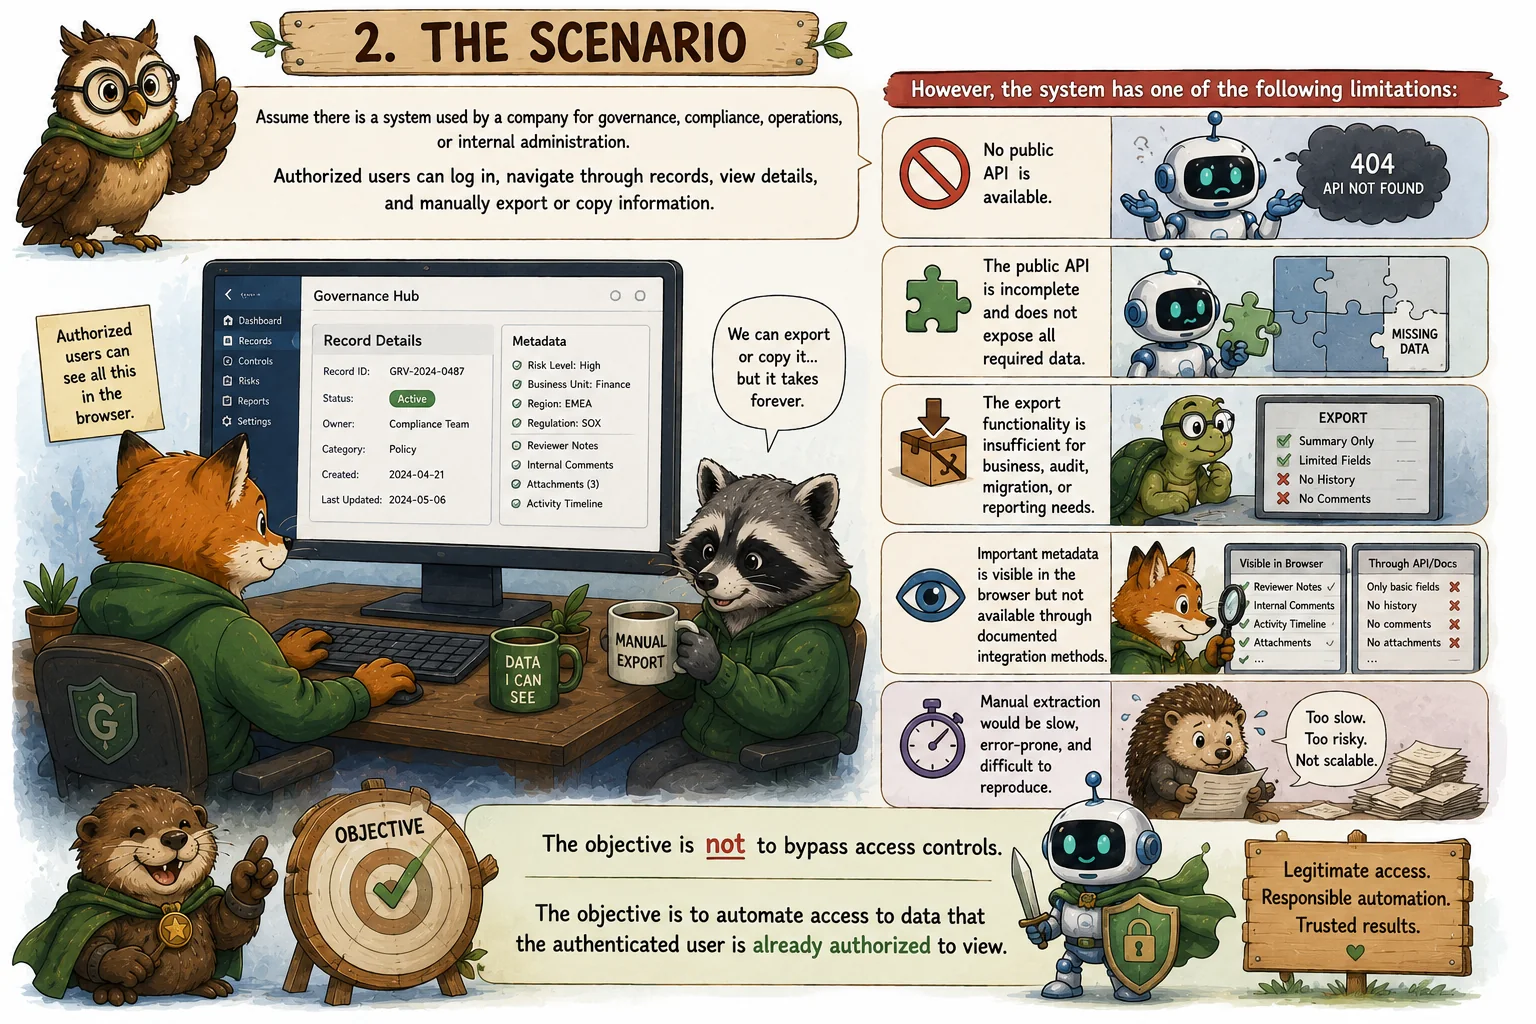
Цель — не обойти контроли доступа. Цель — автоматизировать доступ к данным, которые аутентифицированный пользователь и так вправе просматривать.
3. Общий подход
Общий приём — веб-скрапинг с помощью браузера от имени пользователя.
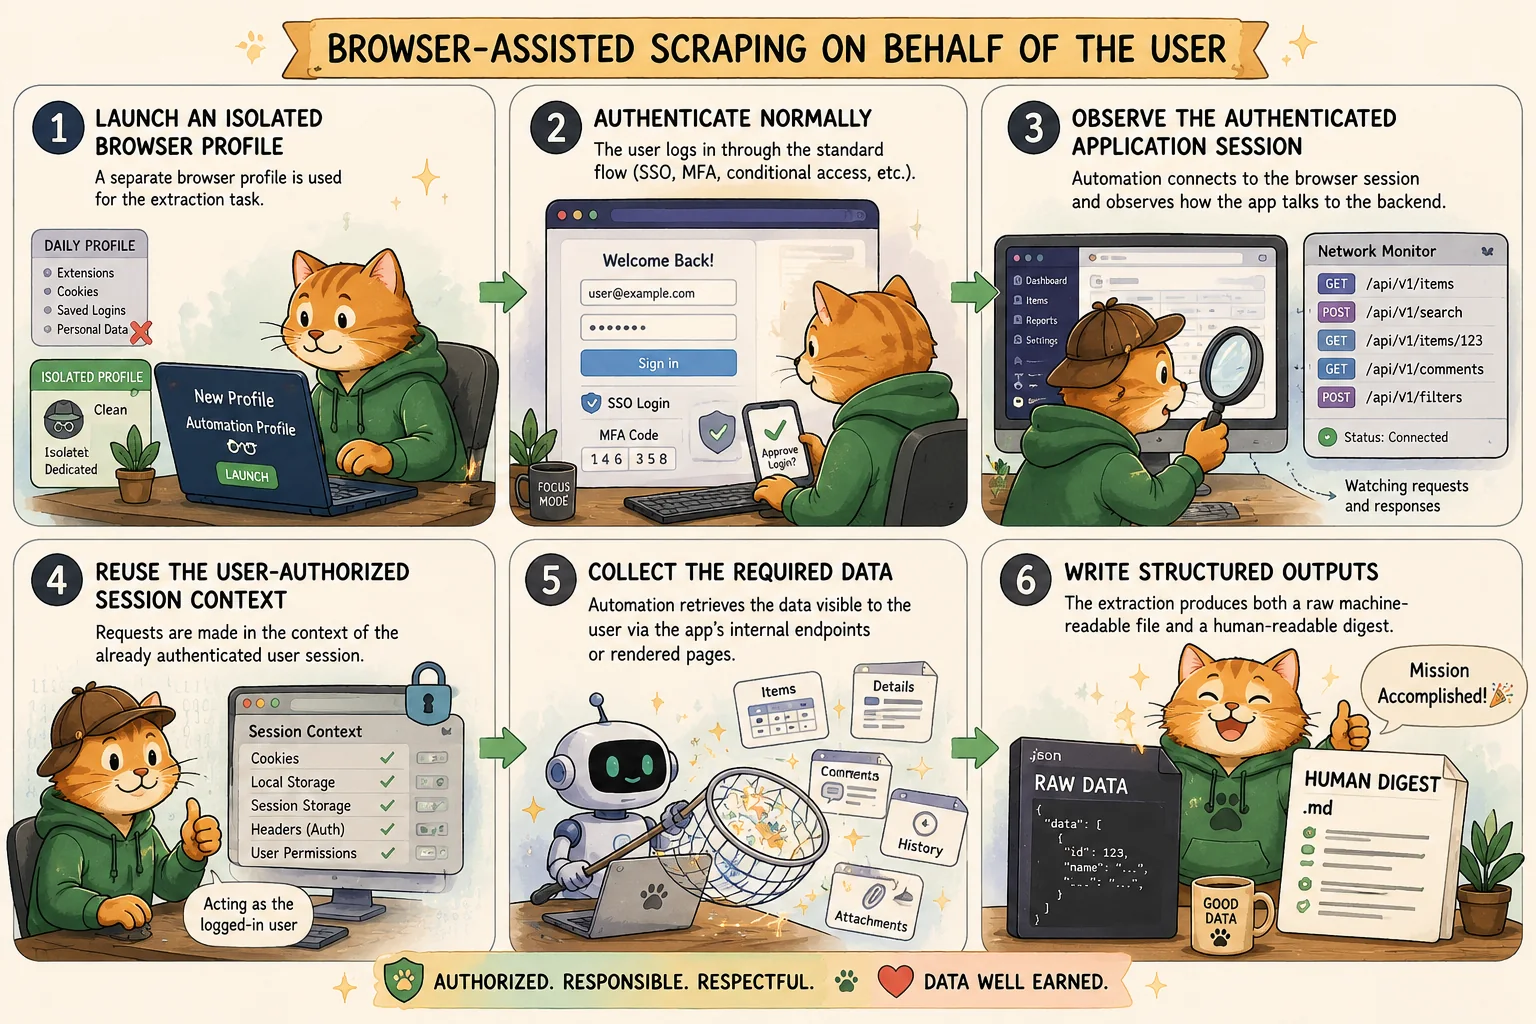
Типичный порядок действий может быть таким:
- Запустить изолированный профиль браузера. Для задачи извлечения используется отдельный профиль браузера. Так сессия автоматизации не смешивается с повседневным профилем пользователя, его расширениями, сохранёнными учётными данными, посторонними cookie и личными сессиями.
- Войти как обычно. Пользователь входит через стандартный веб-интерфейс, используя обычный процесс аутентификации, включая SSO, MFA, условный доступ и любые другие контроли, которые требует система.
- Понаблюдать за аутентифицированной сессией приложения. После входа автоматизация подключается к сессии браузера и наблюдает, как веб-приложение обменивается данными с бэкендом.
- Повторно использовать контекст сессии, авторизованной пользователем. Автоматизация выполняет запросы в контексте уже аутентифицированной пользовательской сессии. В некоторых системах нужные данные сессии могут храниться в доступных браузеру хранилищах, таких как cookie, session storage или local storage.
- Собрать нужные данные. Автоматизация получает данные, видимые пользователю, через внутренние конечные точки приложения или отрисованные страницы.
- Записать структурированный результат. В итоге получаются и необработанный машиночитаемый файл, и читаемый человеком дайджест (рекомендуется).
4. Почему это работает
Многие веб-приложения устроены как браузерные клиенты, взаимодействующие с бэкенд-сервисами. Даже когда публичного API нет, сам браузер зачастую использует внутренние API, чтобы загрузить данные, показываемые в интерфейсе.
Это значит, что проще всего понять, как получить всю нужную информацию из системы, иногда можно, посмотрев, как сама система получает её для браузера.
Такова неудобная практическая реальность.
С технической точки зрения веб-приложение уже знает, где лежат данные, какие конечные точки используются, какие нужны параметры и как записи разбиваются на страницы или фильтруются. Извлечение с помощью браузера просто автоматизирует то, что пользователь мог бы сделать вручную, при условии что это остаётся в пределах его законных прав доступа.
5. «Взлом», который на самом деле не взлом
Среди инженеров и практиков автоматизации комплаенса ходит такая шутка:
Проще всего получить всю информацию из системы — «взломать» её.
В этом контексте «взлом» не означает несанкционированный доступ, эксплуатацию уязвимостей, повышение привилегий или обход мер безопасности. Он означает понимание того, как веб-приложение устроено изнутри, и использование этого знания для автоматизации процесса, который иначе выполнялся бы вручную.
Например, некоторые веб-приложения хранят в браузере временные артефакты сессии, чтобы фронтенд мог общаться с бэкенд-сервисами. В ряде случаев автоматизация может повторно использовать аутентифицированную сессию браузера, чтобы извлечь данные от имени пользователя.
Это может быть мощным приёмом, когда официального API нет или он неполон. Но и обращаться с ним нужно осторожно: данные сессии чувствительны и могут давать доступ, равный доступу вошедшего пользователя.
6. Правовое и договорное предупреждение
Такую автоматизацию нужно использовать с должной осторожностью.
Даже если у пользователя есть законное право на доступ к данным, веб-скрапинг с помощью браузера может нарушать лицензионное соглашение с конечным пользователем (EULA), условия использования, политику допустимого использования, договорные ограничения или политику безопасности.
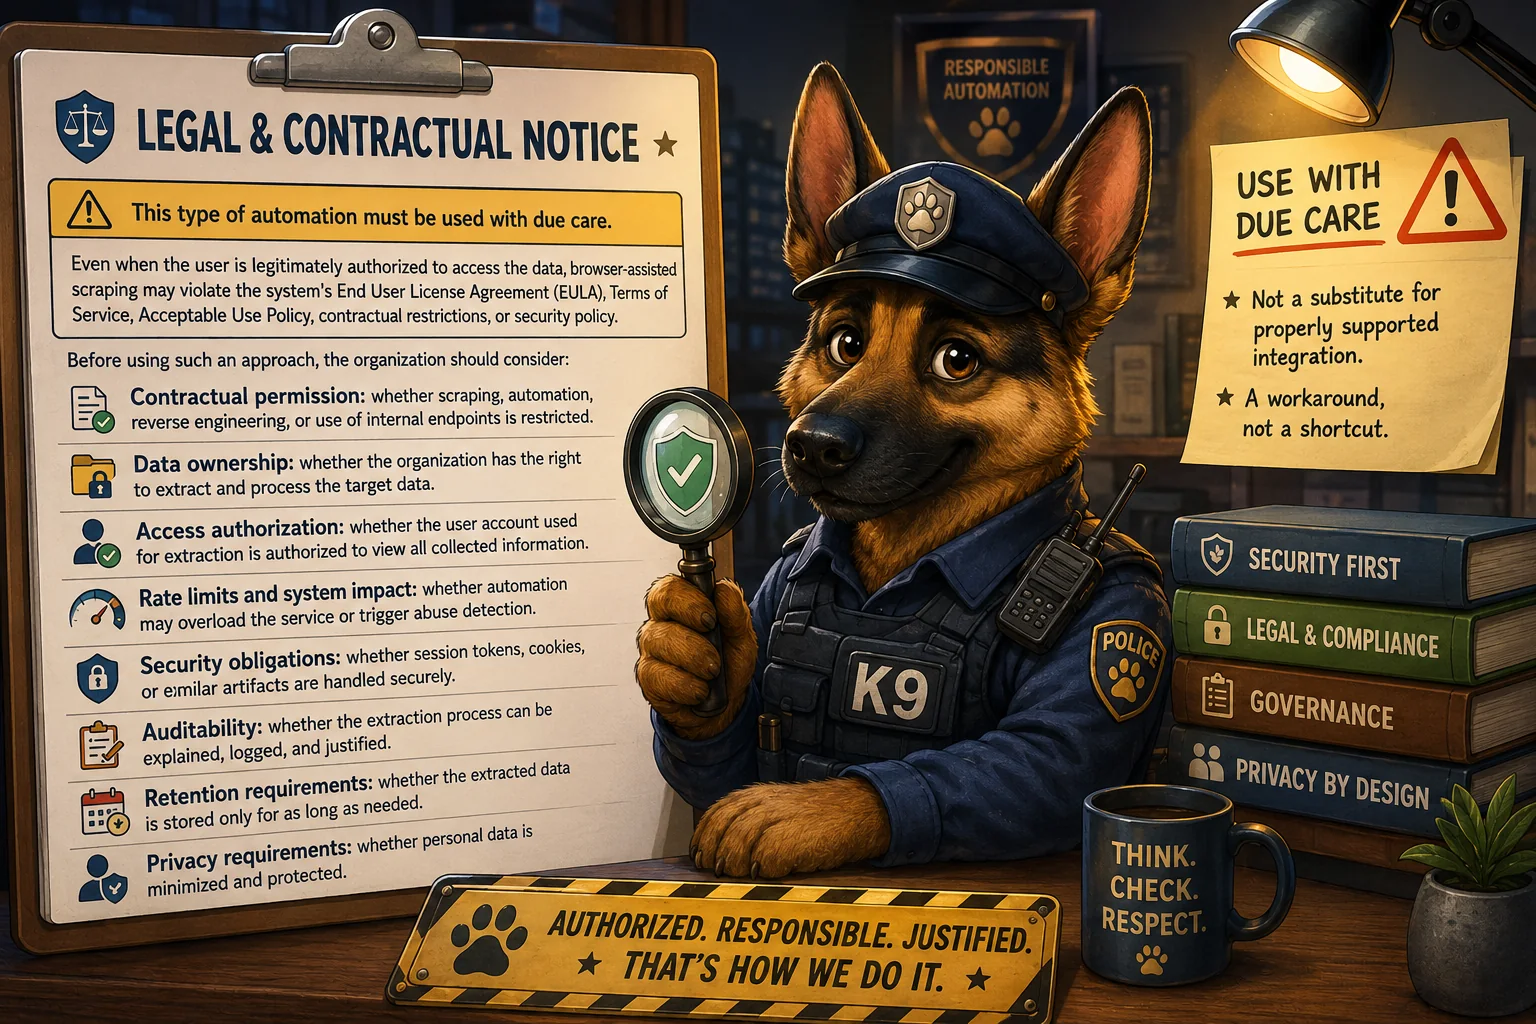
Прежде чем применять такой подход, организации стоит учесть:
- Договорное разрешение: не запрещены ли скрапинг, автоматизация, обратная разработка или использование внутренних конечных точек.
- Владение данными: есть ли у организации право извлекать и обрабатывать эти данные.
- Авторизация доступа: вправе ли учётная запись, используемая для извлечения, просматривать всю собираемую информацию.
- Лимиты запросов и влияние на систему: не может ли автоматизация перегрузить сервис или вызвать срабатывание защиты от злоупотреблений.
- Обязательства по безопасности: надёжно ли обрабатываются токены сессий, cookie и подобные артефакты.
- Возможность аудита: можно ли объяснить, зафиксировать в журнале и обосновать процесс извлечения.
- Требования к хранению: хранятся ли извлечённые данные только столько, сколько нужно.
- Требования к конфиденциальности: сведён ли к минимуму объём персональных данных и защищены ли они.
Этот приём нельзя применять походя. Это обходной путь, а не замена должным образом поддерживаемой интеграции.
7. Вопросы безопасности
Артефакты сессии, включая cookie и токены, нужно считать чувствительными учётными данными.
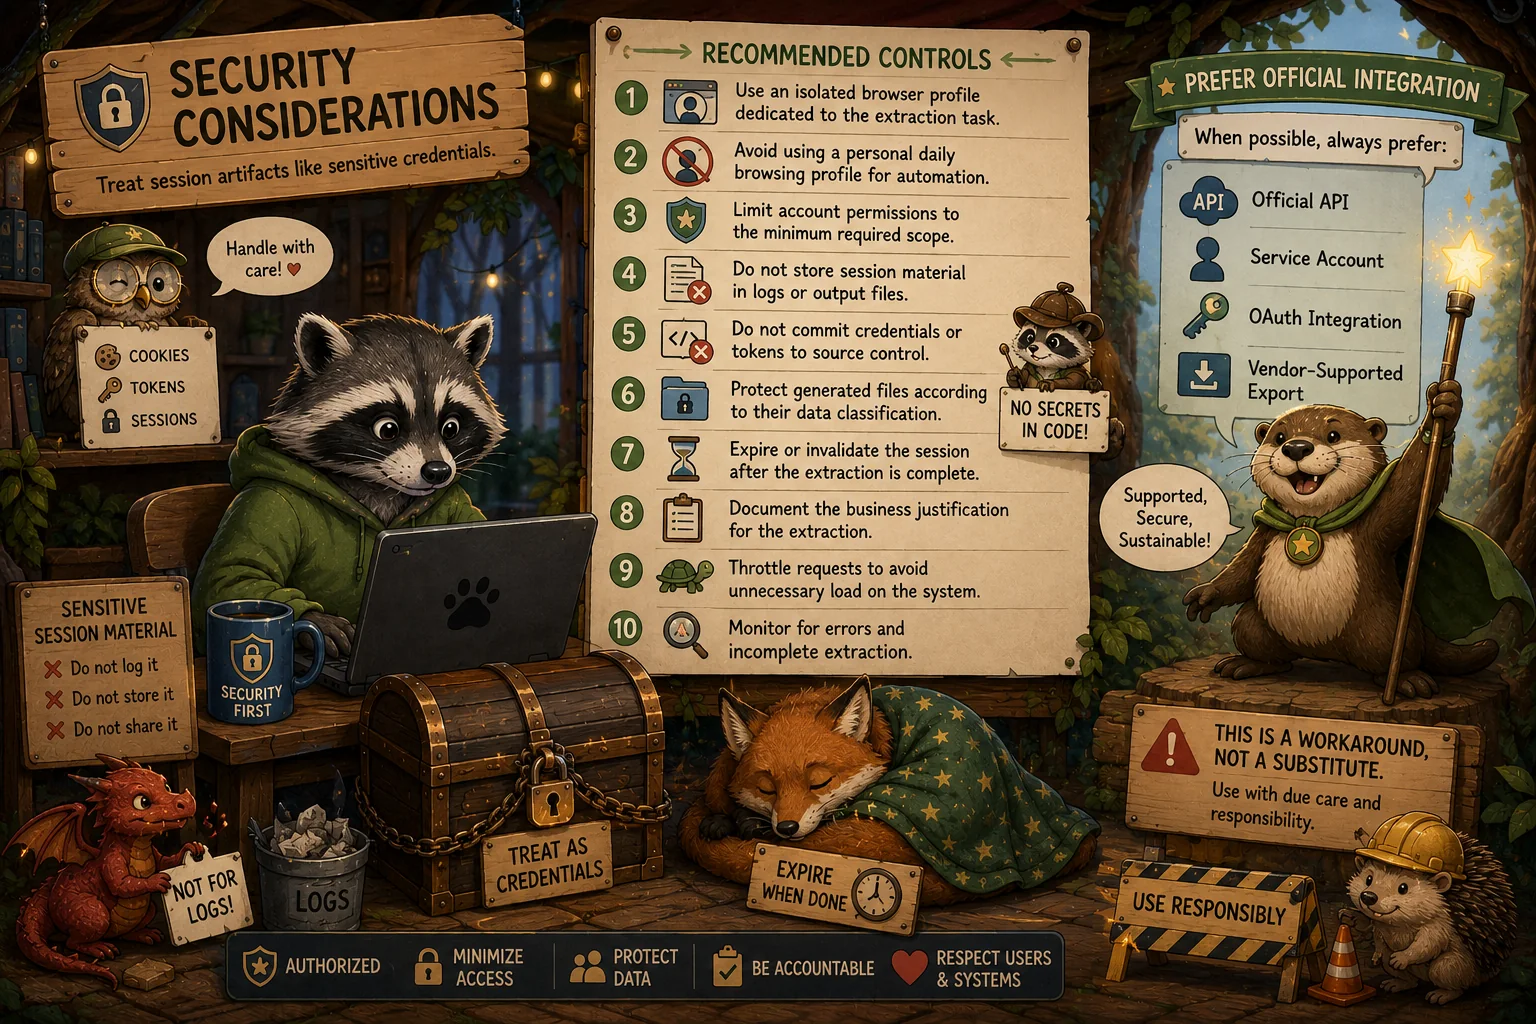
Если автоматизация опирается на аутентифицированную сессию, настоятельно рекомендуются следующие контроли:
- Использовать изолированный профиль браузера, выделенный для задачи извлечения.
- Не использовать для автоматизации личный повседневный профиль браузера.
- Ограничить права учётной записи минимально необходимым объёмом.
- Не сохранять данные сессии в журналах и выходных файлах.
- Не коммитить учётные данные и токены в систему контроля версий.
- Защищать создаваемые файлы в соответствии с классификацией данных.
- Завершать или аннулировать сессию после окончания извлечения.
- Задокументировать деловое обоснование извлечения.
- Ограничивать частоту запросов, чтобы не создавать лишнюю нагрузку на систему.
- Следить за ошибками и неполным извлечением.
Где возможно, всегда следует отдавать предпочтение официальному API, сервисной учётной записи, интеграции OAuth или поддерживаемому вендором механизму экспорта.
8. Пример теоретического сценария использования
Допустим, компании нужно извлечь записи из внутренней SaaS-платформы для проверки на соответствие требованиям.
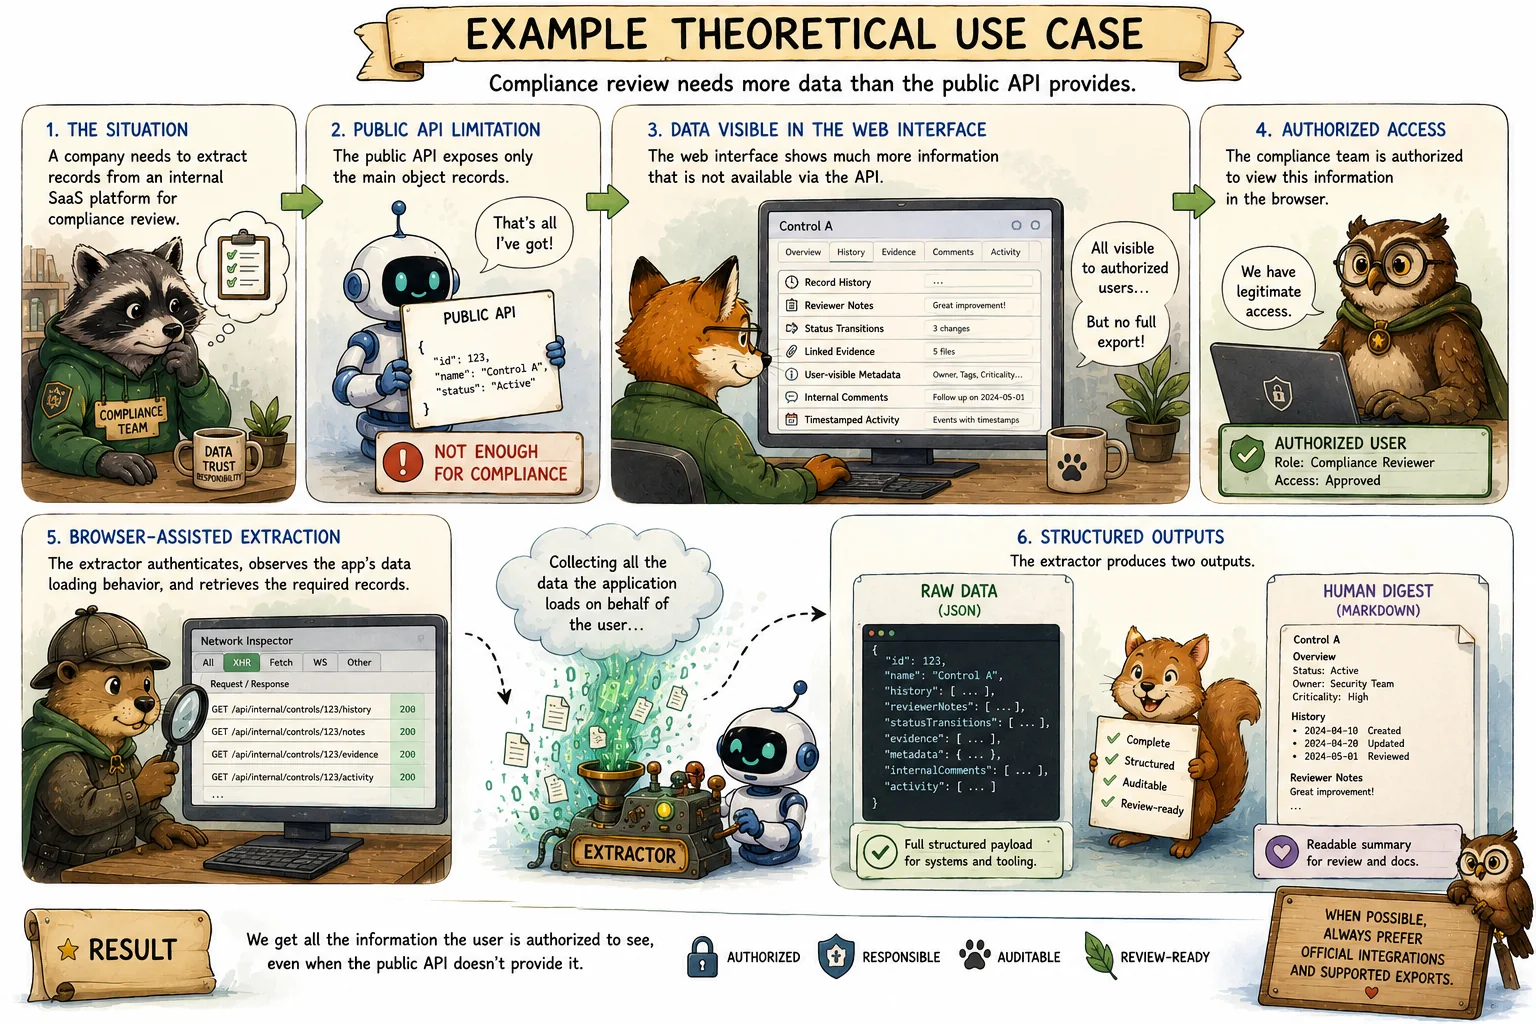
Публичный API отдаёт только основные записи объектов, а веб-интерфейс показывает дополнительную информацию, например:
- История записи
- Заметки ревьюера
- Переходы между статусами
- Связанные доказательства
- Метаданные, видимые пользователю
- Внутренние комментарии
- Действия с отметками времени
Команда по комплаенсу вправе просматривать эту информацию в браузере, но полноценной функции экспорта нет.
Извлекатель на основе браузера может аутентифицироваться как уполномоченный пользователь, понаблюдать за тем, как приложение само загружает данные, получить нужные записи и сформировать два результата. Файл JSON сохраняет полные структурированные данные. Файл Markdown даёт читаемую версию, пригодную для проверки и документирования.
9. Ответственное использование
Веб-скрапинг с помощью браузера может быть законным, когда с его помощью получают данные, на доступ к которым у пользователя уже есть право, и когда подходящего официального механизма экспорта нет.
Однако его следует рассматривать как инженерное решение для исключительных случаев. Перед применением его нужно проверить с правовой точки зрения, а также с точек зрения безопасности, конфиденциальности и эксплуатации.
Лучший исход — по-прежнему API, поддерживаемый вендором. Но когда API нет или его недостаточно, аккуратно контролируемое извлечение с помощью браузера может стать практическим мостом между ручной работой и полноценной интеграцией.
10. Заключение
Системы без достаточных API создают трения для комплаенса, аудита, отчётности, миграции и операционной автоматизации. В таких случаях извлечение данных с помощью браузера может стать прагматичным обходным путём.
Главный принцип прост: автоматизировать только то, к чему пользователь вправе иметь доступ, защищать данные сессии как учётные данные, не собирать лишнего, соблюдать договорные ограничения и документировать обоснование.
При ответственном использовании этот подход способен превратить иначе ручной и ненадёжный процесс в повторяемый, структурированный и пригодный для аудита.
Эта страница — полная копия истории в том виде, в каком она опубликована на Medium. Читать на Medium. Иллюстрации созданы с помощью ИИ.