
Medium · Automatisierung, Web Scraping · Entwurf
Wenn die API nicht genügt: browsergestützte Datenextraktion im Auftrag des Nutzers
Moderne SaaS-Plattformen bieten oft öffentliche APIs. In der Theorie sollte das Integrationen, Berichtswesen, die Erhebung von Compliance-Nachweisen, Analysen und Automatisierung einfach machen.
Zuerst auf Medium veröffentlicht am 26. Mai 2026. Auf Medium lesen. 8 Min. Lesezeit.
In der Praxis genügt die verfügbare API nicht immer:
- Manchmal gibt es keine öffentliche API.
- Manchmal gibt es sie, aber sie legt nur einen begrenzten Teil der Daten offen.
- Manchmal sind die Daten in der Webanwendung sichtbar, aber über dokumentierte Endpunkte nicht verfügbar.
- Und manchmal beschränkt sich die Exportfunktion auf eine CSV-Datei, die die Metadaten, Beziehungen, Kommentare, den Verlauf oder die Audit-Spur nicht enthält, die für einen legitimen geschäftlichen Zweck nötig sind.
Das schafft ein praktisches Problem: Der Nutzer ist berechtigt, auf die Informationen zuzugreifen, die Informationen sind in der Anwendung sichtbar, aber es gibt keinen angemessenen offiziellen Mechanismus, sie strukturiert und wiederholbar abzurufen.
In solchen Fällen kann die Browser-gestützte Datenextraktion ein praktischer Behelf sein.
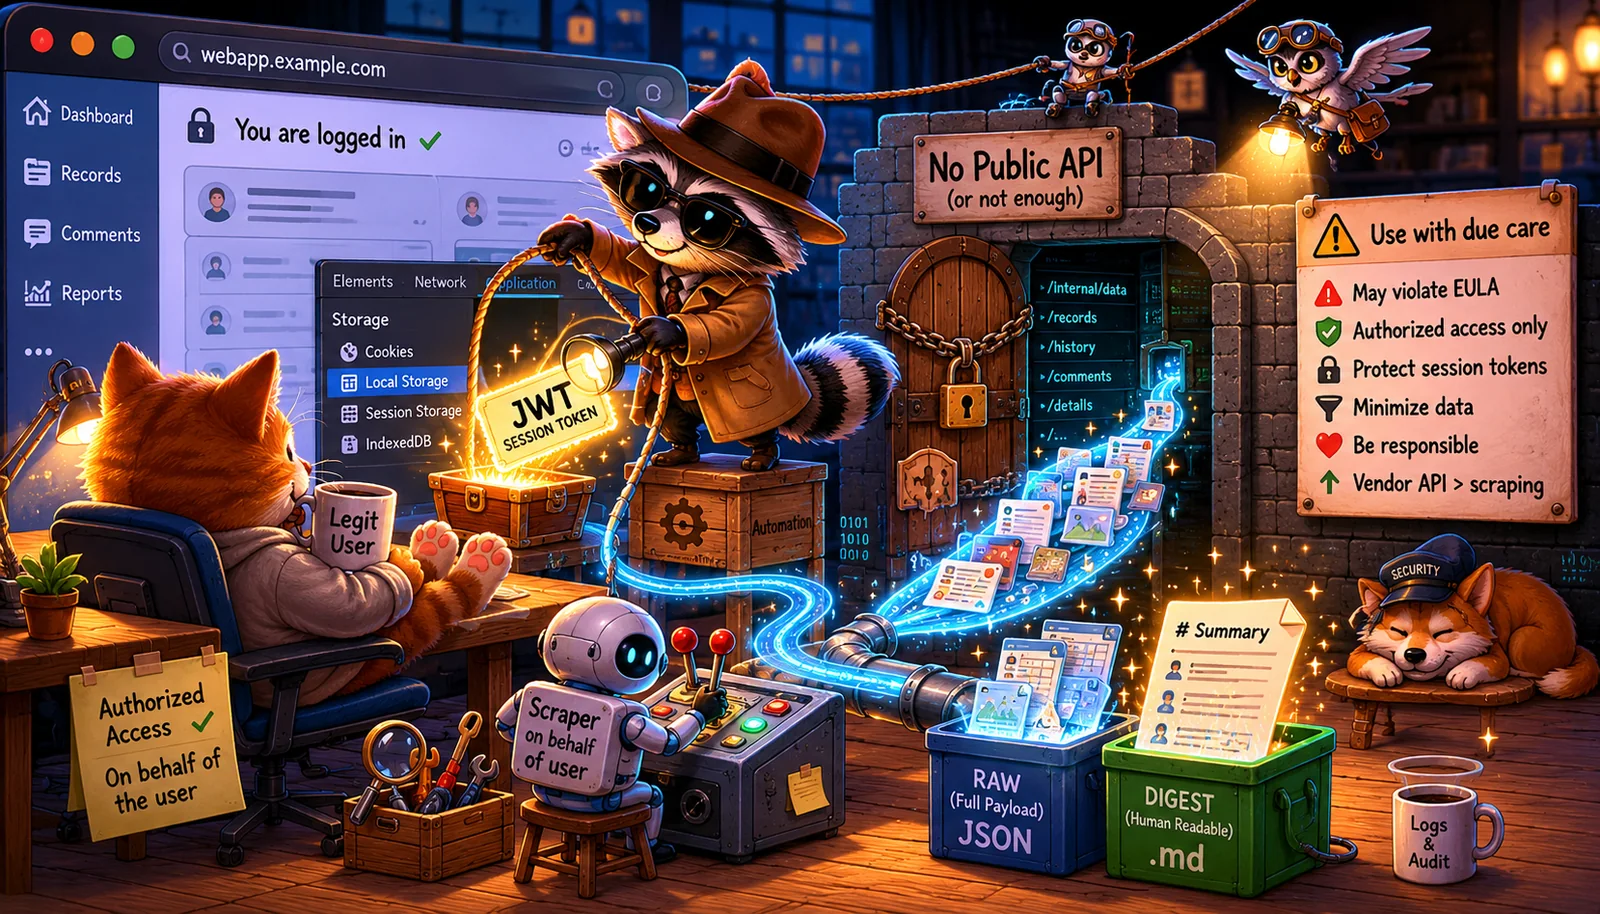
1. Keine Robotic Process Automation (RPA)
Dieser Ansatz kann Robotic Process Automation (RPA) ähneln, ist aber nicht ganz dasselbe.
Klassische RPA ahmt meist die Benutzeroberfläche nach: Sie klickt Schaltflächen, füllt Formulare aus, scrollt Seiten, wartet, bis Bildschirme geladen sind, und liest sichtbare Elemente aus. Sie behandelt die Webanwendung als visuellen Arbeitsplatz und automatisiert dieselben Schritte, die ein Mensch von Hand ausführen würde.
Die Browser-gestützte Extraktion arbeitet auf einer anderen Ebene. Der Browser dient weiterhin der legitimen Authentifizierung und Zugriffskontrolle des Nutzers, aber die eigentliche Datenerhebung geschieht, indem die Kommunikation der Anwendung mit ihrem Backend beobachtet und wiederverwendet wird. Statt Werte vom Bildschirm abzuschreiben, ruft die Automatisierung strukturierte Daten ab, die die Anwendung ohnehin empfängt, um den Bildschirm darzustellen.
Einfach gesagt:
- RPA automatisiert, was der Nutzer auf der Seite tut.
- Browser-gestützte Extraktion automatisiert, was die Seite im Auftrag des Nutzers im Hintergrund tut.
Diese Unterscheidung ist wichtig. Die Browser-gestützte Extraktion ist meist stabiler, schneller und vollständiger als visuelle UI-Automatisierung, weil sie mit strukturierten Payloads statt mit dargestellten Oberflächenelementen arbeiten kann. Zugleich erfordert sie mehr Sorgfalt, weil sie auf internem Anwendungsverhalten, nicht dokumentierten Endpunkten, Cookies, Session Storage, Local Storage oder anderen sitzungsbezogenen Artefakten beruhen kann.
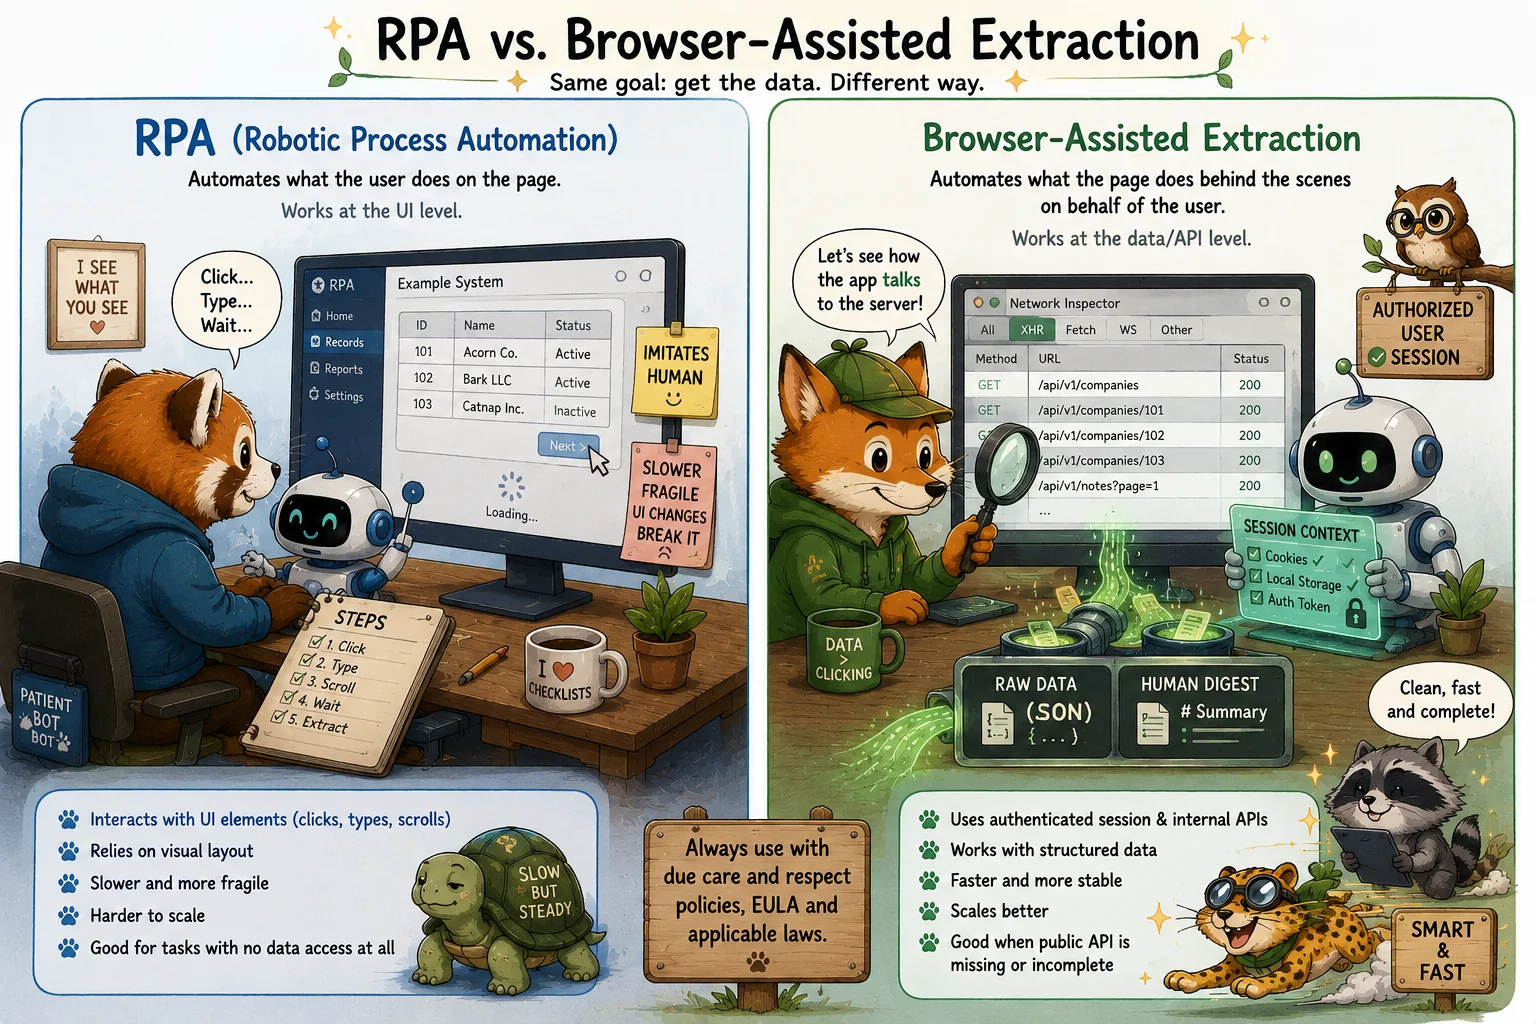
Deshalb sollte dieses Muster als kontrollierter Behelf behandelt werden. Es ist kein Ersatz für eine offizielle API, eine unterstützte Integration oder eine ordentlich dokumentierte Exportfunktion. Es ist näher an „API-Erkundung über die authentifizierte Browser-Sitzung“ als an klassischer RPA.
Das Prinzip bleibt dasselbe: Die Automatisierung darf nur im Auftrag eines berechtigten Nutzers handeln, nur Daten erheben, auf die der Nutzer zugreifen darf, und muss unter Beachtung rechtlicher, vertraglicher, datenschutzrechtlicher und sicherheitsbezogener Aspekte eingesetzt werden.
2. Das Szenario
Angenommen, ein Unternehmen nutzt ein System für Governance, Compliance, Betrieb oder interne Verwaltung.
Das System hat eine Weboberfläche. Berechtigte Nutzer können sich anmelden, durch Datensätze navigieren, Details ansehen und Informationen von Hand exportieren oder kopieren. Allerdings hat das System eine der folgenden Einschränkungen:
- Es gibt keine öffentliche API.
- Die öffentliche API ist unvollständig und legt nicht alle benötigten Daten offen.
- Die Exportfunktion genügt nicht für Geschäfts-, Audit-, Migrations- oder Berichtszwecke.
- Wichtige Metadaten sind im Browser sichtbar, aber über dokumentierte Integrationswege nicht verfügbar.
- Die manuelle Extraktion wäre langsam, fehleranfällig und schwer reproduzierbar.
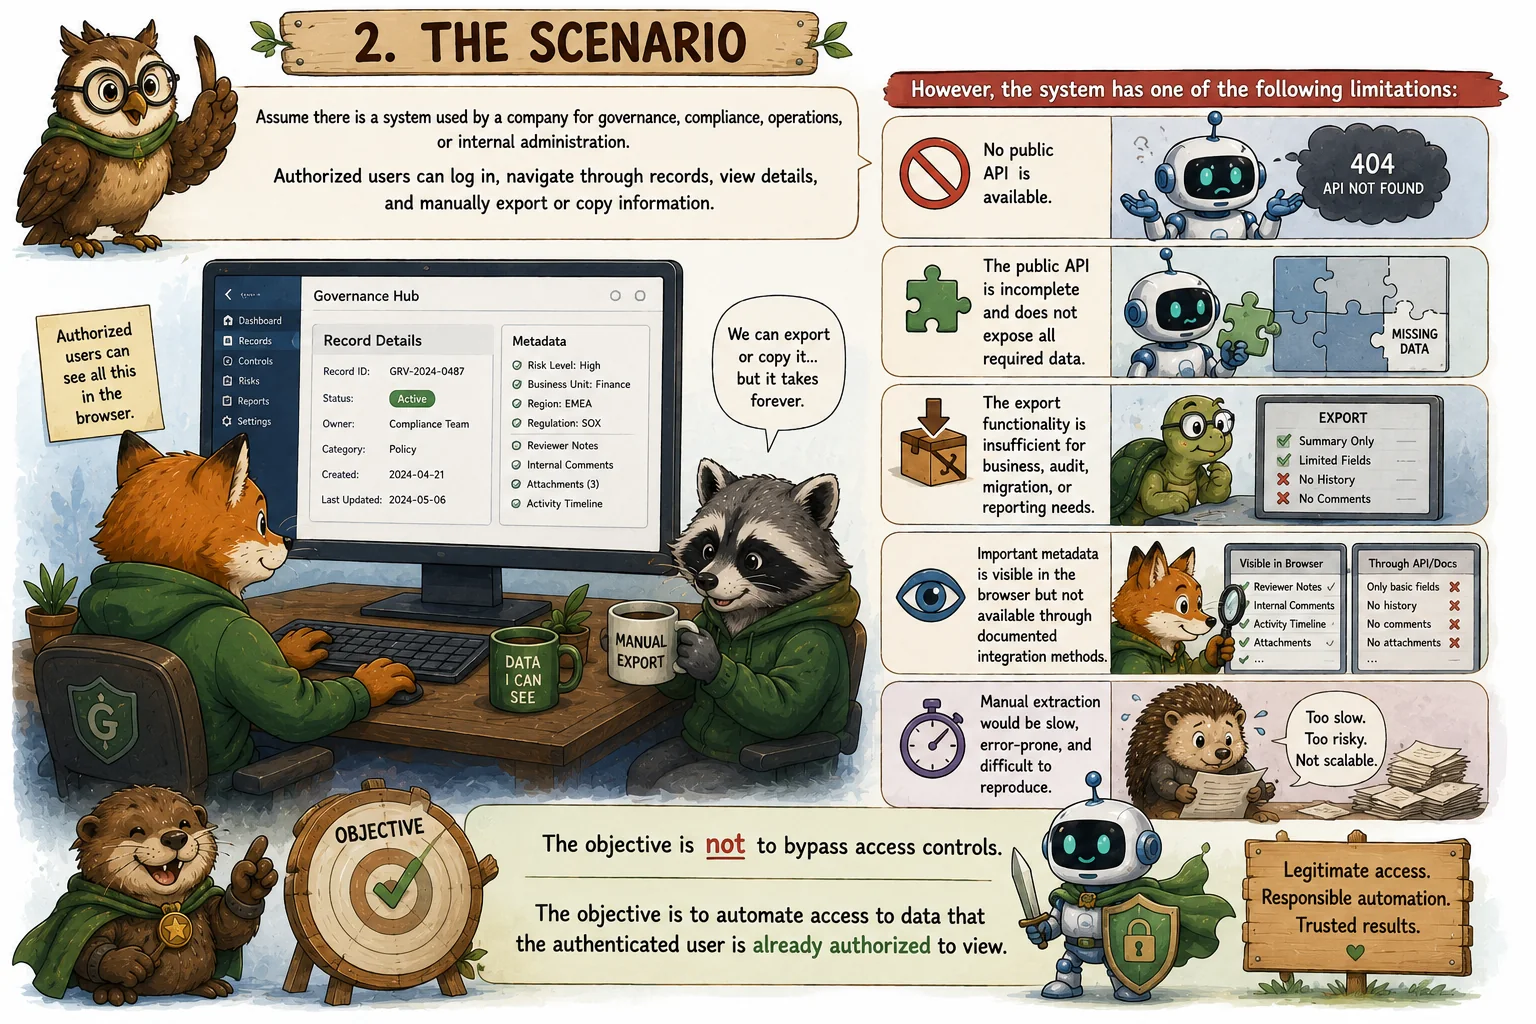
Das Ziel ist nicht, Zugriffskontrollen zu umgehen. Das Ziel ist, den Zugriff auf Daten zu automatisieren, die der authentifizierte Nutzer ohnehin einsehen darf.
3. Der allgemeine Ansatz
Das allgemeine Muster ist Browser-gestütztes Scraping im Auftrag des Nutzers.
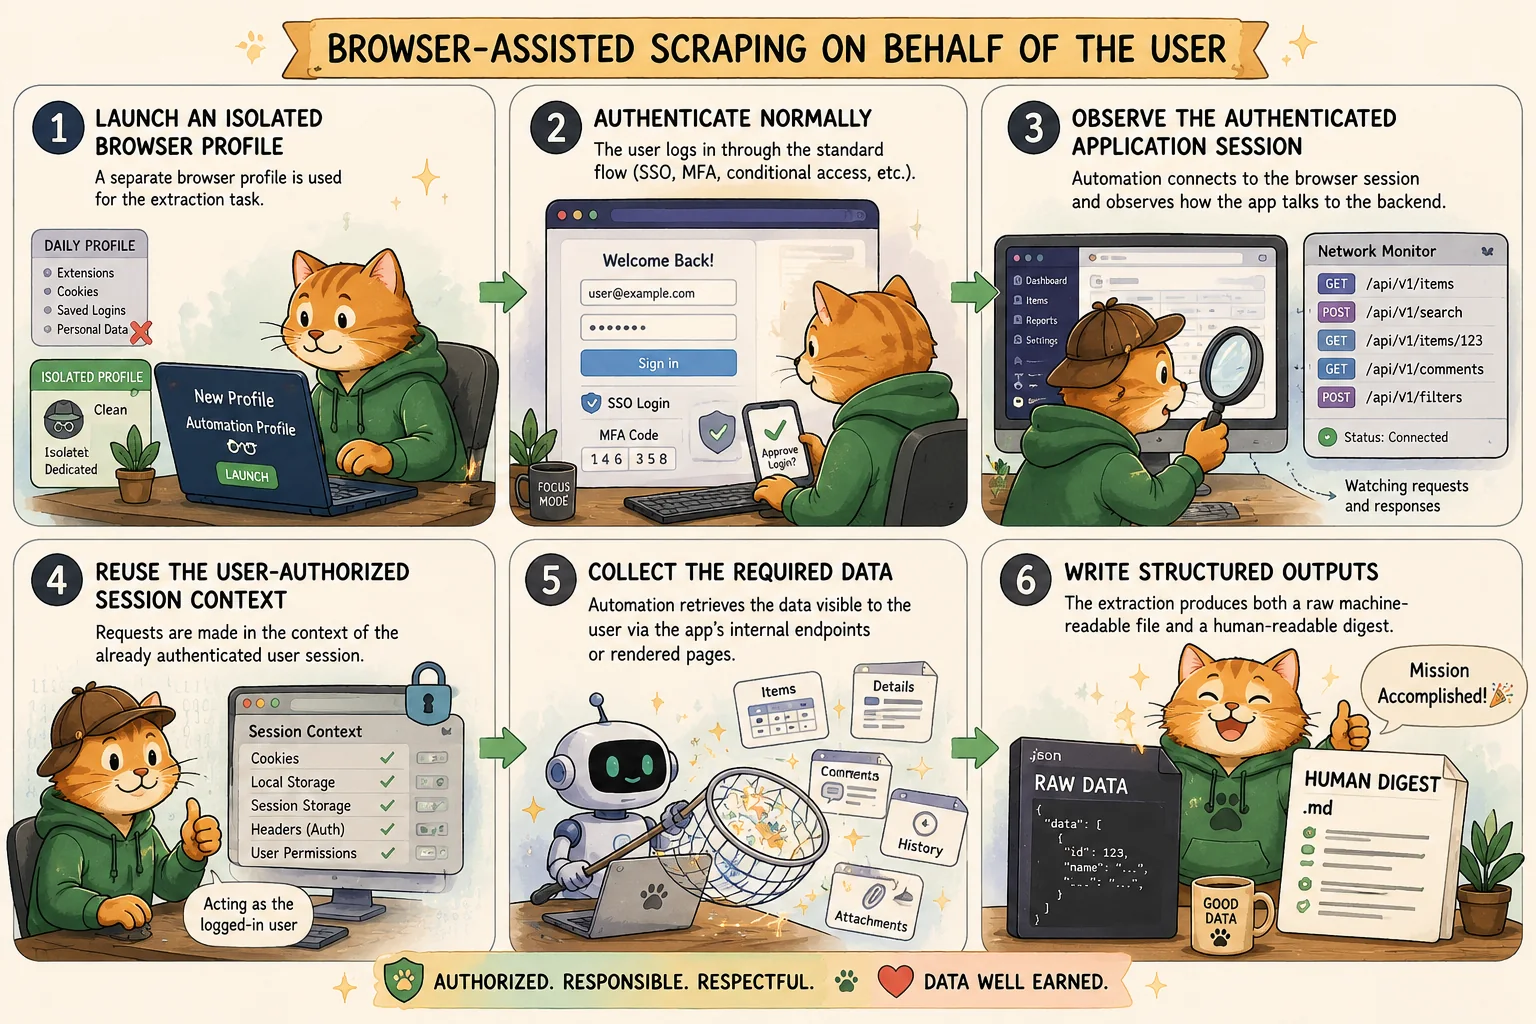
Ein typischer Ablauf kann so aussehen:
- Ein isoliertes Browserprofil starten. Für die Extraktionsaufgabe wird ein separates Browserprofil verwendet. So vermischt sich die Automatisierungssitzung nicht mit dem täglichen Browserprofil des Nutzers, seinen Erweiterungen, gespeicherten Zugangsdaten, fremden Cookies und privaten Sitzungen.
- Normal authentifizieren. Der Nutzer meldet sich über die reguläre Weboberfläche mit dem üblichen Authentifizierungsablauf an, einschließlich SSO, MFA, bedingtem Zugriff oder anderen vom System geforderten Kontrollen.
- Die authentifizierte Anwendungssitzung beobachten. Nach der Authentifizierung verbindet sich die Automatisierung mit der Browser-Sitzung und beobachtet, wie die Webanwendung mit ihrem Backend kommuniziert.
- Den vom Nutzer autorisierten Sitzungskontext wiederverwenden. Die Automatisierung führt Anfragen im Kontext der bereits authentifizierten Nutzersitzung aus. In manchen Systemen kann relevantes Sitzungsmaterial in browserzugänglichen Speichermechanismen liegen, etwa in Cookies, Session Storage oder Local Storage.
- Die benötigten Daten erheben. Die Automatisierung ruft die Daten, die der Nutzer sehen darf, über die internen Endpunkte der Anwendung oder die dargestellten Seiten ab.
- Strukturierte Ausgaben schreiben. Die Extraktion erzeugt sowohl eine maschinenlesbare Rohdatei als auch eine für Menschen lesbare Zusammenfassung (empfohlen).
4. Warum das funktioniert
Viele Webanwendungen sind als browserbasierte Clients gebaut, die mit Backend-Diensten kommunizieren. Auch wenn es keine öffentliche API gibt, nutzt der Browser selbst oft interne APIs, um die in der Oberfläche gezeigten Daten zu laden.
Das heißt: Der einfachste Weg zu verstehen, wie man alle relevanten Informationen aus einem System bekommt, besteht manchmal darin, nachzusehen, wie das System sie selbst für den Browser abruft.
Das ist die unbequeme praktische Wirklichkeit.
Technisch gesehen weiß die Webanwendung bereits, wo die Daten liegen, welche Endpunkte verwendet werden, welche Parameter nötig sind und wie Datensätze paginiert oder gefiltert werden. Die Browser-gestützte Extraktion automatisiert schlicht, was der Nutzer sonst von Hand tun könnte, solange sie innerhalb seiner legitimen Zugriffsrechte bleibt.
5. Der „Hack“, der gar keiner ist
Unter Ingenieuren und Praktikern der Compliance-Automatisierung gibt es einen verbreiteten Scherz:
Der einfachste Weg, an alle Informationen aus einem System zu kommen, ist, es zu „hacken“.
In diesem Zusammenhang soll „hacken“ nicht unbefugten Zugriff, Ausnutzung von Schwachstellen, Rechteausweitung oder die Umgehung von Sicherheitskontrollen bedeuten. Es heißt, zu verstehen, wie die Webanwendung intern funktioniert, und dieses Wissen zu nutzen, um einen sonst manuellen Vorgang zu automatisieren.
Zum Beispiel speichern manche Webanwendungen temporäre Sitzungsartefakte im Browser, damit das Frontend mit Backend-Diensten kommunizieren kann. In manchen Fällen kann die Automatisierung die authentifizierte Browser-Sitzung wiederverwenden, um im Auftrag des Nutzers Daten zu extrahieren.
Das kann eine mächtige Technik sein, wenn eine offizielle API fehlt oder unvollständig ist. Es ist auch eine Technik, die mit Vorsicht zu handhaben ist, weil Sitzungsmaterial sensibel ist und einen Zugriff ermöglichen kann, der dem des angemeldeten Nutzers gleichkommt.
6. Rechtlicher und vertraglicher Hinweis
Diese Art der Automatisierung muss mit gebührender Sorgfalt eingesetzt werden.
Selbst wenn der Nutzer berechtigt ist, auf die Daten zuzugreifen, kann Browser-gestütztes Scraping gegen den Endnutzer-Lizenzvertrag (EULA), die Nutzungsbedingungen, die Richtlinie zur akzeptablen Nutzung, vertragliche Beschränkungen oder die Sicherheitsrichtlinie des Systems verstoßen.
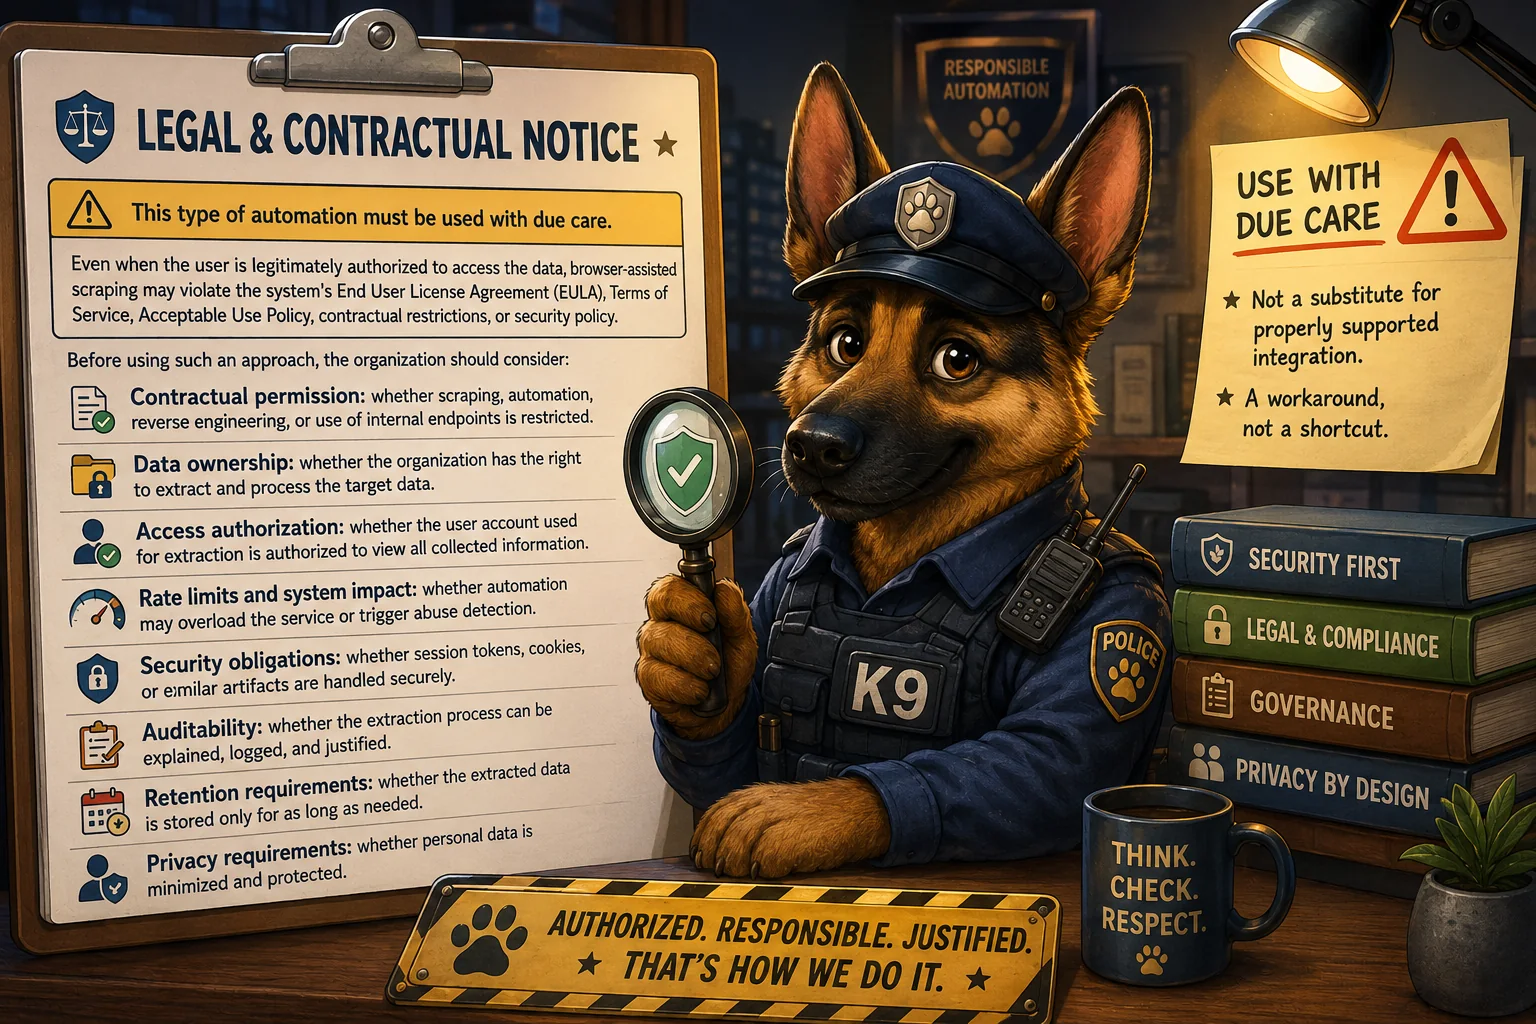
Bevor ein solcher Ansatz genutzt wird, sollte die Organisation Folgendes bedenken:
- Vertragliche Erlaubnis: ob Scraping, Automatisierung, Reverse Engineering oder die Nutzung interner Endpunkte eingeschränkt ist.
- Dateneigentum: ob die Organisation das Recht hat, die Zieldaten zu extrahieren und zu verarbeiten.
- Zugriffsberechtigung: ob das für die Extraktion verwendete Nutzerkonto berechtigt ist, alle erhobenen Informationen einzusehen.
- Ratenlimits und Auswirkungen auf das System: ob die Automatisierung den Dienst überlasten oder die Missbrauchserkennung auslösen kann.
- Sicherheitspflichten: ob Sitzungstokens, Cookies oder ähnliche Artefakte sicher gehandhabt werden.
- Nachvollziehbarkeit: ob sich der Extraktionsprozess erklären, protokollieren und begründen lässt.
- Aufbewahrungsanforderungen: ob die extrahierten Daten nur so lange gespeichert werden, wie nötig.
- Datenschutzanforderungen: ob personenbezogene Daten minimiert und geschützt werden.
Dieses Muster sollte nicht leichtfertig eingesetzt werden. Es ist ein Behelf, kein Ersatz für eine ordentlich unterstützte Integration.
7. Sicherheitsaspekte
Sitzungsartefakte, einschließlich Cookies und Tokens, müssen wie sensible Zugangsdaten behandelt werden.
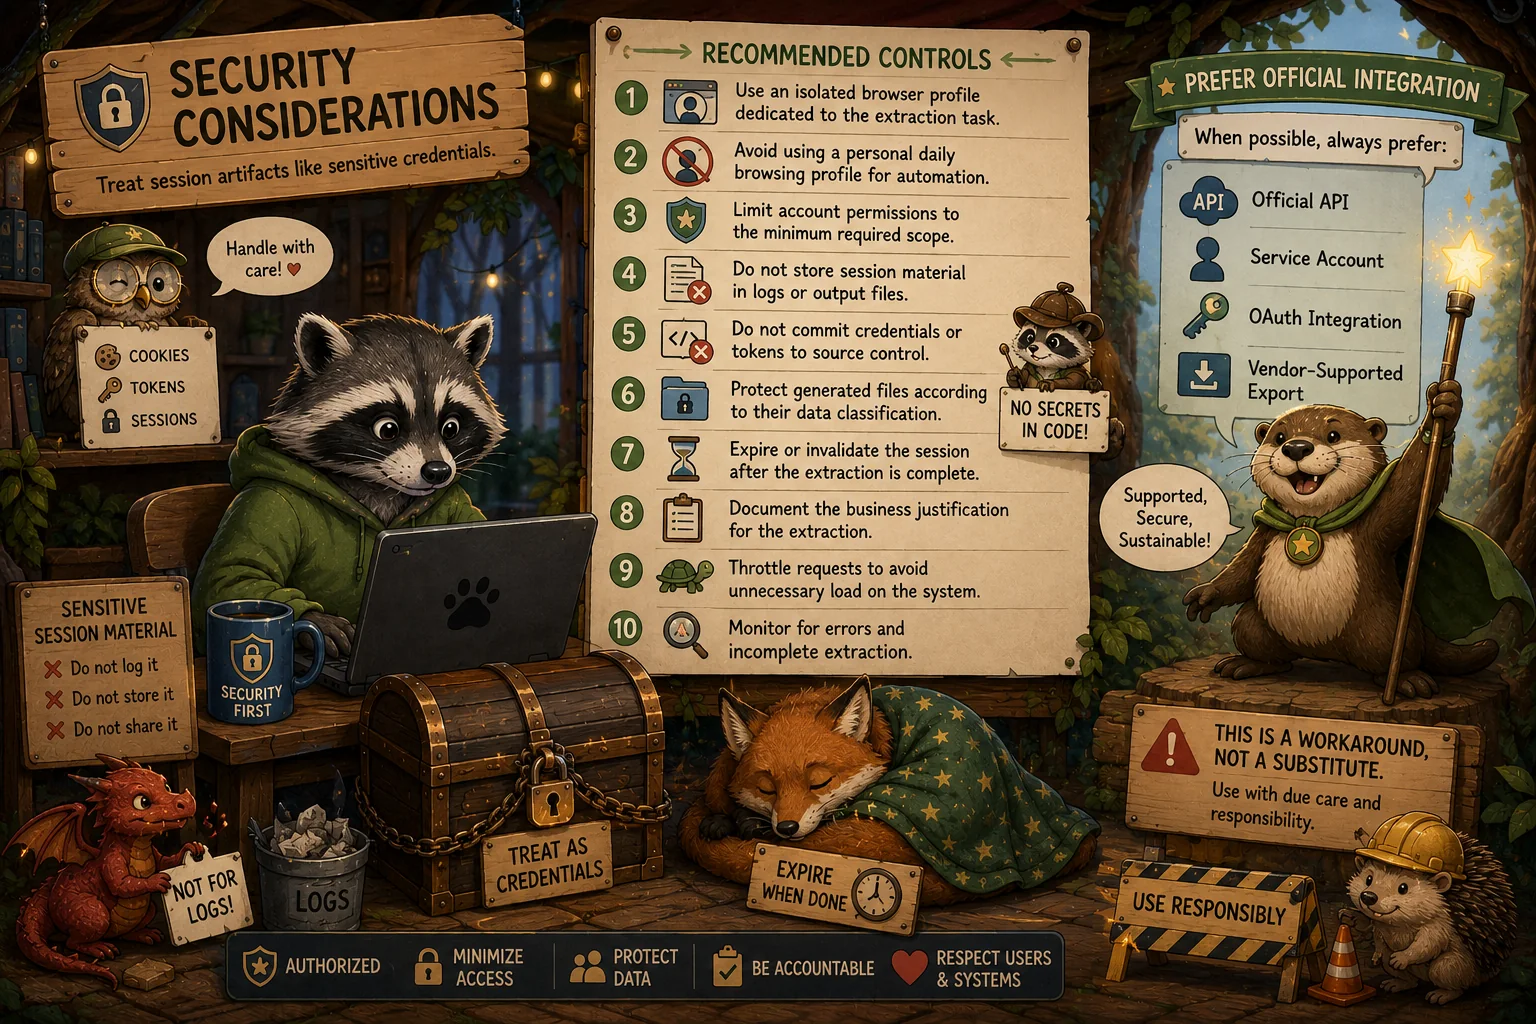
Stützt sich die Automatisierung auf eine authentifizierte Sitzung, werden die folgenden Kontrollen dringend empfohlen:
- Ein isoliertes Browserprofil verwenden, das der Extraktionsaufgabe vorbehalten ist.
- Kein persönliches Alltags-Browserprofil für die Automatisierung verwenden.
- Die Kontoberechtigungen auf den erforderlichen Mindestumfang beschränken.
- Kein Sitzungsmaterial in Logs oder Ausgabedateien speichern.
- Keine Zugangsdaten oder Tokens in die Versionsverwaltung einchecken.
- Erzeugte Dateien entsprechend ihrer Datenklassifizierung schützen.
- Die Sitzung ablaufen lassen oder ungültig machen, sobald die Extraktion abgeschlossen ist.
- Die geschäftliche Begründung der Extraktion dokumentieren.
- Anfragen drosseln, um unnötige Last auf dem System zu vermeiden.
- Auf Fehler und unvollständige Extraktion achten.
Wo möglich, sollte stets eine offizielle API, ein Servicekonto, eine OAuth-Integration oder ein vom Anbieter unterstützter Exportmechanismus bevorzugt werden.
8. Ein theoretischer Beispielfall
Angenommen, ein Unternehmen muss für eine Compliance-Prüfung Datensätze aus einer internen SaaS-Plattform extrahieren.
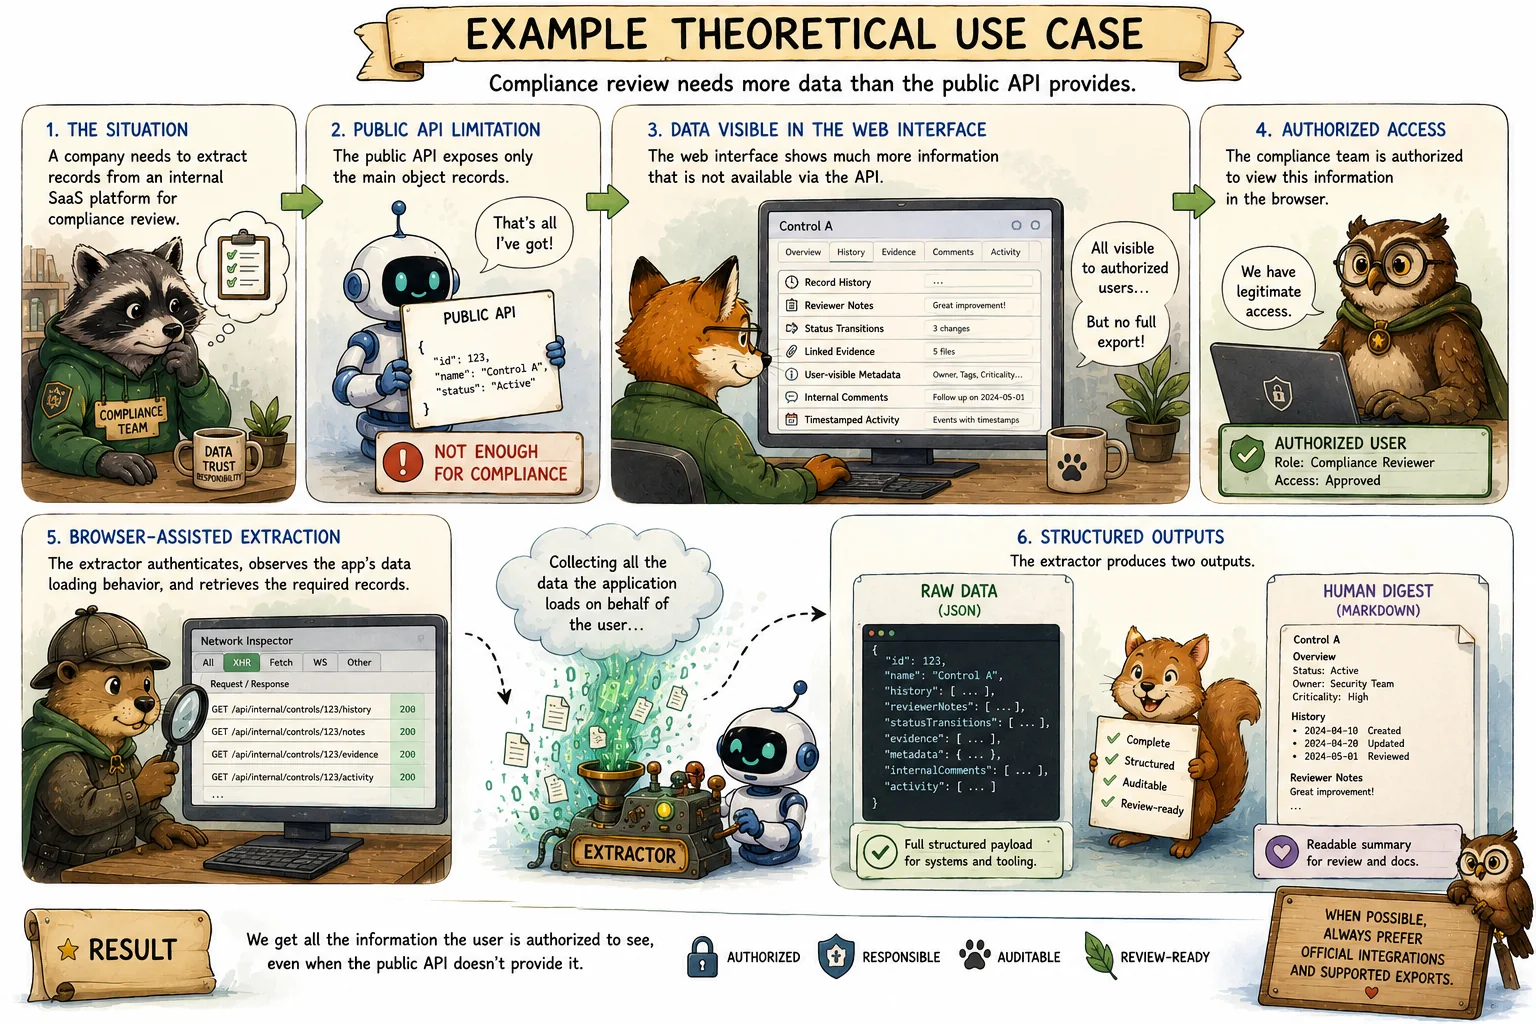
Die öffentliche API legt nur die Hauptobjekt-Datensätze offen, aber die Weboberfläche zeigt zusätzliche Informationen, zum Beispiel:
- Datensatzverlauf
- Notizen der Prüfer
- Statusübergänge
- Verknüpfte Nachweise
- Für Nutzer sichtbare Metadaten
- Interne Kommentare
- Aktivitäten mit Zeitstempel
Das Compliance-Team darf diese Informationen im Browser einsehen, aber es gibt keine vollständige Exportfunktion.
Ein Browser-gestützter Extraktor kann sich als der berechtigte Nutzer authentifizieren, das Datenladeverhalten der Anwendung selbst beobachten, die benötigten Datensätze abrufen und zwei Ausgaben erzeugen. Die JSON-Datei bewahrt die vollständige strukturierte Payload. Die Markdown-Datei liefert eine lesbare Fassung, die sich für Prüfung und Dokumentation eignet.
9. Verantwortungsvoller Einsatz
Browser-gestütztes Scraping kann legitim sein, wenn damit Daten abgerufen werden, auf die der Nutzer ohnehin zugreifen darf, und wenn es keinen angemessenen offiziellen Exportmechanismus gibt.
Es sollte jedoch als Ingenieurlösung für Ausnahmefälle behandelt werden. Vor dem Einsatz sollte es aus rechtlicher, sicherheitsbezogener, datenschutzrechtlicher und betrieblicher Sicht geprüft werden.
Das beste Ergebnis bleibt eine vom Anbieter unterstützte API. Fehlt die API aber oder genügt sie nicht, kann sorgfältig kontrollierte Browser-gestützte Extraktion eine praktische Brücke zwischen Handarbeit und ordentlicher Integration schlagen.
10. Fazit
Systeme ohne ausreichende APIs erzeugen Reibung bei Compliance, Audit, Berichtswesen, Migration und betrieblicher Automatisierung. In solchen Fällen kann Browser-gestützte Datenextraktion ein pragmatischer Behelf sein.
Das Grundprinzip ist einfach: nur automatisieren, was der Nutzer legitim einsehen darf, Sitzungsmaterial wie Zugangsdaten schützen, unnötige Datenerhebung vermeiden, vertragliche Beschränkungen respektieren und die Begründung dokumentieren.
Verantwortungsvoll eingesetzt, kann dieser Ansatz einen sonst manuellen und unzuverlässigen Vorgang in einen wiederholbaren, strukturierten und prüfbaren Ablauf verwandeln.
Diese Seite ist eine vollständige Kopie des auf Medium veröffentlichten Beitrags. Auf Medium lesen. Illustrationen mit KI generiert.