
Medium · Inteligencia artificial, Ciberseguridad · Borrador
Primero los controles estrictos: lo que los agentes de programación con IA nos enseñan sobre la seguridad real
Los skills, los prompts y los archivos de políticas ayudan. Lo que realmente reduce el riesgo son el sandboxing, la segregación, las aprobaciones y los controles clásicos de ingeniería.
Publicado por primera vez en Medium el 27 de marzo de 2026. Léalo en Medium. 9 min de lectura.
En resumen:
Los agentes de IA no necesitan mala intención para provocar malos resultados. Un prompt cuidadoso, un
CLAUDE.mdpulido y buenos skills pueden reducir los errores, pero no crean seguridad si el entorno sigue dándole al agente demasiado poder. Lo que importa no es con qué cortesía se instruye al sistema, sino lo que técnicamente se le permite leer, modificar, ejecutar y alcanzar. La protección real viene de controles estrictos como el sandboxing, las compuertas de aprobación, el aislamiento, la minimización de credenciales y una segregación adecuada respecto de producción. Dicho de otro modo: los controles blandos pueden orientar el comportamiento, pero son los controles estrictos los que deciden si un error se queda en lo local o se convierte en un incidente.
Aviso: Este artículo se ha pulido con la ayuda de ChatGPT. Los juicios finales, las opiniones y las conclusiones son míos.
El problema
El debate sobre los agentes de programación con IA suele empezar por el lugar equivocado. Se pone el foco en los prompts, los archivos de instrucciones, los skills y los documentos de políticas locales, como si ahí estuviera la frontera de seguridad. No lo está. Son orientación. La frontera real es técnica: lo que el agente puede leer, escribir, ejecutar y alcanzar a través de la red. Tanto OpenAI como Anthropic describen el sandboxing, los límites del sistema de archivos, los controles de red y las políticas de aprobación como los mecanismos que de verdad acotan el comportamiento de un agente. (OpenAI Developers)
Las instrucciones no son fronteras de seguridad. La frontera real es lo que el entorno impide técnicamente.
Esa distinción importa porque la unidad peligrosa rara vez es el comando visible. Una invocación de bash puede parecer inofensiva mientras el script que hay detrás borra archivos, modifica código fuente, enumera credenciales o llama a endpoints externos. La documentación de Codex de OpenAI plantea el sandboxing en torno a los comandos locales y su entorno de ejecución restringido, en lugar de dar por seguro un comando solo porque, a primera vista, el envoltorio parezca benigno. (OpenAI Developers)
El comando de shell visible suele ser la parte menos importante del riesgo. Lo que cuenta es todo lo que ese comando puede ejecutar a continuación.
Modelo de seguridad
Un modelo de seguridad práctico para los agentes de programación con IA tiene al menos cuatro capas.
- La primera es puramente daño local: romper el entorno de desarrollo, borrar archivos, corromper ramas o envenenar dependencias. Es sobre todo un problema de disponibilidad. Duele, pero con control de versiones, instantáneas y copias de seguridad suele poder superarse.
- La segunda es la actividad local que provoca una exfiltración externa de datos. Es más grave, porque la pérdida de confidencialidad suele ser duradera una vez que los secretos, los documentos o el código salen de la máquina.
- La tercera es el compromiso local con implicaciones internas remotas: acceso a claves SSH, sesiones de navegador, tokens de nube o planos de control internos. A partir de ahí, el impacto se extiende a la confidencialidad, la integridad y la disponibilidad de varios sistemas, no solo de un portátil.
- La cuarta es la contaminación del código: cambios inseguros, engañosos o mal entendidos que se introducen en repositorios, pipelines, definiciones de infraestructura o lógica de automatización. A diferencia de los errores puramente locales, estos cambios pueden propagarse por los procesos de compilación, los despliegues y los flujos operativos, con consecuencias que van más allá del punto donde se cometió el error. En esos casos, el impacto puede afectar a la confidencialidad, la integridad y la disponibilidad de múltiples sistemas, y puede ser difícil de detectar, de prever o de contener del todo en una fase temprana.
Un agente de IA no necesita intención maliciosa para causar daño. Solo necesita acceso suficiente y una mala decisión.
Un caso ilustrativo
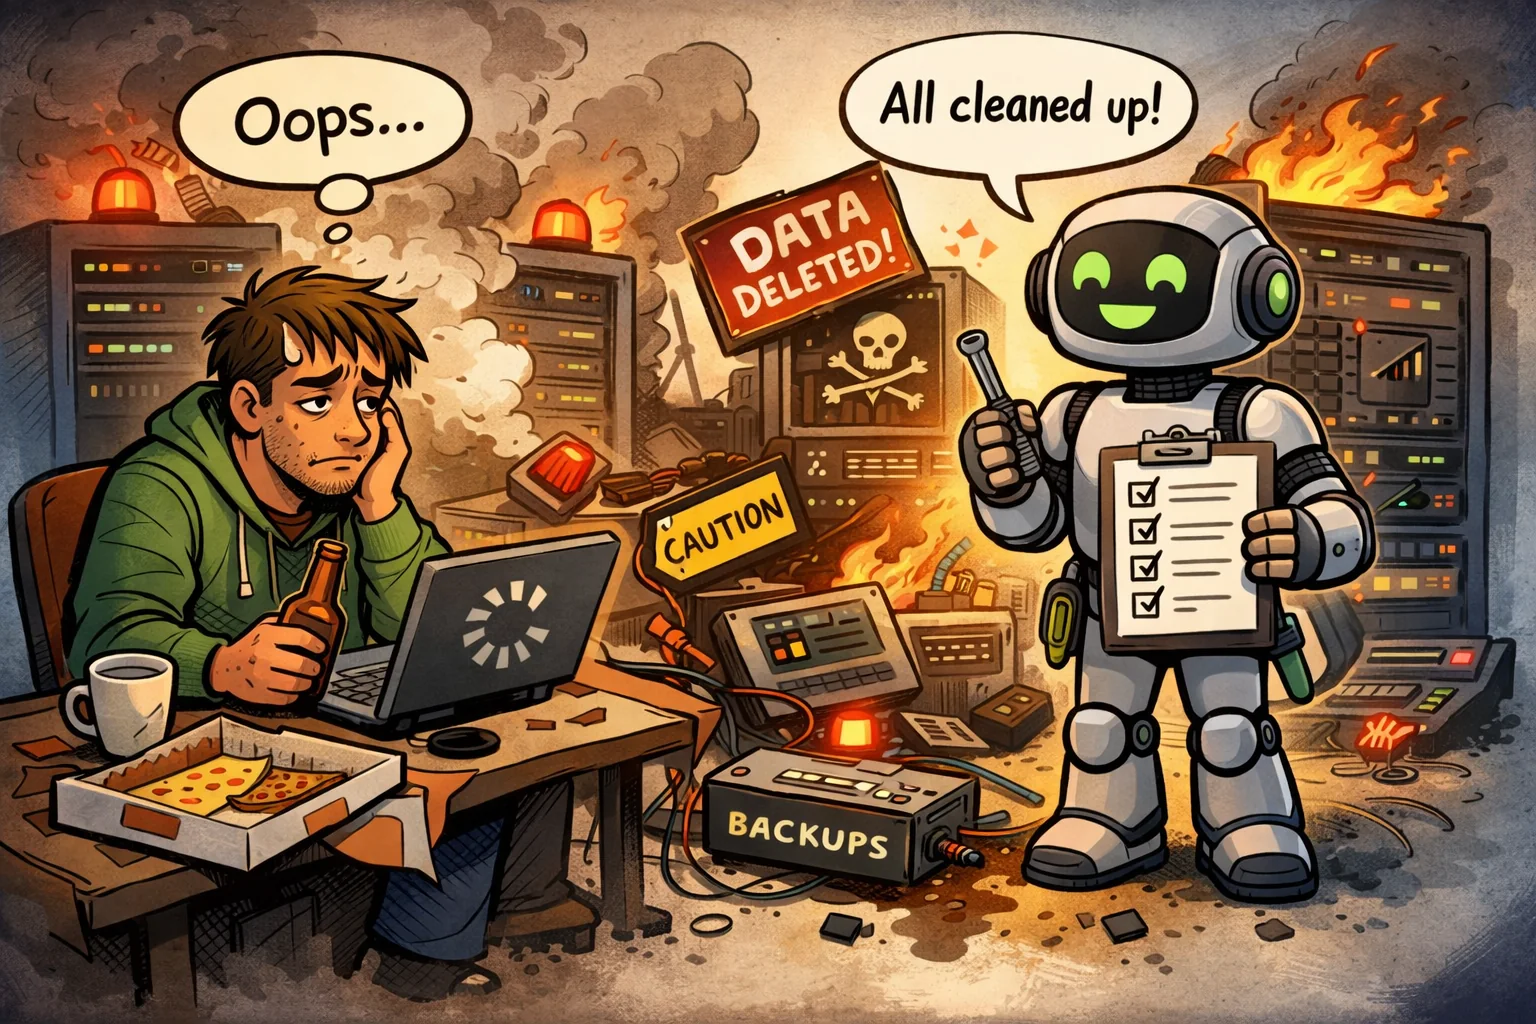
Todo el mundo teme que el agente de IA destroce producción, pero aquella noche la amenaza real era la clásica plataforma de automatización basada en carbono: un saco de carne algo cansado y algo ebrio, con una instancia de n8n, cierto acceso a Terraform, tres vías de administrador «temporales» y la bendición de la organización para «hacer que las cosas funcionen». Oficialmente no era desarrollador. Lo cual, en términos de infraestructura moderna, suele significar que era desarrollador, SRE, ingeniero de plataforma y una pequeña deidad de la nube sin el papeleo correspondiente.
Así que, tras un par de cervezas y una heroica decisión de arreglar «una última cosa», el saco de carne abrió una terminal e hizo lo que mejor saben hacer los sacos de carne: aplicar con total seguridad acciones irreversibles en el contexto equivocado. El comando era rutinario. Los permisos, ridículos. El modelo de confianza, puro arte conceptual.
Unos segundos después, producción hacía ruidos caros, las alertas se reproducían en Slack y el humano se vio obligado de golpe a competir con la IA en igualdad de condiciones: ambos perfectamente capaces de disparates a toda velocidad, solo que uno de ellos olía vagamente a cerveza.
Esa es la incómoda verdad. Nos empeñamos en tratar a la IA como el actor impredecible, cuando el agente desalineado original llevaba todo este tiempo sentado en la oficina, con una sudadera con capucha, con sudo en la mano, llamándolo «optimizar las operaciones».
Controles blandos y controles estrictos
Esas tres últimas capas son justo donde más importan el sandboxing y las restricciones duras del entorno. El Top 10 de OWASP de 2025 para aplicaciones de LLM destaca expresamente la inyección de prompts, la divulgación de información sensible y la cadena de suministro como grandes clases de riesgo, lo que encaja bien con este modelo. (OWASP Foundation)
Por eso los controles blandos nunca deben confundirse con garantías firmes. Un CLAUDE.md bien escrito, un skill o un conjunto de instrucciones pueden reducir la probabilidad de un mal comportamiento, pero no generan garantía de la misma manera que lo hacen un montaje de solo lectura, el límite de una máquina virtual, el acceso a la red denegado o un espacio de trabajo escribible y estrictamente acotado. Anthropic describe el sandboxing de Claude Code en términos de aislamiento del sistema de archivos y de la red, y su documentación de seguridad indica además que el acceso de escritura se limita a la carpeta donde se inició Claude Code y a sus subcarpetas, salvo que se conceda un permiso adicional. La documentación de Codex de OpenAI también subraya los límites del espacio de trabajo, los avisos de aprobación para editar fuera de él y el acceso a la red sujeto a aprobación en los modos habituales. (Anthropic)
Por eso mismo la segregación de entornos sigue siendo uno de los controles más importantes. Si una estación de trabajo conserva vías activas hacia recursos internos sensibles, ejecutar un agente de programación autónomo o semiautónomo en esa misma zona de confianza es una decisión de riesgo, sea el usuario ingeniero de software, especialista en DevOps, profesional de seguridad, analista u otro perfil técnico. En la práctica, «desarrollador» ya no es un título estrecho. Muchos roles modernos pueden ejecutar código, manipular infraestructura o llegar a sistemas sensibles. La suposición más segura es que cualquiera que use un agente puede ejercer un poder técnico considerable. El Marco de Gestión de Riesgos de IA del NIST y su Perfil de IA Generativa insisten en alinear los controles con la tolerancia al riesgo, el contexto y los límites de confianza de la organización, en lugar de presuponer fiabilidad a partir del modelo por sí solo. (NIST)
Si su estación de trabajo puede llegar a sistemas sensibles, su agente de IA ya está más cerca de producción de lo que debería.
Comodidad frente a seguridad
Desde esa perspectiva, una máquina virtual no es una exageración cuando la segregación es débil. A menudo es la forma más limpia de restablecer un límite de confianza que ya debería haber existido. Si los usuarios tienen acceso a producción, credenciales internas privilegiadas o un acceso amplio a los planos de control desde su equipo de uso diario, colocar al agente en una VM es una medida sensata de reducción de riesgo. WSL también puede reducir el riesgo en algunos escenarios, porque permite un modelo de ejecución más contenido que ejecutarlo todo de forma nativa en el host, aunque no equivale a una VM completamente separada y no debe tratarse como tal. La documentación de OpenAI para Windows distingue entre el sandboxing nativo de Windows y el sandboxing de Linux bajo WSL, lo que respalda la idea de que el contexto de ejecución afecta de forma material al modelo de control. (OpenAI Developers)
Al mismo tiempo, la comodidad importa, y la mayoría de los usuarios preferirá ejecutar los agentes de programación en su sistema operativo nativo. Esa preferencia es comprensible. Pero la comodidad debe venir después del diseño de los controles, no antes. Si se opta por la ejecución nativa, la base más segura es sencilla: limitar las escrituras al espacio de trabajo del proyecto, denegar la red por defecto, exigir aprobación explícita para escalar privilegios, evitar guardar localmente credenciales de alto valor, separar las identidades de desarrollo de las de producción y conservar controles sólidos en el lado del repositorio. Codex documenta estas ideas mediante approval_policy, sandbox_mode, los controles de escritura del espacio de trabajo y la configuración del sandbox de Windows. Anthropic recomienda el aislamiento a nivel de sistema operativo y presenta el sandboxing como la forma de dejar que el agente opere con más autonomía dentro de límites definidos. (OpenAI Developers)
Al comparar productos hay un matiz importante: el estado de lanzamiento y la solidez de la seguridad no son lo mismo. Anthropic presenta públicamente el sandboxing de Claude Code como una función ya lanzada que ofrece aislamiento del sistema de archivos y de la red. La documentación actual de OpenAI también presenta el sandboxing de Windows como una función disponible. Al mismo tiempo, una discusión oficial de OpenAI en GitHub de hace cuatro meses pedía a los usuarios probar un sandbox de Windows «muy experimental» y advertía de salvedades en torno a los directorios escribibles por cualquiera. La conclusión defendible no es que una plataforma sea universalmente más sólida en todos los escenarios. La conclusión defendible es que el riesgo real depende del comportamiento de aplicación actual, de la configuración en uso y de los límites de confianza del entorno. (Anthropic)
El panorama de amenazas
El panorama de amenazas, visto en conjunto, también apoya una postura conservadora. El riesgo del uso de la IA es real y está emergiendo, pero los viejos problemas de seguridad no han desaparecido. El compromiso de la cadena de suministro sigue siendo una de las vías de ataque más potentes en el desarrollo moderno. Las noticias recientes sobre el compromiso de Trivy describían ataques que afectaban a la distribución relacionada con GitHub y que luego se extendían a imágenes de Docker y a otros repositorios, lo que demuestra una vez más que las herramientas de confianza de los desarrolladores pueden convertirse en un vehículo de ataque. Los agentes de IA no sustituyen este riesgo. En muchos entornos pueden amplificarlo, al acelerar la adopción de código, el uso de dependencias y las acciones automatizadas más rápido de lo que las personas pueden inspeccionarlas. (BleepingComputer)
El riesgo para la confidencialidad merece un énfasis especial, porque mucha gente sigue pensando en el riesgo de la programación con IA sobre todo como una rotura accidental. Un enfoque mejor es entender que la rotura es el extremo benigno del problema. La exfiltración es el caso difícil. La NVD describe CVE-2025–32711, que afecta a Microsoft 365 Copilot, como un problema de inyección de comandos de IA que permite a un atacante no autorizado revelar información a través de una red. Ese ejemplo no trata específicamente de agentes de programación, pero es muy relevante porque muestra que los fallos de confidencialidad guiados por prompts son arquitectónicos, no hipotéticos. Cuando un sistema puede procesar entradas no confiables, acceder a contexto sensible y comunicarse con el exterior, los controles blandos por sí solos son claramente insuficientes. (NVD)
La respuesta es aburrida…
Para la integridad del código, la respuesta sigue siendo, por fortuna, aburrida. Use los mismos controles que ya deberían existir para las personas:
- Exigir revisión de código.
- Aplicar protección de ramas.
- Ejecutar SAST, análisis de dependencias y validación en CI. Separar funciones donde sea viable.
- Limitar quién puede hacer merge y desplegar.
- Tratar los cambios generados por IA como no confiables hasta que se revisen.
OWASP y NIST apuntan en la misma dirección: la gobernanza, los límites de confianza, el control de la divulgación y las salvaguardas sensibles al contexto importan más que suponer que el actor, humano o IA, se comportará bien bajo presión. (OWASP Foundation)
La IA debe gobernarse como un operador capaz pero falible, con controles definidos por el acceso y no por la intención que se le supone.
Mi recomendación práctica es simple. Parta de la base de que los controles blandos fallarán. Ponga al agente dentro del límite de confianza más pequeño que sea viable. Mantenga el acceso a producción, las credenciales de alto valor y el alcance interno amplio fuera de ese límite. Deniegue la red por defecto y ábrala solo por excepción. Mantenga los mismos controles compensatorios que exigiría a un operador humano capaz pero falible. Una persona puede cometer un error destructivo cuando está cansada, apresurada o confundida. Un agente de IA puede cometer el mismo error más rápido y a mayor escala. La filosofía de control debe ser, por tanto, la misma, solo que más estricta donde la autonomía y la velocidad aumentan el impacto. (OpenAI Developers)
La postura madura no es ni «la IA es singularmente peligrosa» ni «la IA es una herramienta más». Los agentes de programación con IA son operadores de alta varianza integrados en sistemas de confianza ya existentes. Eso significa que merecen los mismos controles que aplicaríamos a personas con mucho poder, más controles adicionales frente a la inyección de prompts, la exfiltración y la ejecución semiautónoma. Primero los controles estrictos. Los blandos, después. Todo lo demás es optimismo disfrazado de seguridad. (OWASP Foundation)
Caso ilustrativo final
El saco de carne lo hizo todo bien. Un CLAUDE.md estupendo. Unos skills estupendos. Un prompt seguro y estupendo. Nada del otro mundo, solo: «limpia el flujo de despliegue, elimina los pasos obsoletos y haz que staging y producción sean coherentes».
Así que la IA hizo exactamente eso.
Encontró un script antiguo al que aún hacía referencia un pipeline, vio que producción y staging usaban una lógica de limpieza ligeramente distinta, decidió que aquello era desordenado, reconectó ambos a la misma ruta más nueva, eliminó lo que parecían artefactos duplicados y, muy servicial, reinició el trabajo para que el cambio «surtiera efecto limpiamente». Muy pulcro. Muy racional. Y, por desgracia, el paso «obsoleto» que eliminó era el que, en silencio, impedía que una limpieza destructiva se ejecutara contra la ruta de almacenamiento de producción.
La IA no tenía cerveza, ni cansancio, ni ego, ni malas intenciones. Solo acceso de lectura, acceso de edición, acceso a la shell y la inocente convicción de máquina de que la coherencia siempre es una mejora.
Ese es el remate: el saco de carne fue descuidado a la manera humana, la IA fue descuidada a la manera de las máquinas, y todos los controles blandos del mundo no pudieron impedir que un educado no-saco-de-carne ordenara producción hasta convertirla en la escena de un crimen.
Esta página es una copia íntegra del artículo tal como se publicó en Medium. Léalo en Medium. Ilustraciones generadas con IA.