
Medium · Ingeniería de IA, Desarrollo de software · Borrador
El patrón de cuatro bucles: cómo ejecutar agentes de programación autónomos sin deriva
Cómo mantener la disciplina de la ingeniería con IA cuando los agentes trabajan más rápido de lo que usted puede revisar, incluso cuando quien ideó esa disciplina se desvía de ella.
Publicado por primera vez en Medium el 12 de mayo de 2026; editado por última vez el 13 de mayo de 2026. Léalo en Medium. 17 min de lectura.
Cómo mantener la disciplina de la ingeniería con IA cuando los agentes trabajan más rápido de lo que usted puede revisar, incluso cuando quien ideó esa disciplina se desvía de ella.
Este es un artículo exploratorio, no una prescripción. Su valor no está en que el patrón de los cuatro bucles ya esté demostrado, sino en que da lenguaje a un modo de fallo real: los agentes autónomos pueden estar ocupados, ser correctos a nivel local y aun así no hacer avanzar el producto.
Si lleva más de una semana ejecutando agentes de programación sobre una base de código real, probablemente se haya topado con el mismo muro que yo. Los agentes son productivos: suben commits, pasan la CI, actualizan la documentación. El repositorio crece. Se añaden pruebas. Se construyen mecanismos nuevos.
Y entonces da un paso atrás, mira su producto y se da cuenta: en realidad, nada ha mejorado.
Los agentes están ocupados. La producción es real. Pero la experiencia del usuario está más o menos donde estaba hace un mes. La base de código es más grande, la doctrina es más gruesa, la metaarquitectura es más elegante, y la función que usted quería entregar sigue sin funcionar de extremo a extremo.
Este artículo describe el patrón al que he llegado para ejecutar agentes de programación autónomos de modo que de verdad hagan avanzar el producto. No es una bala de plata. Es una disciplina. Y, importante, es una disciplina que me sorprendí infringiendo varias veces en la misma sesión que produjo este artículo. Eso también forma parte de lo que encontrará aquí: los modos de fallo que sobreviven incluso después de haber escrito las reglas.
El modo de fallo
La patología tiene nombre: disparos neutros a la deriva. Un «disparo» es una única ejecución de un bucle de agente. Un disparo neutro a la deriva es aquel en el que el agente trabaja, sube commits, pasa la CI y no cambia nada que el usuario pueda ver o medir.
Variantes habituales:
- Inflación doctrinal. El agente escribe una nueva guía de estilo, una nueva regla de arquitectura, una nueva convención de nombres. El código no cambia; crece la doctrina que deberán leer los agentes futuros. Pasadas unas semanas, cada sesión nueva dedica el 20 % de su ventana de contexto a leer reglas que no sirven directamente a ninguna función.
- Proliferación de stubs. El agente entrega una «función»: una pantalla nueva, un tipo de entidad, un endpoint de API. La forma es correcta (el archivo existe, el esquema valida, la CI en verde). El comportamiento está vacío: la pantalla no tiene datos, la entidad no tiene métodos, el endpoint devuelve 404 con entradas reales. La superficie del producto crece a lo ancho y se queda superficial.
- Mecanismo sin medición. El agente construye un marco de pruebas, una capa de observabilidad, una compuerta de CI. El marco se ejecuta. Nada de lo que podría detectar llega a saltar. La salida del marco: una marca verde, siempre, sobre un producto que está roto.
- Remodelado del plan. El agente edita la hoja de ruta, reclasifica prioridades, añade elementos nuevos al backlog. La hoja de ruta crece. El trabajo entregado contra ella sigue siendo pequeño.
Cada una de estas cosas parece productiva porque el agente SÍ está subiendo commits. El disparo es «exitoso» en el sentido trivial: no se cayó, la CI estaba en verde, el diff se fusionó. Pero el estado medible de la plataforma no cambió. Multiplíquelo por 50 disparos a la semana y tendrá una cinta de correr muy cara.
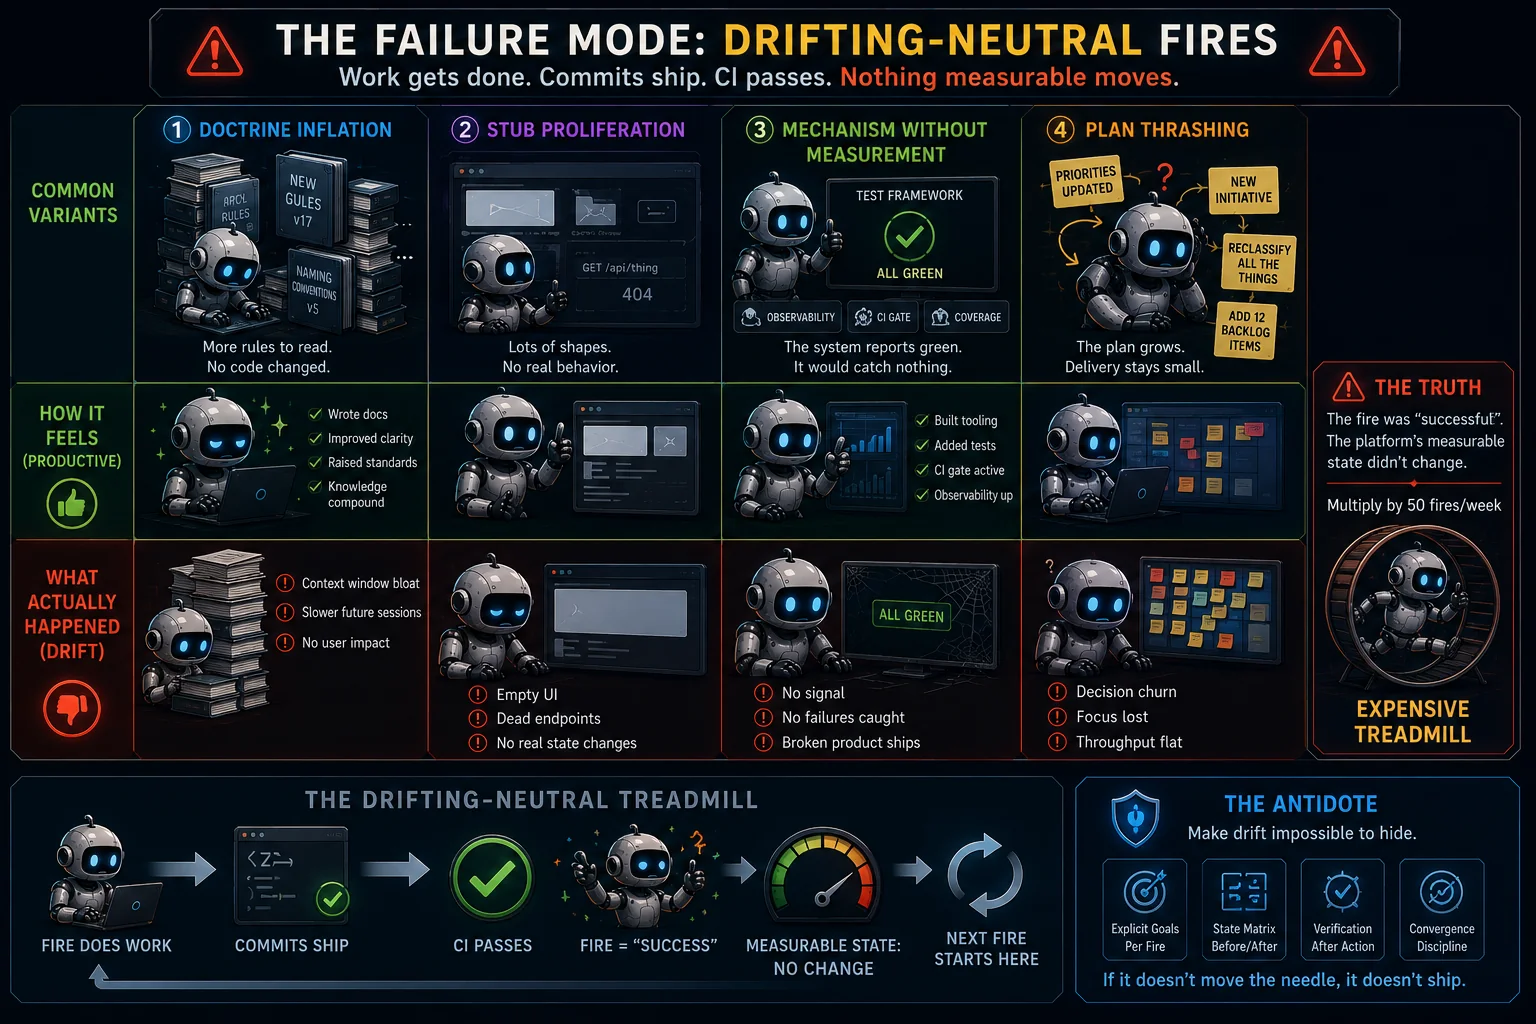
La disciplina que sigue existe para que este modo de fallo sea imposible de ocultar.
La arquitectura de cuatro bucles
Rechace el patrón del «agente único». Un solo bucle que intenta hacerlo todo (implementación, revisión, supervisión, pruebas de usuario) deriva, porque las prioridades compiten y no hay separación de responsabilidades que lo impida.
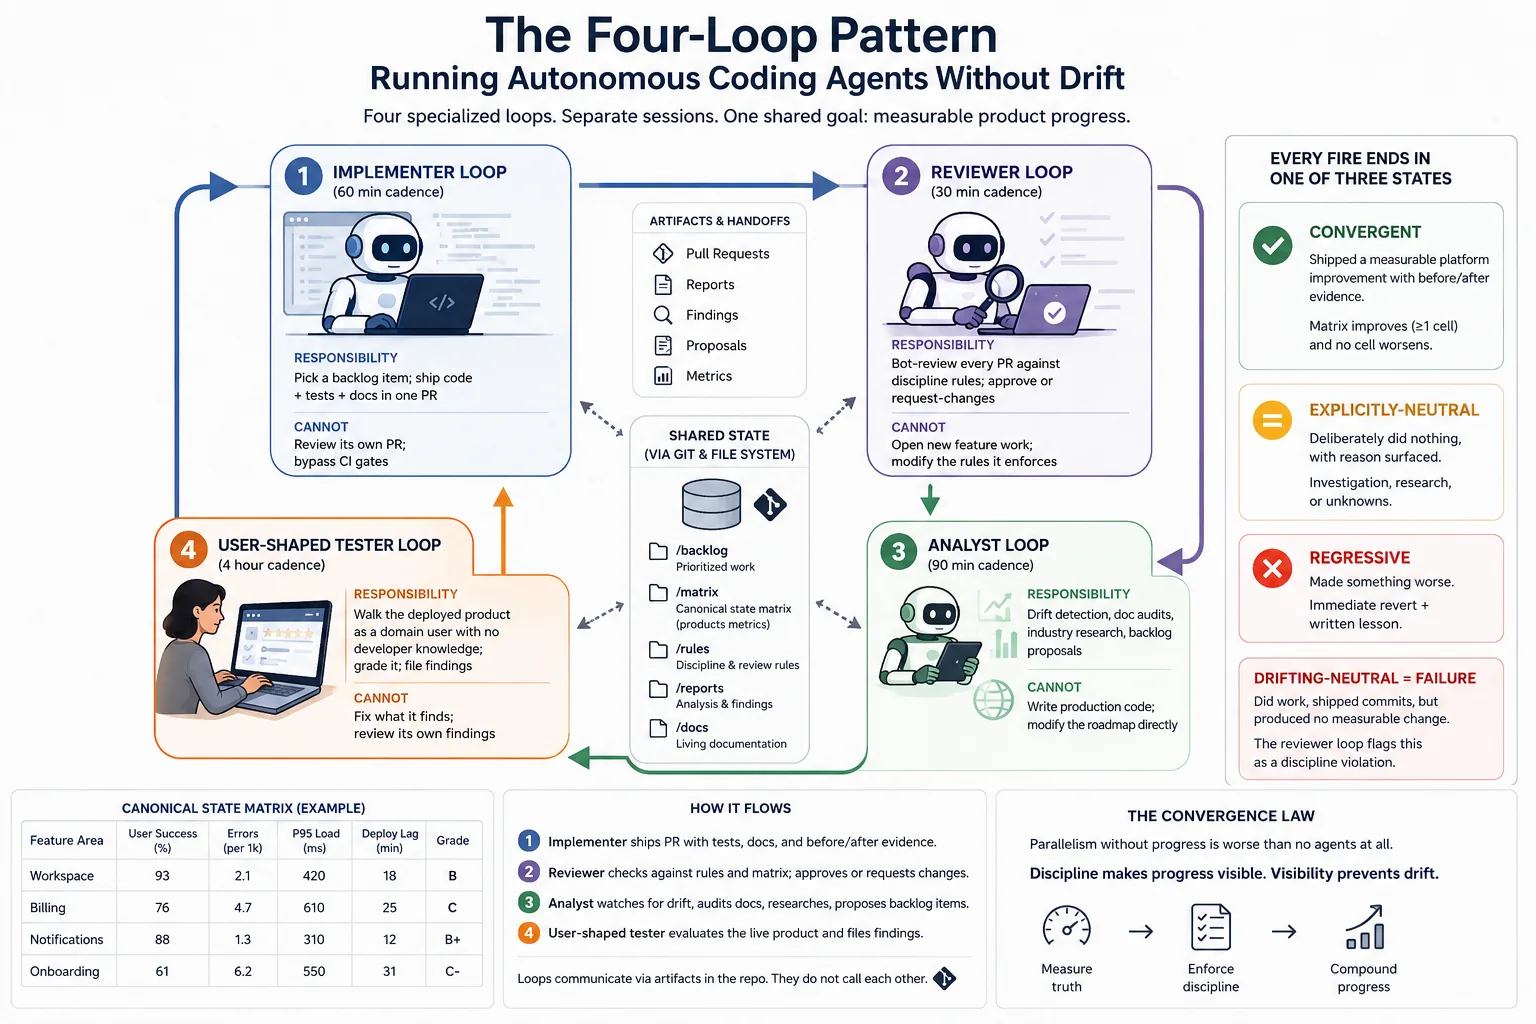
Cuatro bucles, cada uno con una responsabilidad cerrada:
- Bucle implementador: se ejecuta cada 60 minutos. Toma un elemento del backlog; entrega código, pruebas y documentación en una sola PR. No puede: revisar su propia PR ni saltarse las compuertas de CI.
- Bucle revisor: se ejecuta cada 30 minutos. Revisa mediante bot cada PR contra las reglas de disciplina; aprueba o solicita cambios. No puede: abrir trabajo nuevo de funciones ni modificar las reglas que hace cumplir.
- Bucle analista: se ejecuta cada 90 minutos. Detección de deriva, auditorías de documentación, investigación del sector, propuestas para el backlog. No puede: escribir código de producción ni modificar directamente la hoja de ruta.
- Bucle probador con perfil de usuario: se ejecuta cada 4 horas. Recorre el producto desplegado como un usuario del dominio sin conocimientos de desarrollo; lo puntúa; registra hallazgos. No puede: corregir lo que encuentra ni revisar sus propios hallazgos.
Cada bucle se ejecuta en su propia sesión. Se comunican a través del sistema de archivos (git para el estado compartido; archivos de directivas por bucle para los traspasos). No se llaman entre sí directamente.
La ortogonalidad importa. El implementador no puede darse el visto bueno a sí mismo; el revisor no puede hacer su propia implementación; el analista no puede entregar los cambios que propone; el probador no puede arreglar lo que puntúa. Cada bucle se ve obligado a usar los resultados de los demás.
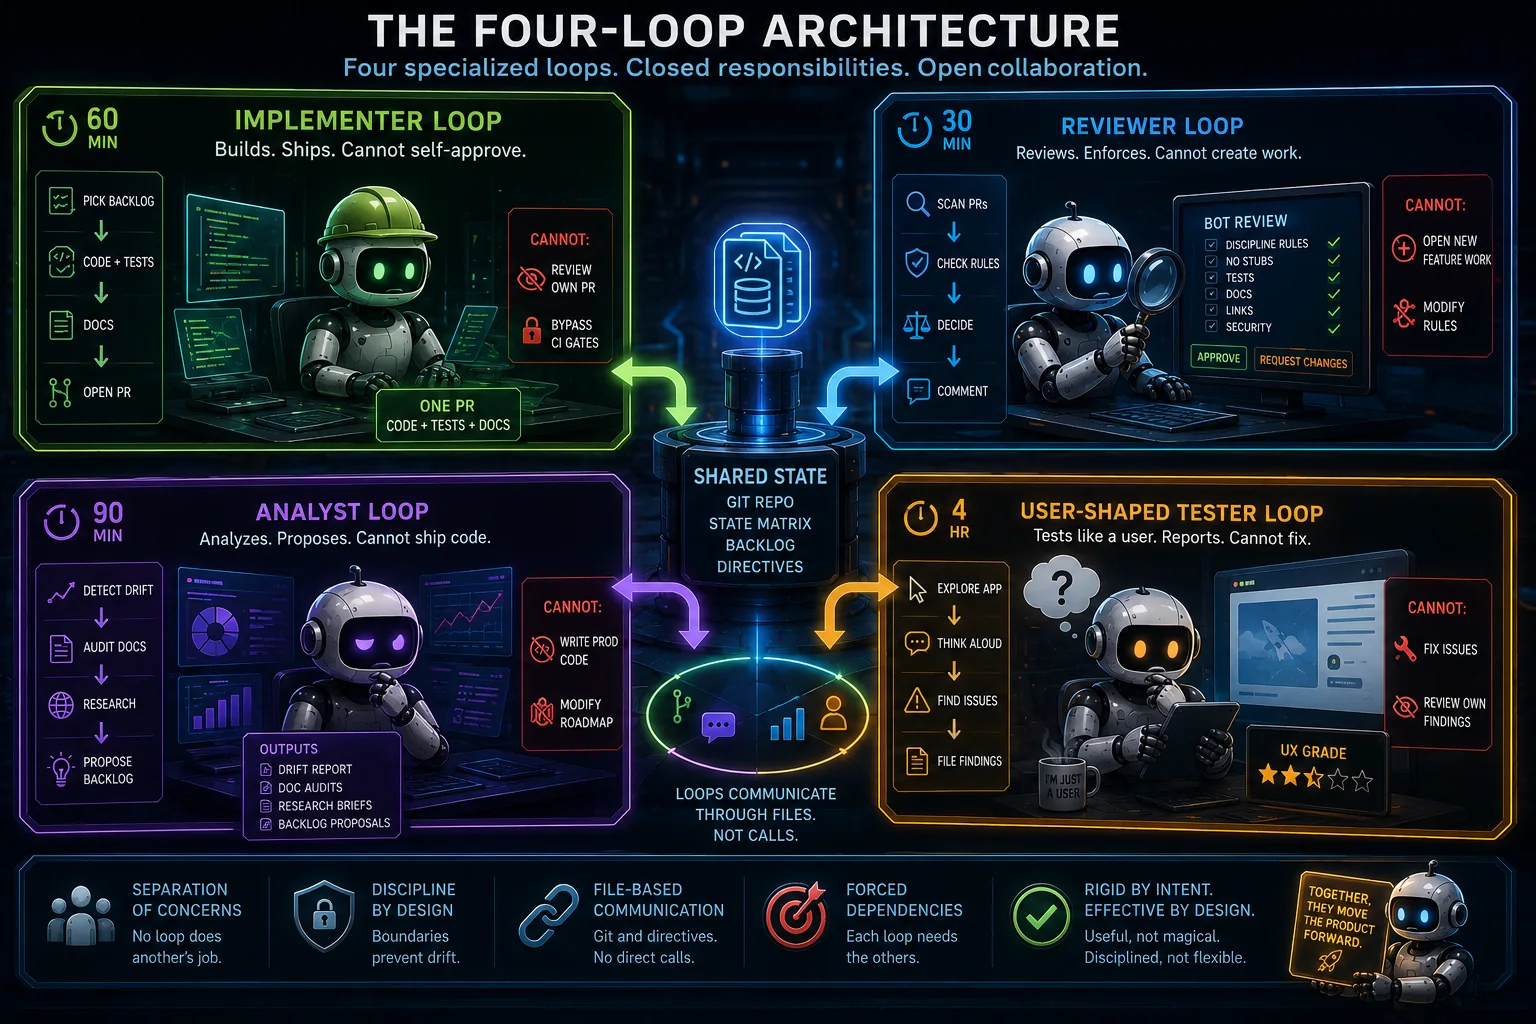
Es la misma separación que tiene un equipo de ingeniería humano sano (desarrollador, revisor, QA, operaciones), codificada para agentes. Los bucles no son «más flexibles» que las personas. Son más rígidos. Ese es el objetivo.
La ley de la convergencia
El paralelismo sin progreso es peor que no tener agentes. Para obtener progreso hace falta una regla estricta:
Todo disparo termina en uno de tres estados: CONVERGENTE (entregó una mejora medible de la plataforma con evidencia de antes y después), EXPLÍCITAMENTE NEUTRO (no hizo nada de forma deliberada, con el motivo a la vista) o REGRESIVO (empeoró algo: exige revertir de inmediato y escribir una lección). Un disparo que se ejecutó, hizo cosas, pero no produjo ningún cambio medible es NEUTRO A LA DERIVA y es un modo de fallo que el bucle revisor señala como infracción de la disciplina.
«Medible» es un término que soporta carga. Requiere una matriz de estado canónica que todos los bucles lean en el arranque en frío: calificaciones por área funcional, tasas de éxito, profundidad de las colas, retraso de despliegue, sean cuales sean los ejes principales de su producto. Un disparo es convergente si alguna celda de esa matriz mejoró Y ninguna empeoró. La mejora debe respaldarse con evidencia de antes y después en el cuerpo de la PR.
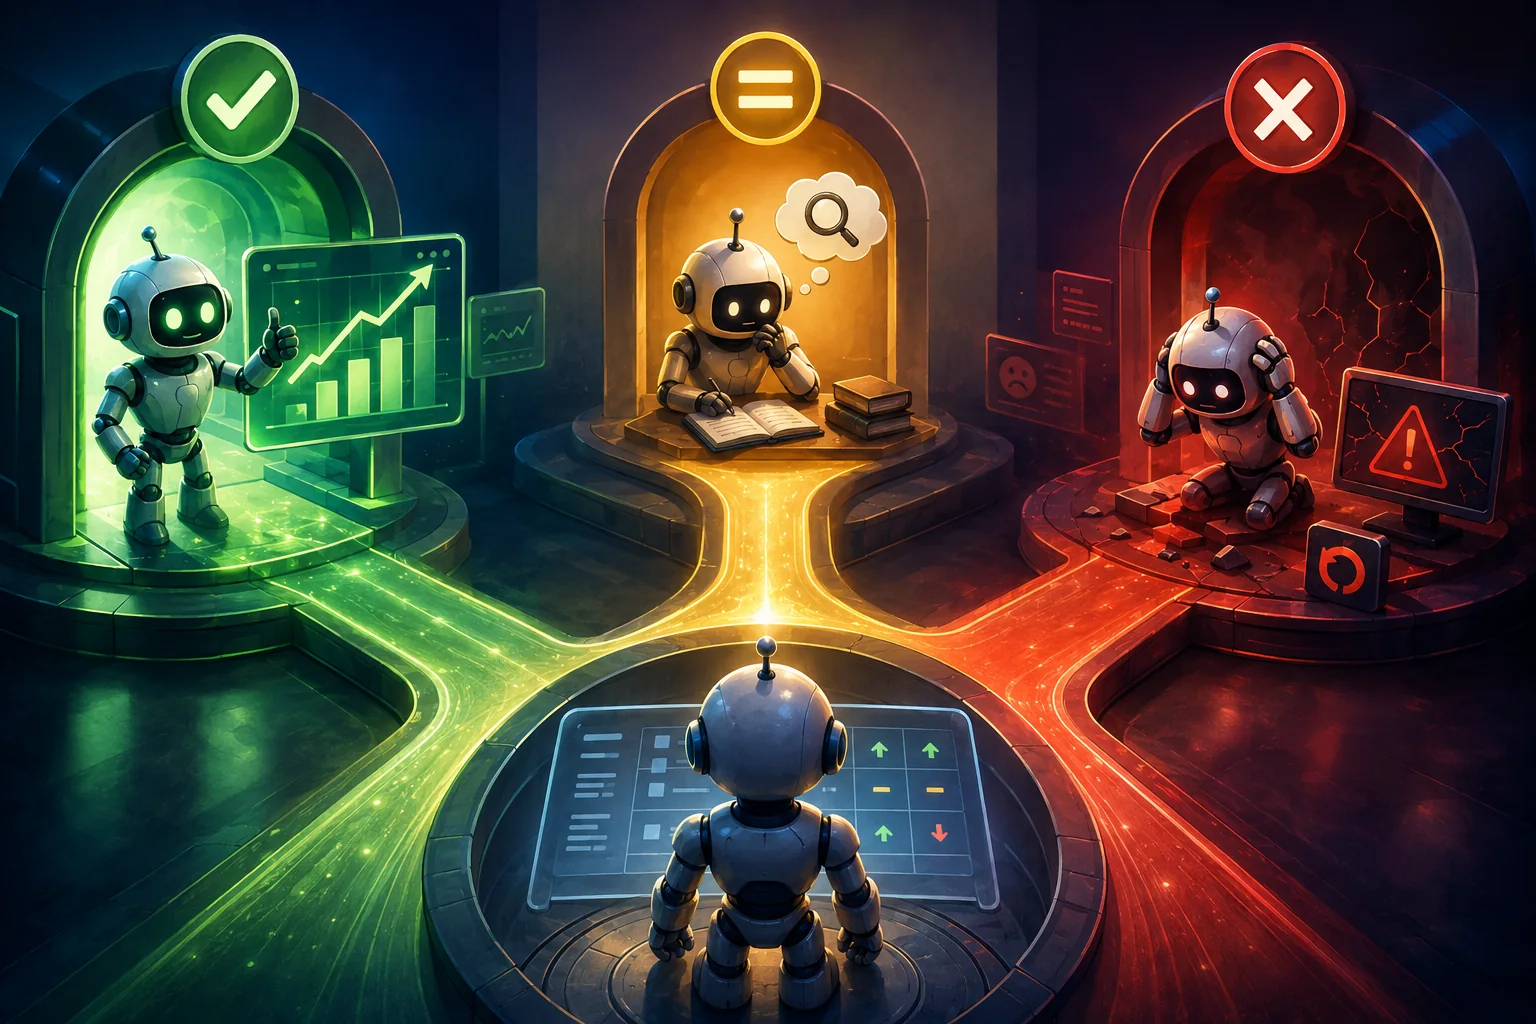
En la práctica:
- Ejemplo convergente. «El espacio de trabajo X pasó de la calificación F a la B (antes: sin lista ni botón de crear; después: 93 entidades visibles y un botón de crear que funciona). Captura de pantalla de antes adjunta; captura de después adjunta. Matriz de estado actualizada».
- Ejemplo explícitamente neutro. «Solo investigación: causa raíz aún desconocida; no era posible ninguna corrección en este disparo. Hallazgos registrados en analysis/…»
- Ejemplo regresivo. «Se intentó Y; se rompió Z. Se revirtió el commit ABC. Lección escrita».
El bucle revisor hace cumplir esto en cada PR. Las PR que no encajan en uno de los tres estados reciben REQUEST_CHANGES. El autor tiene que encontrar la mejora medible, reclasificarla como neutra con su motivo o revertir.
Solo esta regla detecta aproximadamente el 80 % del problema de la deriva. Para el resto hace falta más.
La regla de amortización
Las reglas se acumulan. Cada regla nueva que un agente futuro debe leer es un impuesto sobre el presupuesto de contexto de cada disparo futuro. Por tanto:
Añadir un nuevo documento de doctrina, una definición de agente, un elemento del backlog o un paso de proceso EXIGE retirar al menos uno existente (eliminarlo, integrarlo en otro o archivarlo). La complejidad neta no puede crecer sin aprobación explícita del operador. Excepción: si el elemento nuevo sustituye a varios antiguos por convergencia, el saldo es negativo y es aceptable.
Esta es la regla que yo mismo infrinjo más. Cuesta borrar cosas que uno ha escrito. Pero la alternativa es un documento de doctrina que lleva 30 minutos leer al comienzo de cada sesión, lo que significa que los agentes lo leen por encima, lo que significa que no lo siguen, lo que significa que derivan.
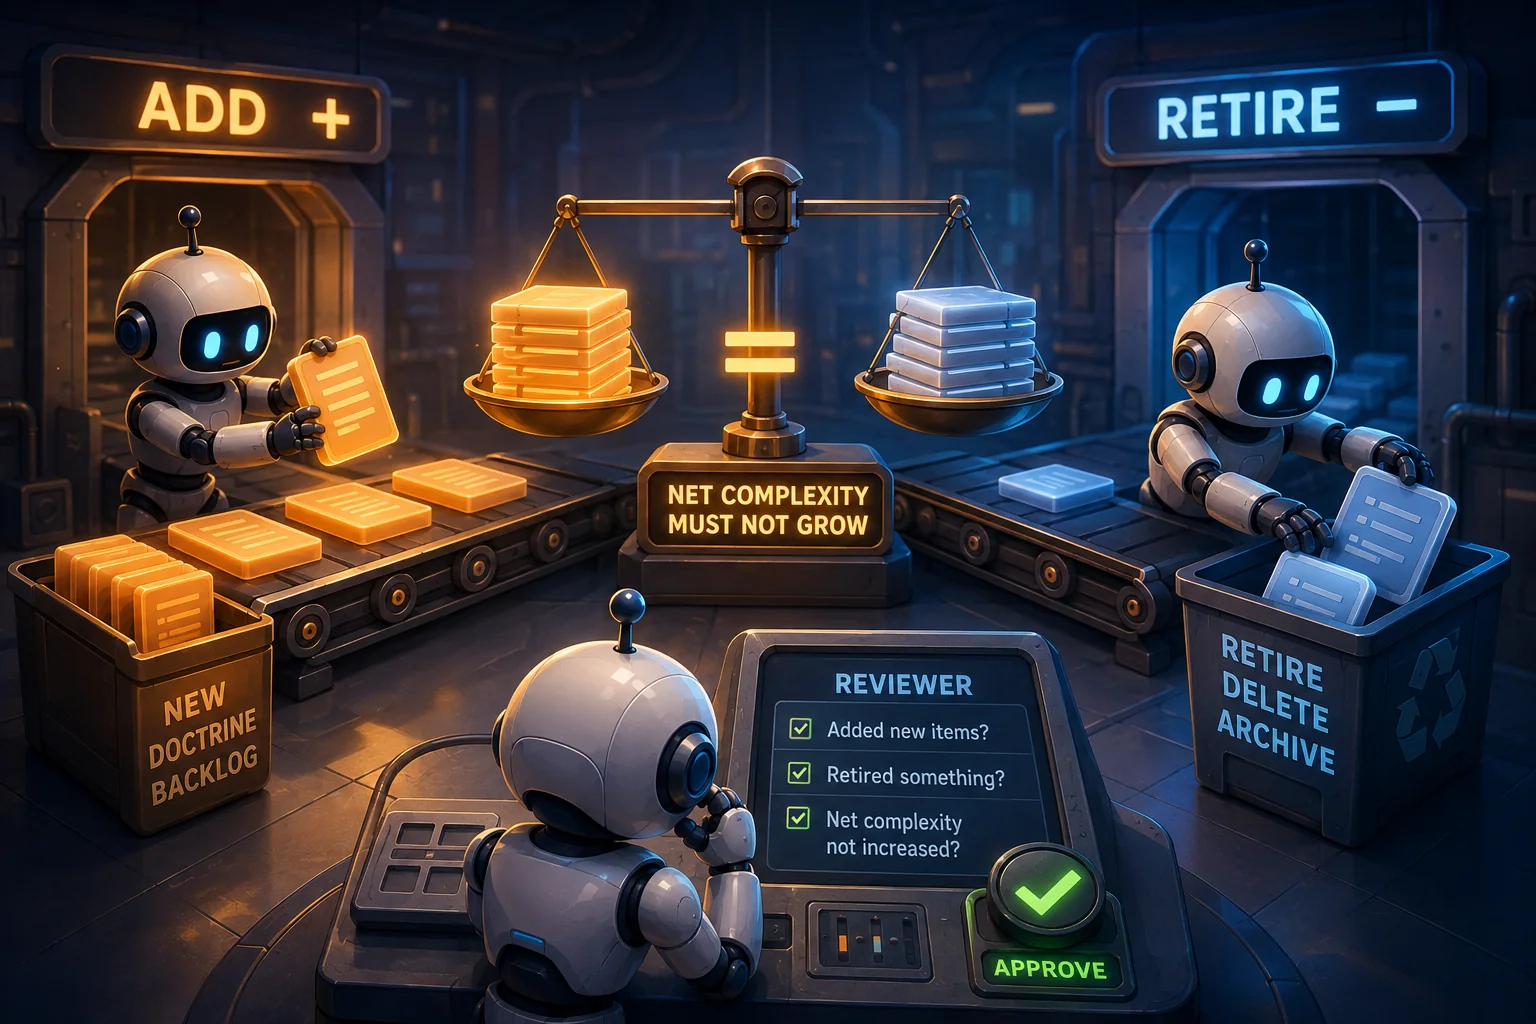
El bucle revisor comprueba cada PR: ¿añadió archivos de doctrina o elementos de backlog nuevos? En ese caso, ¿retiró también algo de peso equivalente? Si no, REQUEST_CHANGES con: «convergence-discipline: esta PR añade N elementos de doctrina nuevos pero retira 0. Retire uno o documente por qué el saldo neto positivo se justifica por una mejora medible que llega en esta misma PR».
La regla de no entregar stubs
La disciplina de convergencia detecta la deriva por disparo. No detecta la deriva por artefacto. Un solo disparo puede entregar 10 artefactos de los que 3 funcionan y 7 son stubs, contar como «convergente» en conjunto y hacer crecer en silencio el número de stubs de la plataforma.
Regla por artefacto:
Todo artefacto que entregue (endpoint, pantalla, widget, capacidad, definición de agente, sección de manual, lo que sea) DEBE estar en uno de tres estados: FUNCIONAL(verificado de extremo a extremo con una prueba, la salida de un smoke test o una captura de pantalla en el cuerpo de la PR), LISTO PARA FUNCIONAR(la carencia está nombrada de forma explícita y el elemento que la completa queda en cola en la misma PR), o STUB CON COLA(marcador explícito status:stub más el elemento de finalización citado más una explicación legible por el operador cuando se llega a él). STUB SIN COLAes una infracción de la disciplina.
La infracción clásica: entregar una pantalla con un widget de «Cola no disponible: Reintentar». La forma del widget está bien; los datos que hay detrás no existen; no hay ningún elemento de finalización en cola. El usuario se topa con un muro sin explicación y sin camino a seguir.
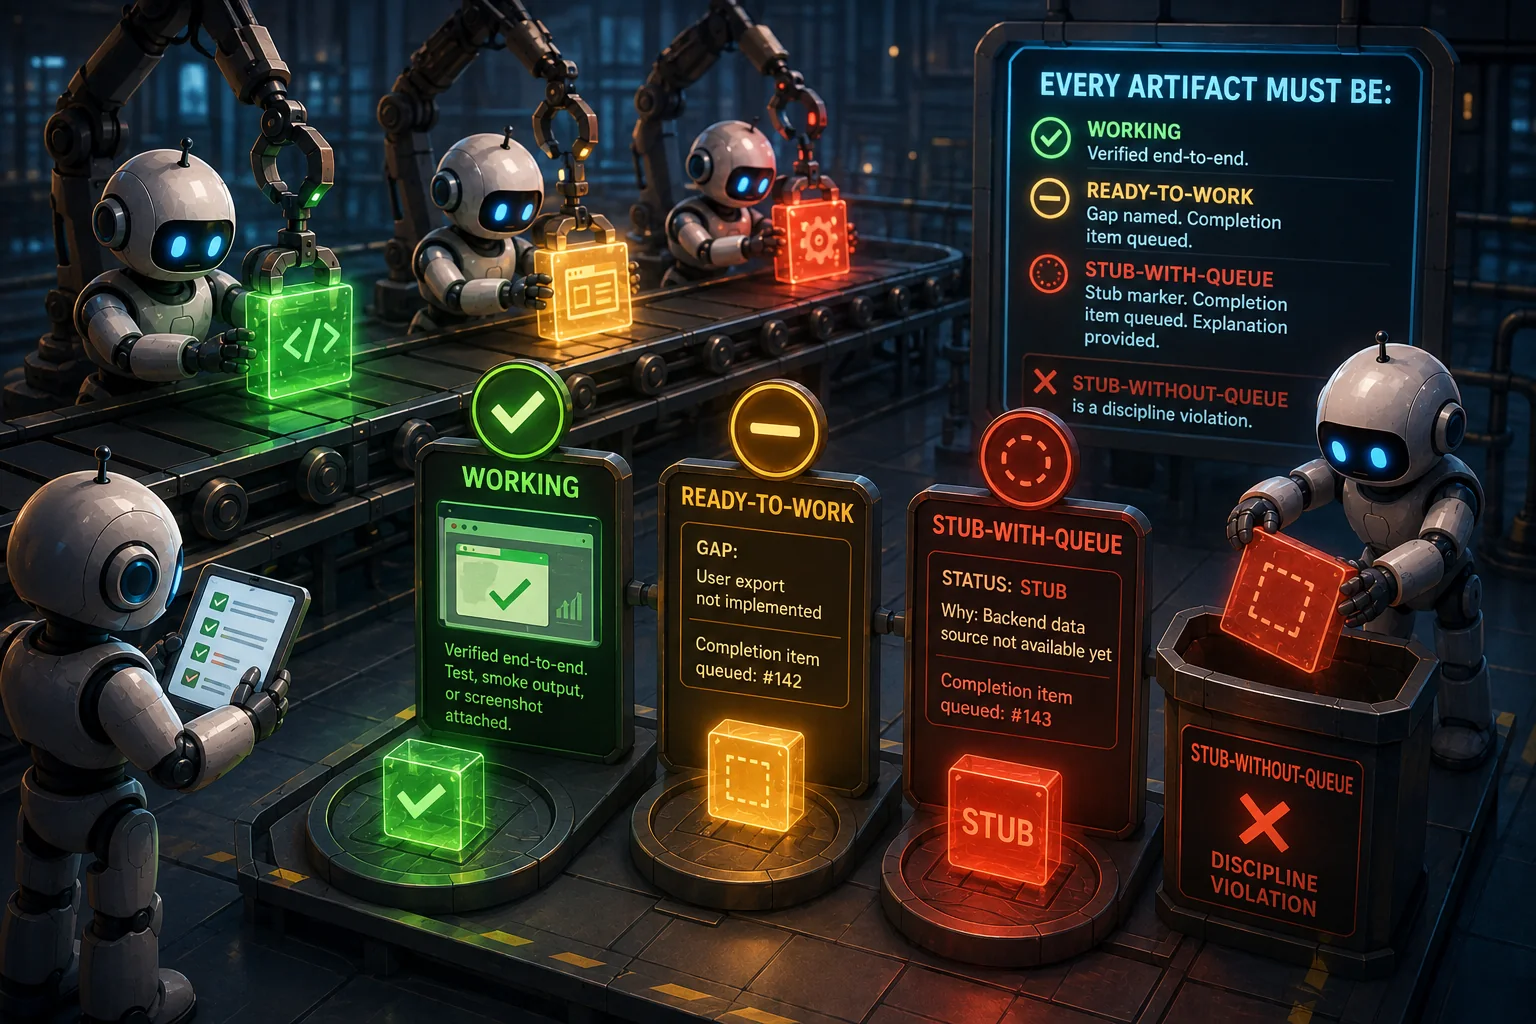
Una infracción más sutil: entregar un archivo de documentación con enlaces markdown a archivos hermanos que no existen. El destino del enlace debería ser un archivo de stub con cola, pero ni siquiera es eso: es un vacío. El verificador de enlaces del revisor hace fallar la CI; la compuerta de despliegue se niega; la plataforma se detiene. Entregué exactamente este modo de fallo en la sesión que produjo este artículo, y el bucle analista lo detectó en cuestión de horas. Más sobre eso más adelante.
El protocolo universal de arranque en frío
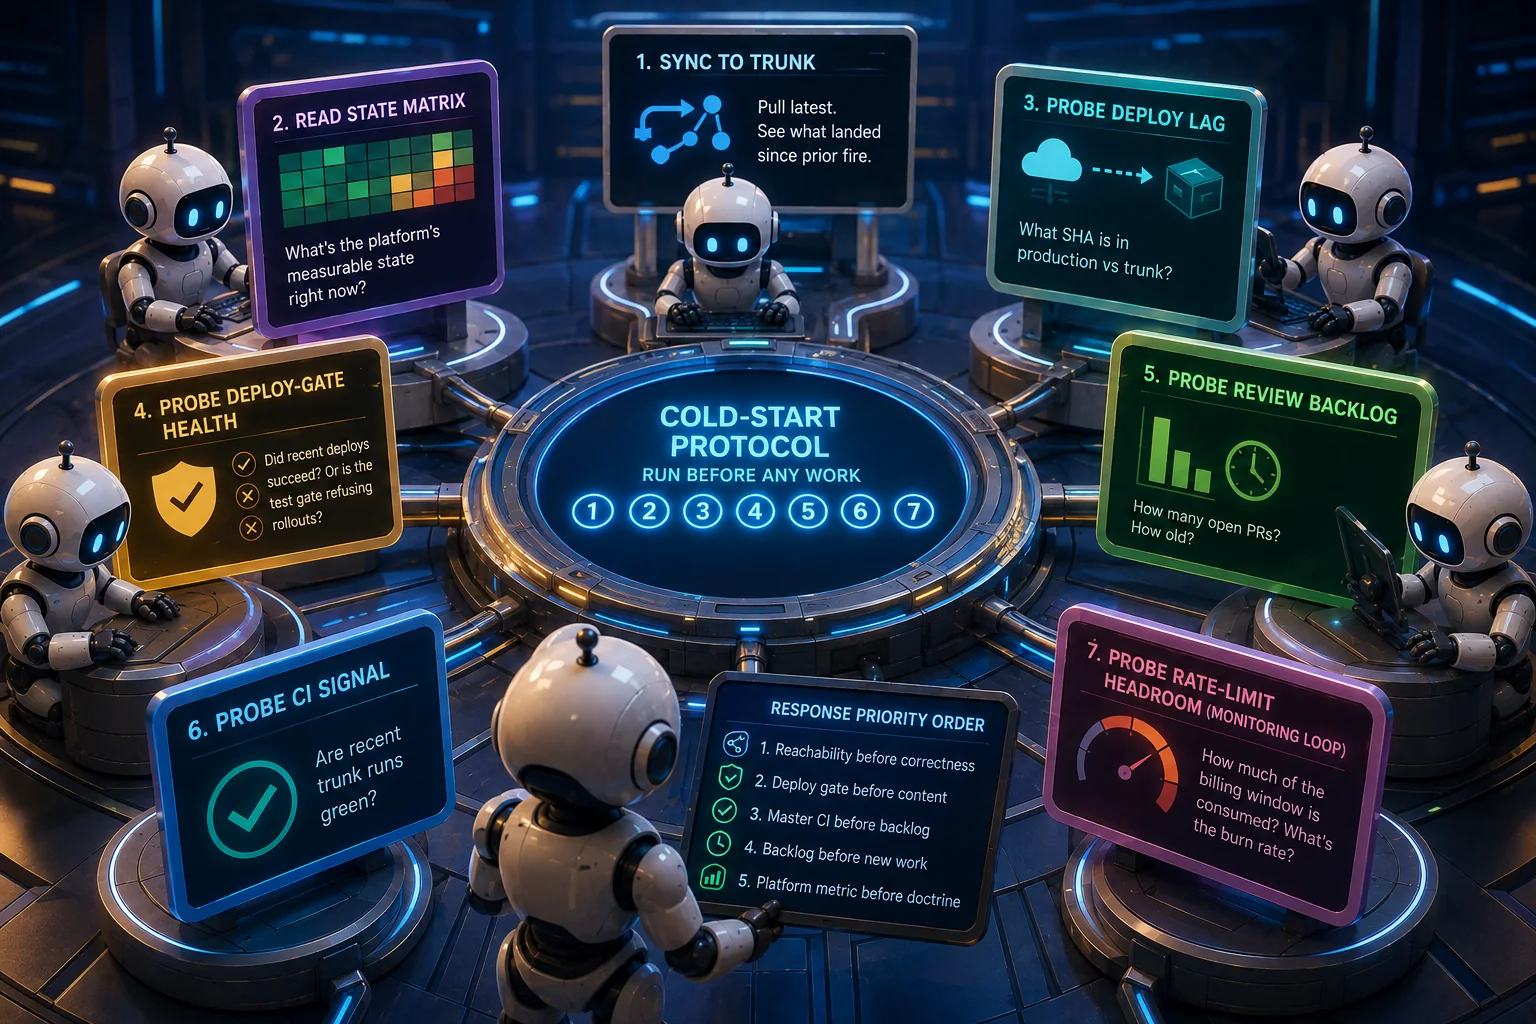
Cada bucle, al inicio de cada disparo, ejecuta las mismas seis sondas antes de hacer ningún trabajo:
- Sincronizar con la rama principal actual. Hacer pull. Ver qué ha aterrizado desde el disparo anterior.
- Leer la matriz de estado canónica. ¿Cuál es ahora el estado medible de la plataforma?
- Sondear el retraso de despliegue. ¿Qué SHA está en producción frente a la rama principal? El cuello de botella más común está justo aquí.
- Sondear la salud de la compuerta de despliegue. ¿Tuvieron éxito los despliegues recientes? ¿O la compuerta de pruebas está rechazando los lanzamientos?
- Sondear la acumulación de revisiones. ¿Cuántas PR abiertas hay? ¿Qué antigüedad tienen?
- Sondear la señal de CI. ¿Están en verde las últimas ejecuciones de la rama principal?
Más una séptima en el bucle de supervisión:
- Sondear el margen de límite de tasa. ¿Cuánto de la ventana de facturación actual se ha consumido? ¿Cuál es el ritmo de consumo?
Tras las sondas, cada bucle aplica sus reglas de respuesta en un orden de prioridad anclado en una justificación: la accesibilidad antes que la corrección, la compuerta de despliegue antes que el contenido, la CI maestra antes que el backlog, el backlog antes que el trabajo nuevo, la métrica de la plataforma antes que la doctrina.
Suena burocrático. Es lo contrario: elimina la libertad del agente para elegir mal. Un bucle que se enfrenta a «compuerta de despliegue rechazada, cuatro PR sin revisar, CI en rojo, backlog creciendo, el área funcional peor calificada en F» ya no tiene que pensar en la prioridad. El protocolo decide: primero la compuerta de despliegue.
Trece invariantes de robustez
Los protocolos que sondean el estado son frágiles por naturaleza. Las sondas agotan el tiempo, faltan archivos, las redes fallan. Por eso:
- I-1. Toda sonda tiene un tiempo de espera estricto (10 segundos por defecto, 30 segundos para SSH).
- I-2. Toda sonda tiene una alternativa degradada (que falle una sonda no significa que falle el disparo).
- I-3. Los conflictos se resuelven por prioridad anclada en una justificación, no por la primera coincidencia.
- I-4. Detección de obsolescencia del estado (más de 24 horas de antigüedad dispara un nuevo recorrido completo).
- I-5. Recuperación tras un fallo en el arranque en frío (ramas que quedaron abiertas, bloqueos caducados, estado sin confirmar).
- I-6. Concurrencia basada en arrendamientos. Cada tipo de bucle tiene su propio archivo de bloqueo. Dos disparos simultáneos del mismo tipo de bucle no pueden colisionar.
- I-7. La acción por defecto de no hacer nada equivale a explícitamente neutro, a la vista. Los disparos silenciosos sin acción son imposibles.
- I-8. Registro de auditoría por disparo. Se registran los resultados de las sondas, la decisión, la acción y la verificación.
- I-9. La verificación posterior a la acción es obligatoria. Si la verificación falla, se REVIERTE, no se reintenta.
- I-10. Tope de coste por disparo (200 000 tokens). Los bucles desbocados quedan acotados.
- I-11. Cesión ordenada ante la interrupción del operador. Un archivo STOP a mitad de un disparo significa una salida limpia, sin estados a medias.
- I-12. Seguro para el arranque inicial. Funciona en la primera ejecución, cuando los archivos de estado aún no existen.
- I-13. Aislamiento por worktree. Cada bucle opera en su propio worktree de git: un directorio de trabajo separado, el mismo repositorio
.gitcompartido. Sin esto, dos bucles que comparten un árbol de trabajo colisionan en cada checkout y cada pull. No aprenda esta lección por las malas; configúrelo desde el principio.
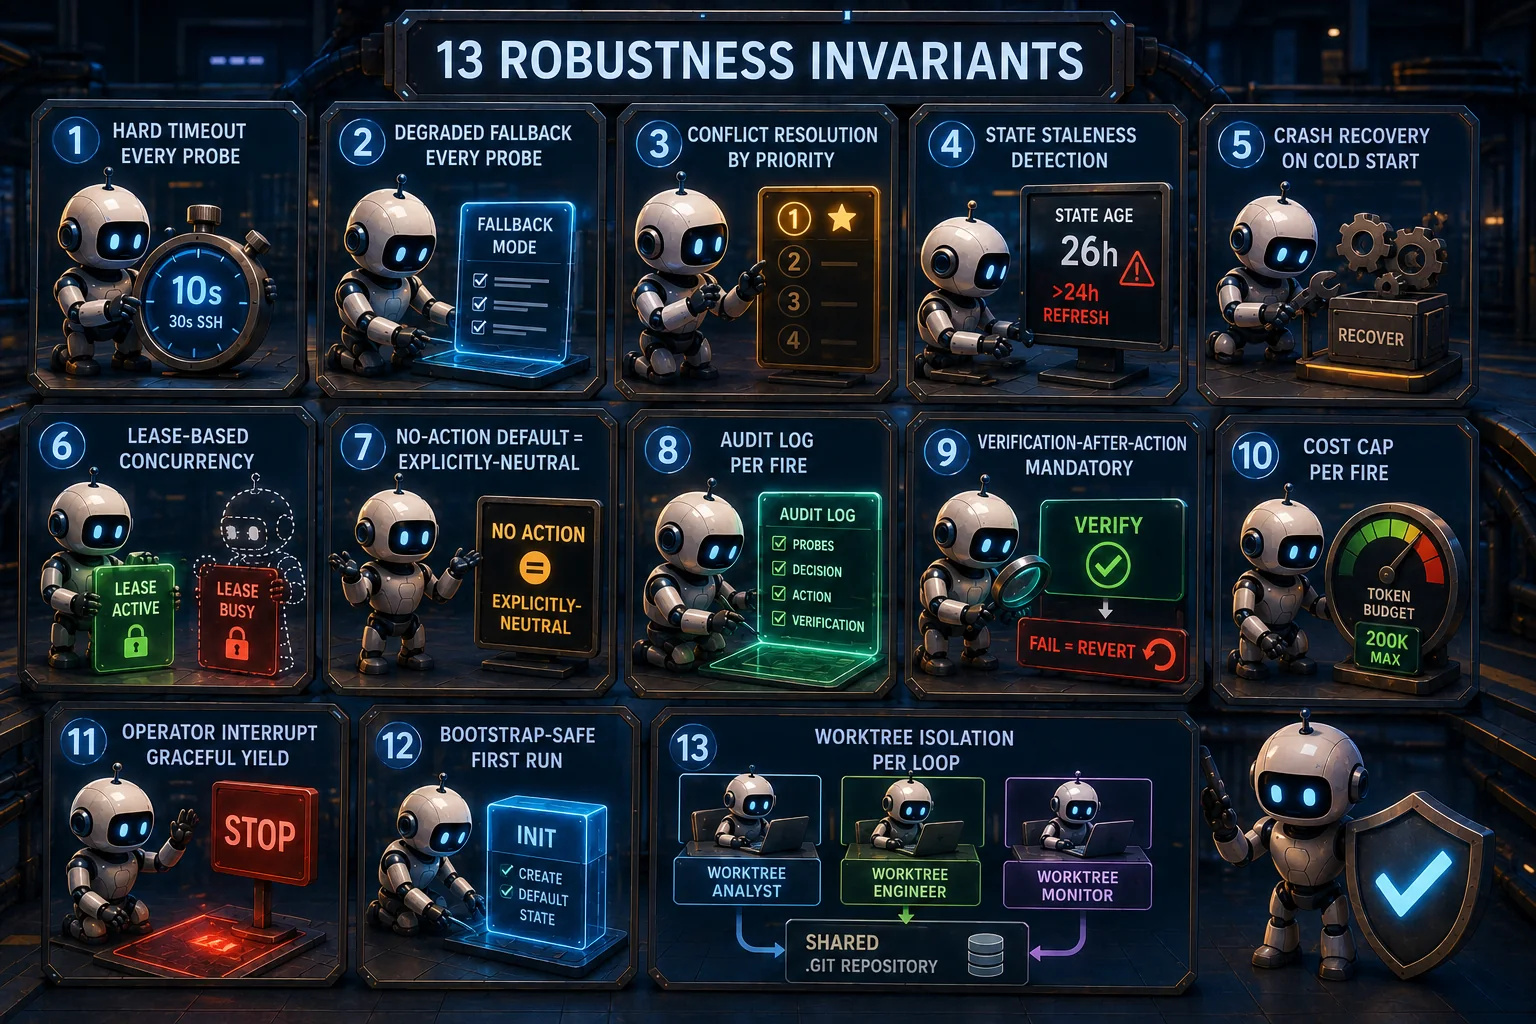
I-13 es la que añadí después de esta sesión. Las otras doce las tenía bien. El patrón de colisión que evita I-13 se describe en la sección «Lo que aún rompe este patrón» más abajo.
La matriz de modelo y modo de razonamiento
Las plataformas modernas de agentes de programación permiten elegir el tamaño del modelo Y el modo de razonamiento (normal o razonamiento extendido con un presupuesto explícito de razonamiento). La diferencia de coste entre la opción más barata y la más cara es de unas 60 veces. Si cada actividad usa por defecto «el modelo más inteligente con el razonamiento más profundo», se gasta dinero en trabajo rutinario que no se beneficia de la profundidad.
La correspondencia entre actividad y modelo:
- Revisión rutinaria de PR por bot: modelo más pequeño, razonamiento normal. Se trata de reconocer patrones frente a reglas; no hace falta razonamiento nuevo.
- Revisión de código de un cambio sustancial: modelo más grande, razonamiento extendido (16k+ tokens). La corrección sutil requiere profundidad.
- Sondeo de estado en el arranque en frío: modelo más pequeño, razonamiento normal. Es mecánico; la profundidad se desperdicia.
- Síntesis entre polos, como la detección de deriva: modelo más pequeño, razonamiento extendido (~8k tokens). La comparación de múltiples fuentes se beneficia de algo más de razonamiento.
- Causa raíz de una convergencia estancada: modelo más grande, razonamiento extendido (16k tokens). Diagnóstico de fallos a nivel de sistema.
- Decisión de arquitectura que se calcifica: modelo más grande, razonamiento extendido (16k+ tokens). Una arquitectura equivocada cuesta semanas; pague por la profundidad.
- Depuración rutinaria con patrones conocidos: modelo más pequeño, razonamiento normal. Es una consulta.
- Depuración novedosa de más de 30 minutos: modelo más grande, razonamiento extendido (16k+ tokens). La profundidad compensa.
- Auditoría de seguridad: modelo más grande, razonamiento extendido (16k+ tokens). Razonamiento sutil sobre el modelo de amenazas.
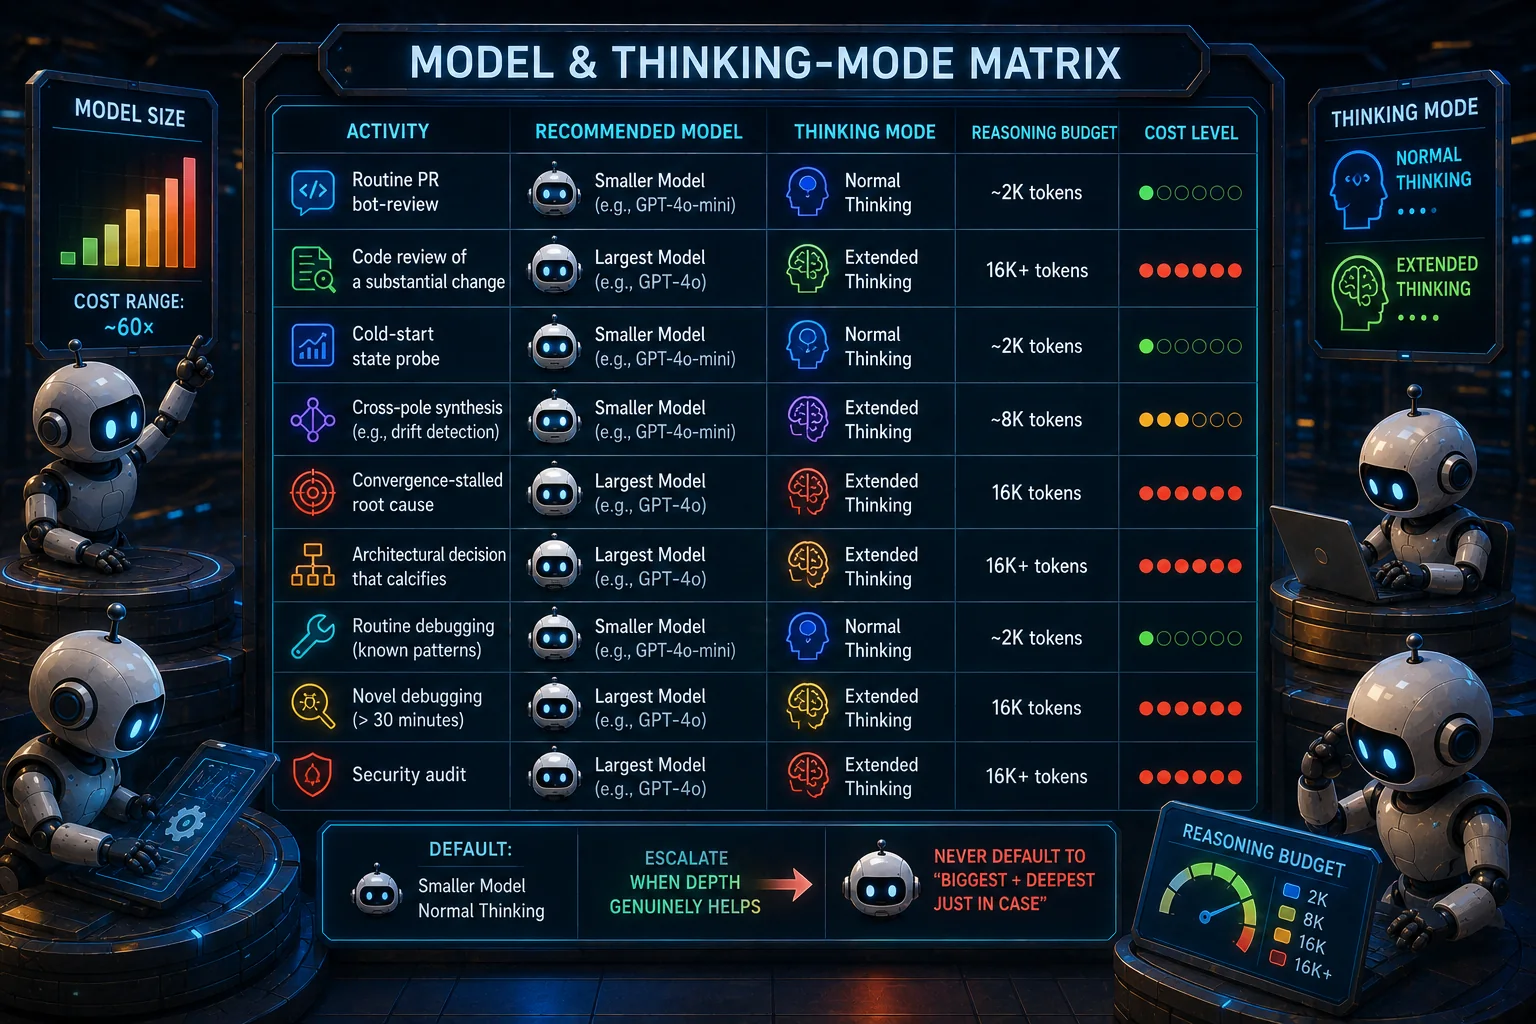
Por defecto: modelo más pequeño y razonamiento normal. Escale cuando la profundidad ayude de verdad. Nunca use por defecto «el más grande y el más profundo por si acaso»: la mayor partida de coste de cualquier sistema de agentes son los subagentes que heredan el modelo del padre cuando deberían sustituirlo por otro más barato.
La frontera entre agente y operador
La regla más importante: los agentes no traspasan trabajo en silencio al operador humano.
Cuando un sistema de programación autónomo no puede hacer algo (experiencia de dominio, posicionamiento de mercado, pruebas con usuarios reales, decisiones de modelo de negocio), surge la tentación de escribir «el operador debería…» en la documentación. Eso no es honesto. Es descargar las partes difíciles justo cuando el operador está menos preparado para asumirlas (al principio de la vida del producto, cuando todavía no hay MVP).
Lo que los agentes SÍ entregarán: subir las calificaciones de las funciones de rotas a funcionales; pulido de diseño; análisis competitivos a partir de fuentes públicas; profundidad de integración; pruebas de UX previas a los clientes (mediante el bucle probador con perfil de usuario); flujos de incorporación; funciones de informes.
Lo que solo el operador puede decidir: la prioridad estratégica (qué función importa más para el mercado que conoce); el modelo de negocio; la preferencia estética final entre dos diseños conformes; la autorización explícita de saltarse una regla (cuando un agente dice «esta prueba es inestable, ¿puedo saltarla?»); la reclasificación de los niveles de prioridad.
Las pruebas con clientes reales se APLAZAN, no se transfieren. Traer usuarios reales antes del MVP gasta buena voluntad con un producto roto. El bucle probador con perfil de usuario los sustituye hasta alcanzar el umbral del MVP. Entonces llegan los usuarios reales para encontrar lo que el probador simulado pasó por alto.
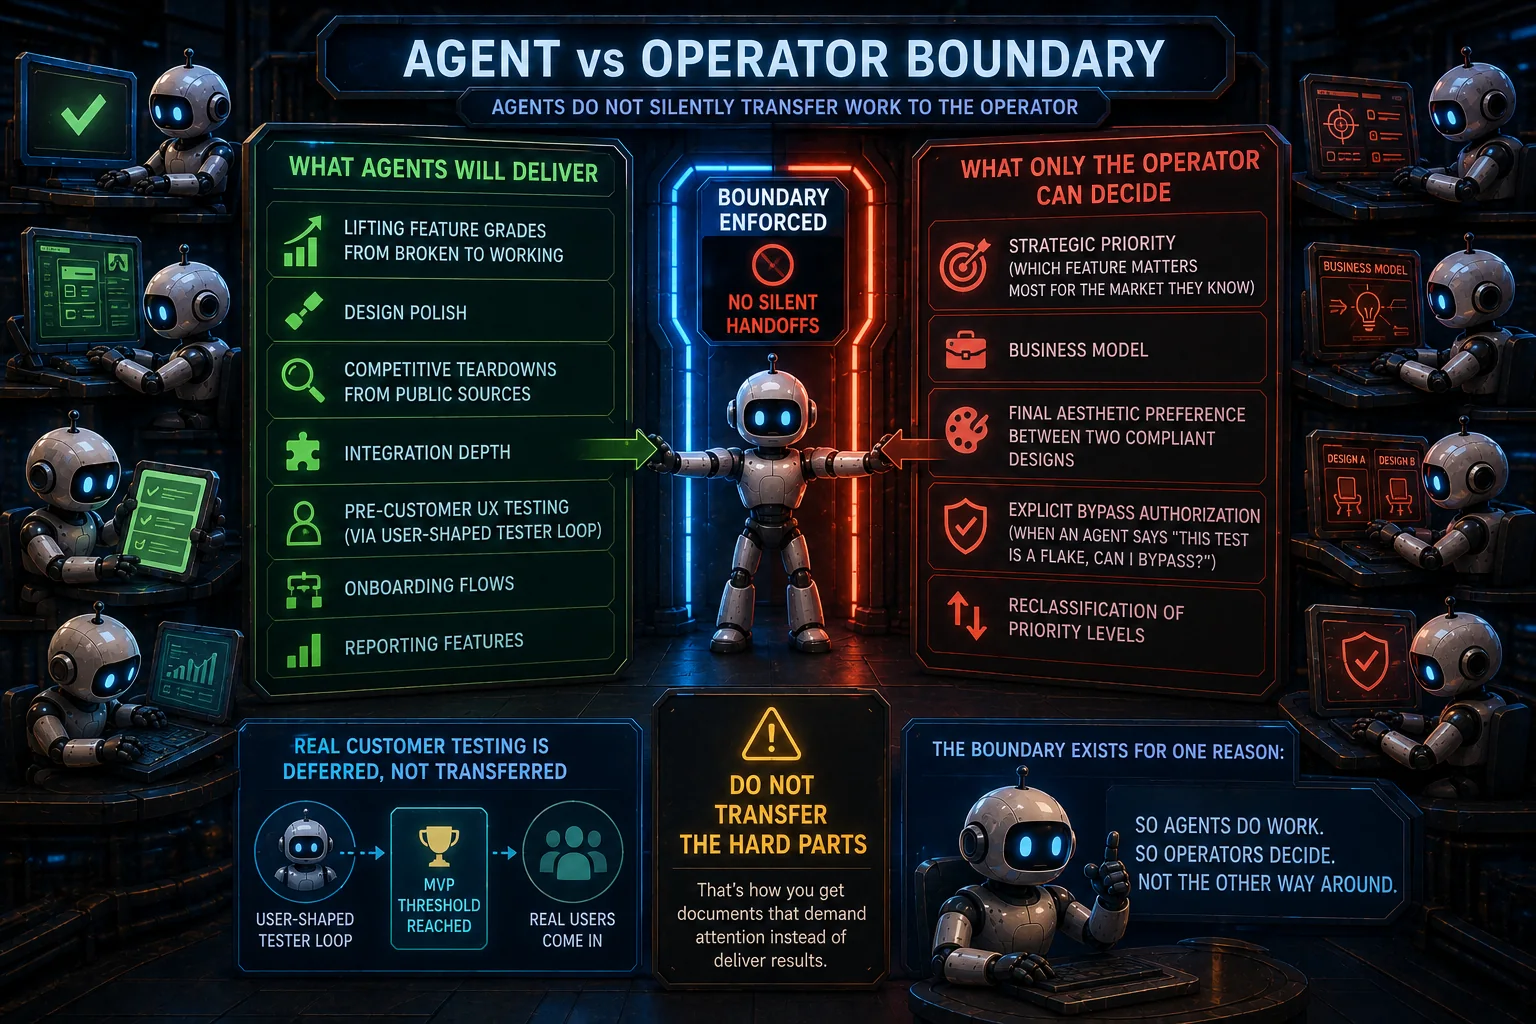
Esta frontera es la que más necesitan hacer cumplir los operadores. Sin ella, el sistema de agentes se convierte en algo que exige la atención del operador en lugar de algo que hace trabajo.
El único archivo de estado canónico
Los cuatro bucles, todas las reglas de disciplina, todos los protocolos: no sirven de nada si no existe una definición compartida de «cuál es el estado de la plataforma ahora mismo».
Un solo archivo. Una tabla de tendencias en la que solo se añade. Cada fila, una instantánea en el tiempo. Las columnas son las métricas que le importan al producto: calificaciones por área funcional, tasas de éxito, número de bloqueos, profundidad de las colas.
Todos los bucles leen este archivo en el arranque en frío. Los disparos convergentes lo actualizan. Los disparos neutros a la deriva, no. Pasada una semana o dos, la tendencia de este archivo ES la respuesta a «¿están produciendo convergencia los agentes?».
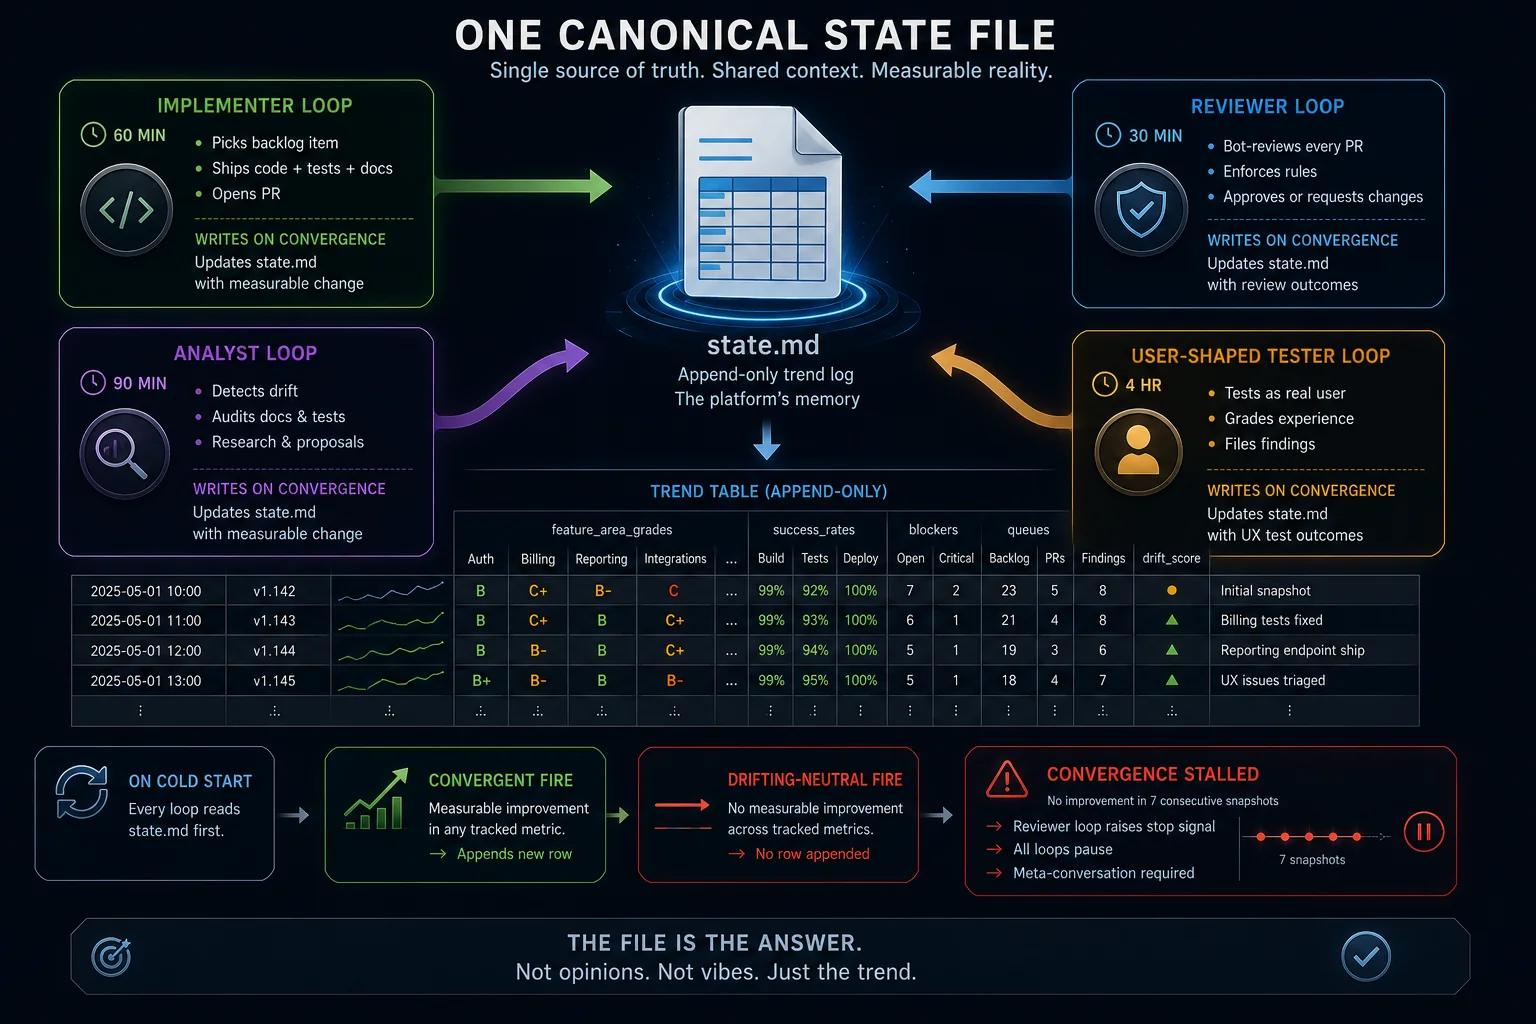
Si 7 instantáneas consecutivas no muestran movimiento, el bucle revisor hace aflorar «convergencia estancada: pausar los bucles, hace falta una metaconversación». El archivo es la válvula de seguridad que atrapa el caso en que cada disparo individual presume de productivo pero el conjunto no lo es.
Lo que aún rompe este patrón
Esta es la sección que el borrador original de este artículo no tenía. Me costó una sesión de deriva añadirla.
Deriva del autor
La persona (o el agente) que escribe una regla la infringe de forma rutinaria antes de que se seque la tinta. Entregué una disciplina por artefacto que decía «todo artefacto se entrega FUNCIONAL, LISTO PARA FUNCIONAR o STUB CON COLA», y en la misma sesión entregué un árbol de documentación con 16 enlaces markdown colgantes que no encajaban en ninguno de esos estados. El bucle analista lo detectó en cuestión de horas. Yo era el autor de la regla que señaló mi propia infracción.
La consecuencia: la autoaplicación de la disciplina no funciona. Los bucles revisor y analista no son un lujo; son lo único que detecta la deriva del autor. Constrúyalos primero. Las reglas que usted mismo escribe no lo atarán sin una aplicación externa.
Colisiones por árbol de trabajo compartido
Si ejecuta los cuatro bucles desde el mismo directorio físico, colisionarán en cada operación de git. Un bucle hace git checkout <branch> y el git status del otro bucle de pronto informa de una realidad distinta. Los commits a medio fusionar se atribuyen a la sesión equivocada. Los archivos sin seguimiento aparecen y desaparecen según la rama que haya dejado el último bucle.
La solución es el invariante I-13 de arriba: cada bucle opera en su propio worktree de git. Directorio de trabajo separado, base de datos .git compartida. El comando git worktree add es una sola línea y resuelve para siempre toda esa clase de fallos.
Lo aprendí colisionando una y otra vez con mi propio bucle analista mientras ejecutaba una sesión principal de operador directo en el mismo directorio.
Trampas del lanzador
Tres trampas con las que se topará antes incluso de que los bucles empiecen a dispararse.
- Trampa 1: Los prompts de varias líneas se truncan. El paso de argumentos de procesos en Windows termina en el primer salto de línea. Un briefing de 3300 caracteres pasado como argumento posicional al binario del agente llega al binario como los primeros 70 caracteres. Use el parámetro de entrada basado en archivo (
--append-system-prompt-file <path>o equivalente) o canalice por stdin: cualquier cosa que no ponga saltos de línea en argv. - Trampa 2: Los comandos con barra son solo de interfaz. Si su briefing indica al agente que invoque
/rename "Dev /loop"como primera acción, no podrá. Los comandos con barra los gestiona la interfaz de usuario, no el agente. Fije en su lugar el nombre de la sesión al lanzarla (la mayoría de las plataformas tienen un parámetro-no--name) y evite del todo la directiva. - Trampa 3: El paso de argumentos nativos de PowerShell 5.1 no es fiable. Los espacios, apóstrofos y barras en los valores de los argumentos pueden alterarse cuando PS 5.1 los entrega a un ejecutable nativo mediante el modo
-File. El diagnóstico es inequívoco: invocar el mismo ejecutable manualmente desde un PowerShell interactivo funciona; invocarlo mediante cmd → powershell -File script.ps1 -Param "value" falla. La solución: eliminar la capa de PowerShell y hacer que cmd invoque directamente el ejecutable nativo.
Las tres me las encontré en una sola sesión. Ninguna es exótica: son imprescindibles en cualquier configuración con host Windows. Ninguna está documentada en los README de las plataformas de agentes. Reserve un día para descubrirlas.
La desconexión entre coste y valor
La misma sesión que produjo este artículo costó aproximadamente 157 dólares en cómputo equivalente a la API (la suscripción real es fija; la cifra en dólares es lo que costaría ese mismo trabajo con pago por uso). La sesión produjo nueve pull requests fusionadas de doctrina, infraestructura y proceso. Produjo cero mejoras de producto visibles para el usuario. La corrección de producto que subí al principio de la sesión nunca llegó a producción porque la compuerta de despliegue la rechazó, por 15 pruebas fallidas más los 16 enlaces markdown colgantes que entregué.
Esta es la desconexión entre coste y valor, dicha sin rodeos. La disciplina que describo en este artículo se construyó a lo largo de esa misma sesión. El estado medible de la plataforma no mejoró. La infraestructura para que las sesiones futuras lo mejoren existe ahora, y conviene ser honesto con uno mismo (y con su operador) cuando ese es el trato que ha hecho.
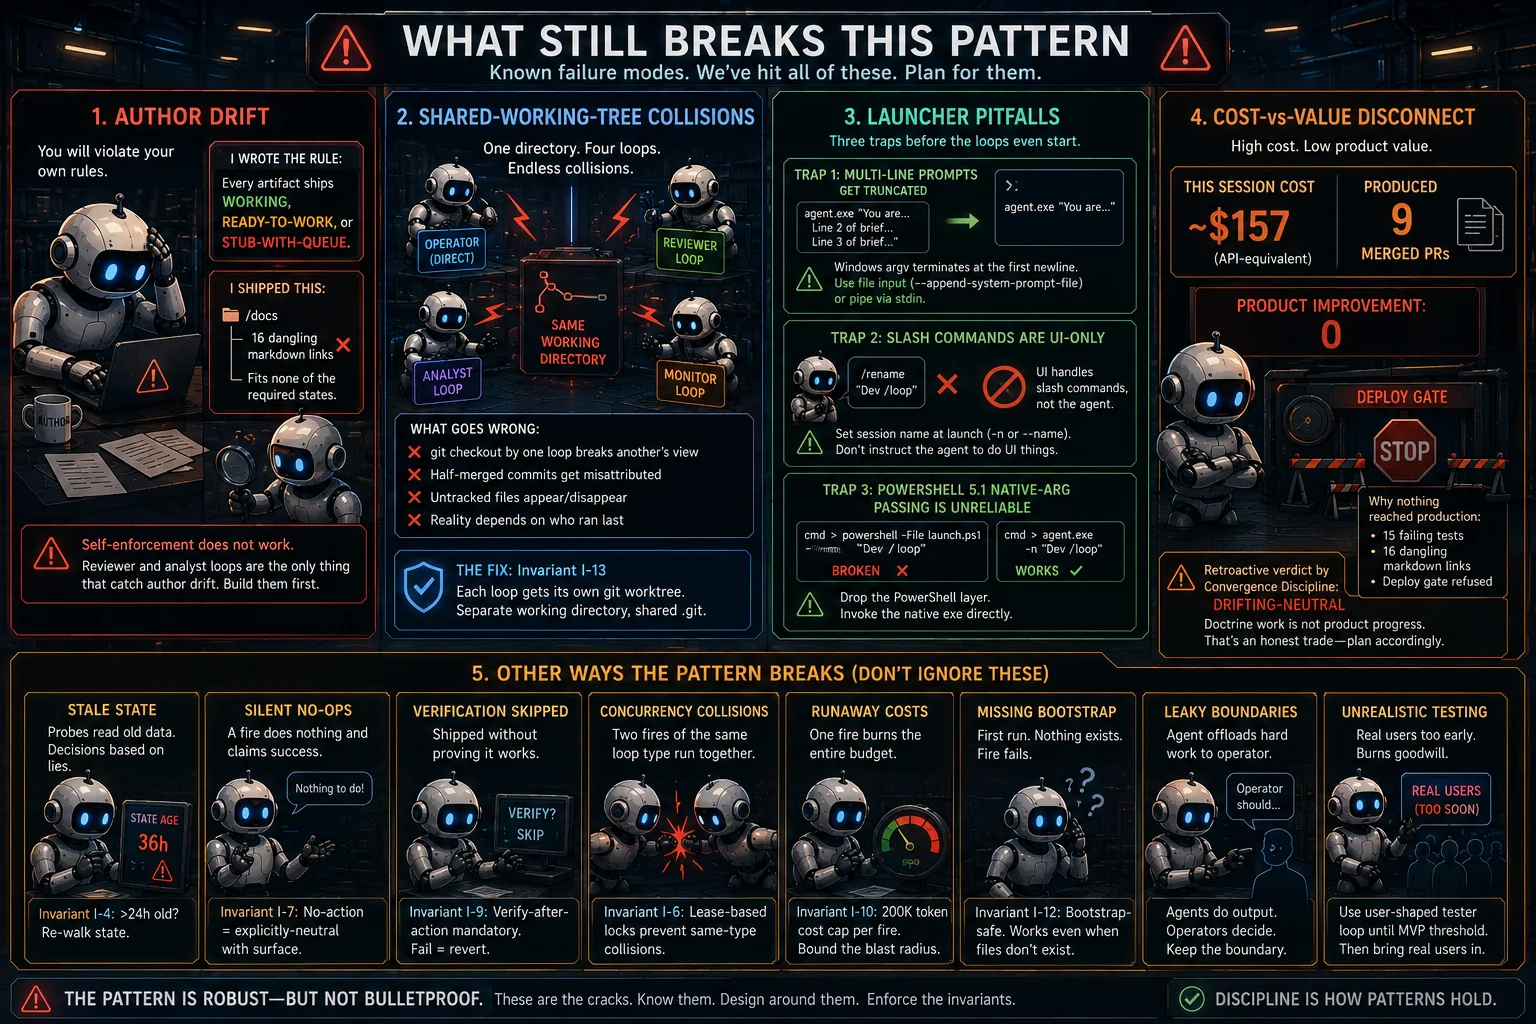
La regla de disciplina de convergencia, aplicada con carácter retroactivo, habría señalado toda la sesión como NEUTRA A LA DERIVA. Esa es la regla funcionando como debe. También le dice algo incómodo: una sesión pensada para producir un artículo sobre disciplina difícilmente puede además producir progreso de producto, porque cada minuto dedicado a la doctrina es un minuto que no se dedica a la función. Planifique en consecuencia.
Lo que esto NO hará
Límites honestos de lo que la disciplina puede y no puede ofrecer:
- Llevará cada área funcional de rota a funcional. No alcanzará la calificación máxima absoluta sin métodos de flujo de trabajo de nivel de dominio y verificación de cambios de estado.
- Entregará una estética lista para producción mediante una compuerta de sistema de diseño. No creará la base estética inicial: el operador elige el lenguaje de diseño.
- Reunirá análisis competitivos de paridad de funciones a partir de fuentes públicas. No decidirá el posicionamiento estratégico frente a los competidores establecidos: eso es el conocimiento de mercado del operador.
- Realizará pruebas de UX previas a los clientes mediante un agente simulado de usuario poco experto. No encontrará los problemas reales de los clientes: los usuarios reales llegan después del MVP.
- Sostendrá la convergencia a un coste conocido. No le llevará del MVP a «el mejor del mercado»: eso requiere insumos que los bucles no tienen.
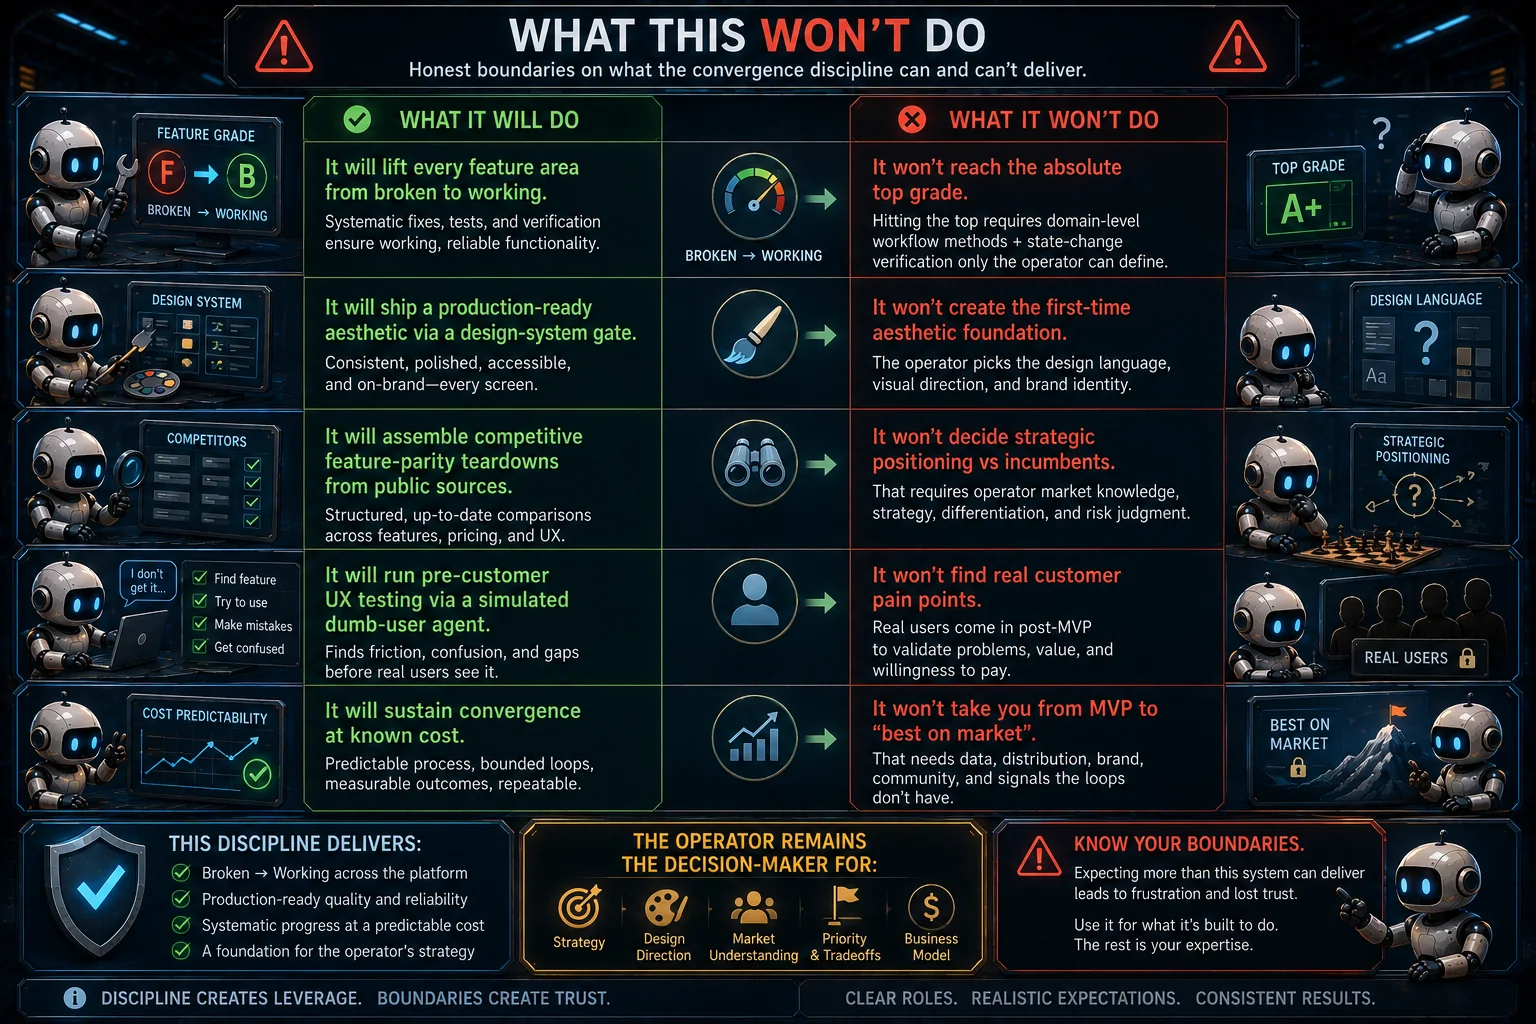
Nombrar lo que no ocurrirá forma parte de la disciplina. Sin ello, los operadores esperan más de lo que el sistema puede dar y pierden la confianza cuando se queda corto.
Lo que cuesta
Una sesión de cuatro bucles que se ejecuta 8 horas al día con una cadencia acorde con la matriz cuesta aproximadamente lo mismo que el presupuesto mensual de herramientas de un solo ingeniero contratado de nivel medio. La suscripción real es fija; la restricción son los límites de tasa por ventana de facturación, no los dólares.
¿Y si todo se deja por defecto en el modelo más grande con el razonamiento más profundo? Entre 5 y 7 veces eso. La disciplina de la matriz es la diferencia entre una ingeniería autónoma sostenible y una factura desbocada.
Lo que cuesta por sesión es más variable. Una sesión que entrega pura doctrina, como la que produjo este artículo, consume presupuesto sin producir mejora de producto. Eso no es un desperdicio si la doctrina va a rendir en convergencia durante las sesiones futuras, pero SÍ lo es si la doctrina queda sin hacerse cumplir.
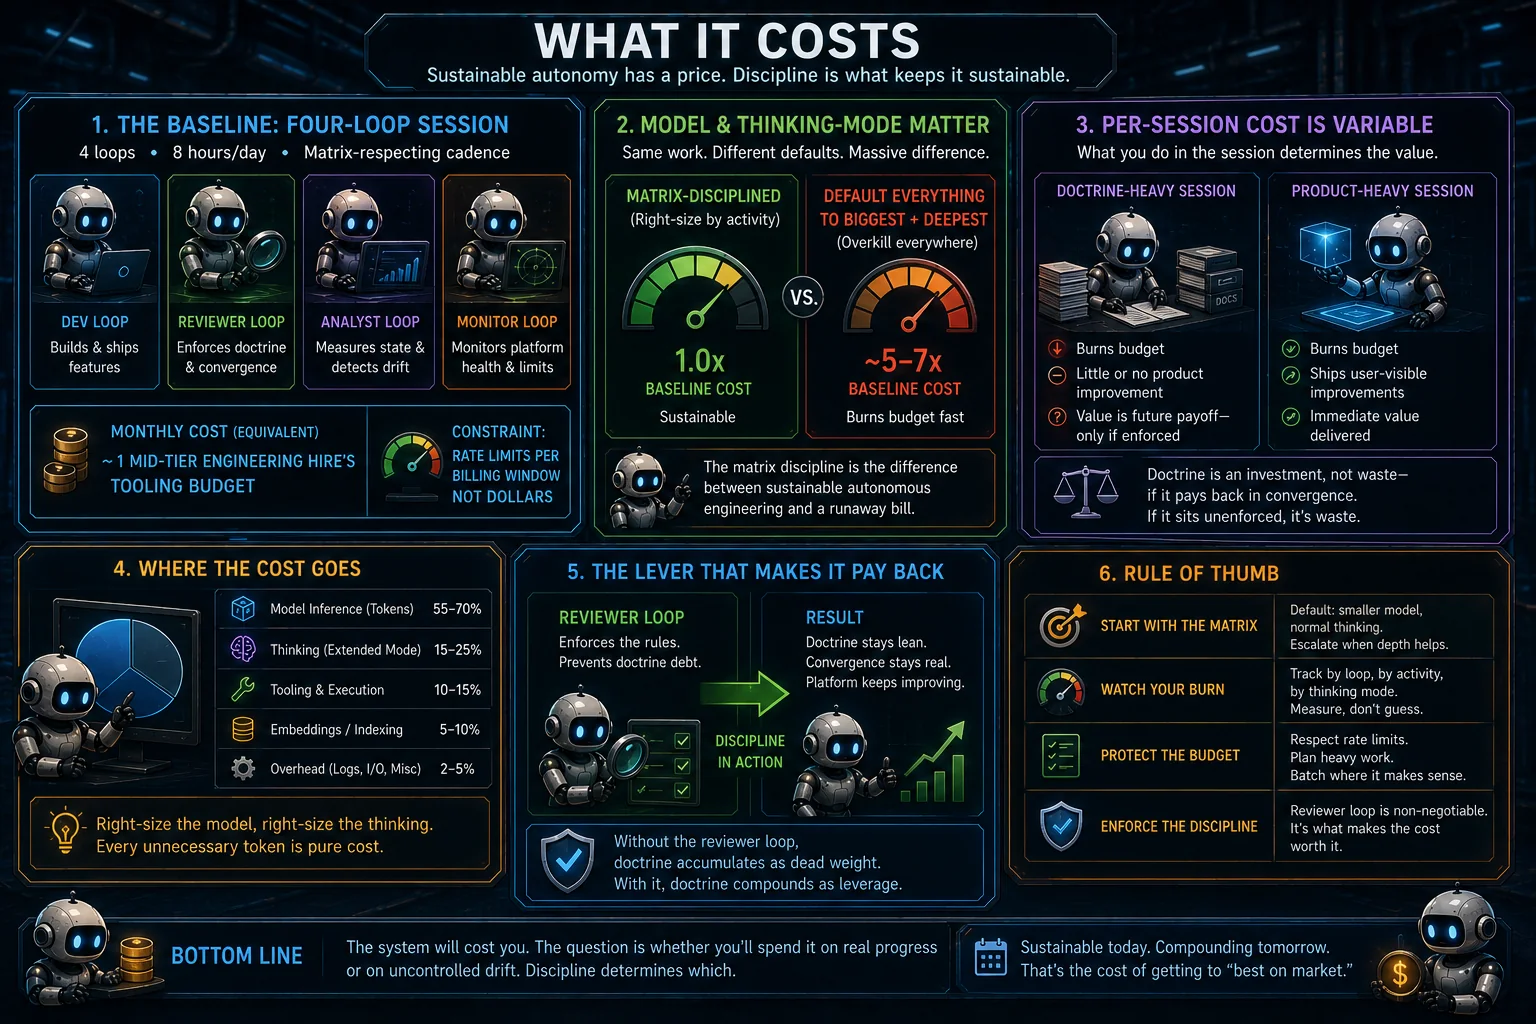
El bucle revisor es lo que hace que la doctrina rinda. Sin él, la doctrina se acumula como peso muerto.
La lección que sigo reaprendiendo
Cada vez que añado una regla, un agente o un proceso nuevo a este sistema, le añado carga al futuro. La regla de disciplina de convergencia es la única con efecto neto negativo sobre la carga: obliga a que todo lo demás que se añada se pague a sí mismo con una mejora medible.
La patología que describí al principio de este artículo, «los agentes son productivos pero el producto no avanza», es un fallo de disciplina, no un fallo de herramientas. Los agentes hacen exactamente lo que se les dice: subir commits, pasar la CI, actualizar la documentación. Simplemente no se les dijo que los commits tenían que mover un eje medible.
Cuando se lo dice, con reglas explícitas por disparo y por artefacto, con un único archivo de estado canónico, con la separación de responsabilidades en cuatro bucles, con el límite honesto de lo que solo los humanos pueden hacer y con aislamiento por worktree para que no colisionen, los agentes pasan a ser útiles.
No mágicos. Útiles. A veces.
Ese «a veces» es lo que se le escapó al borrador original de este artículo. La disciplina es el objetivo. Aun con ella por escrito, aun con las reglas explícitas, aun con el bucle revisor en marcha, usted (y sus agentes) se desviarán. La deriva se detecta —para eso está el bucle analista—, pero no se previene. El mecanismo se corrige a sí mismo, pero no se previene a sí mismo.
Esa distinción importa. La literatura sobre herramientas de ingeniería con IA está llena de afirmaciones «mágicas». La realidad es otra: un pequeño conjunto de patrones disciplinados, aplicados con rigor por otros agentes (no por autodisciplina), que hacen que los agentes autónomos hagan trabajo real la mayor parte del tiempo y que la deriva se detecte y se corrija el resto. Todo lo demás es teatro.
Si está ejecutando agentes de programación sobre una base de código real y ve los modos de fallo que he descrito, los patrones de arriba quizá le ayuden. No son novedosos; la mayoría son codificaciones de lo que ya hacen los buenos equipos de ingeniería. La novedad está en convertirlos en pilares de los bucles autónomos, donde no hay ningún humano en el camino inmediato que los haga cumplir de forma implícita, y en nombrar los modos de fallo que sobreviven a la disciplina de todos modos.
Anexo. Tarjeta de consulta
Esta página es una copia íntegra del artículo tal como se publicó en Medium. Léalo en Medium. Ilustraciones generadas con IA.