
Medium · Automatisation, Web scraping · Brouillon
Quand l’API ne suffit pas : l’extraction de données assistée par navigateur, pour le compte de l’utilisateur
Les plateformes SaaS modernes exposent souvent des API publiques. En théorie, cela devrait rendre simples les intégrations, le reporting, la collecte de preuves de conformité, l'analytique et l'automatisation.
Publié pour la première fois sur Medium le 26 mai 2026. Lire sur Medium. 8 min de lecture.
En pratique, l'API disponible ne suffit pas toujours :
- Parfois, l'API publique n'existe pas.
- Parfois, elle existe, mais n'expose qu'un sous-ensemble limité des données.
- Parfois, les données sont visibles dans l'application web mais ne sont pas disponibles par des points d'accès documentés.
- Et parfois, la fonction d'export se limite à un fichier CSV qui n'inclut ni les métadonnées, ni les relations, ni les commentaires, ni l'historique, ni la piste d'audit nécessaires à une finalité professionnelle légitime.
Cela crée un problème pratique : l'utilisateur est autorisé à accéder à l'information, l'information est visible dans l'application, mais il n'existe aucun mécanisme officiel adéquat pour la récupérer de façon structurée et reproductible.
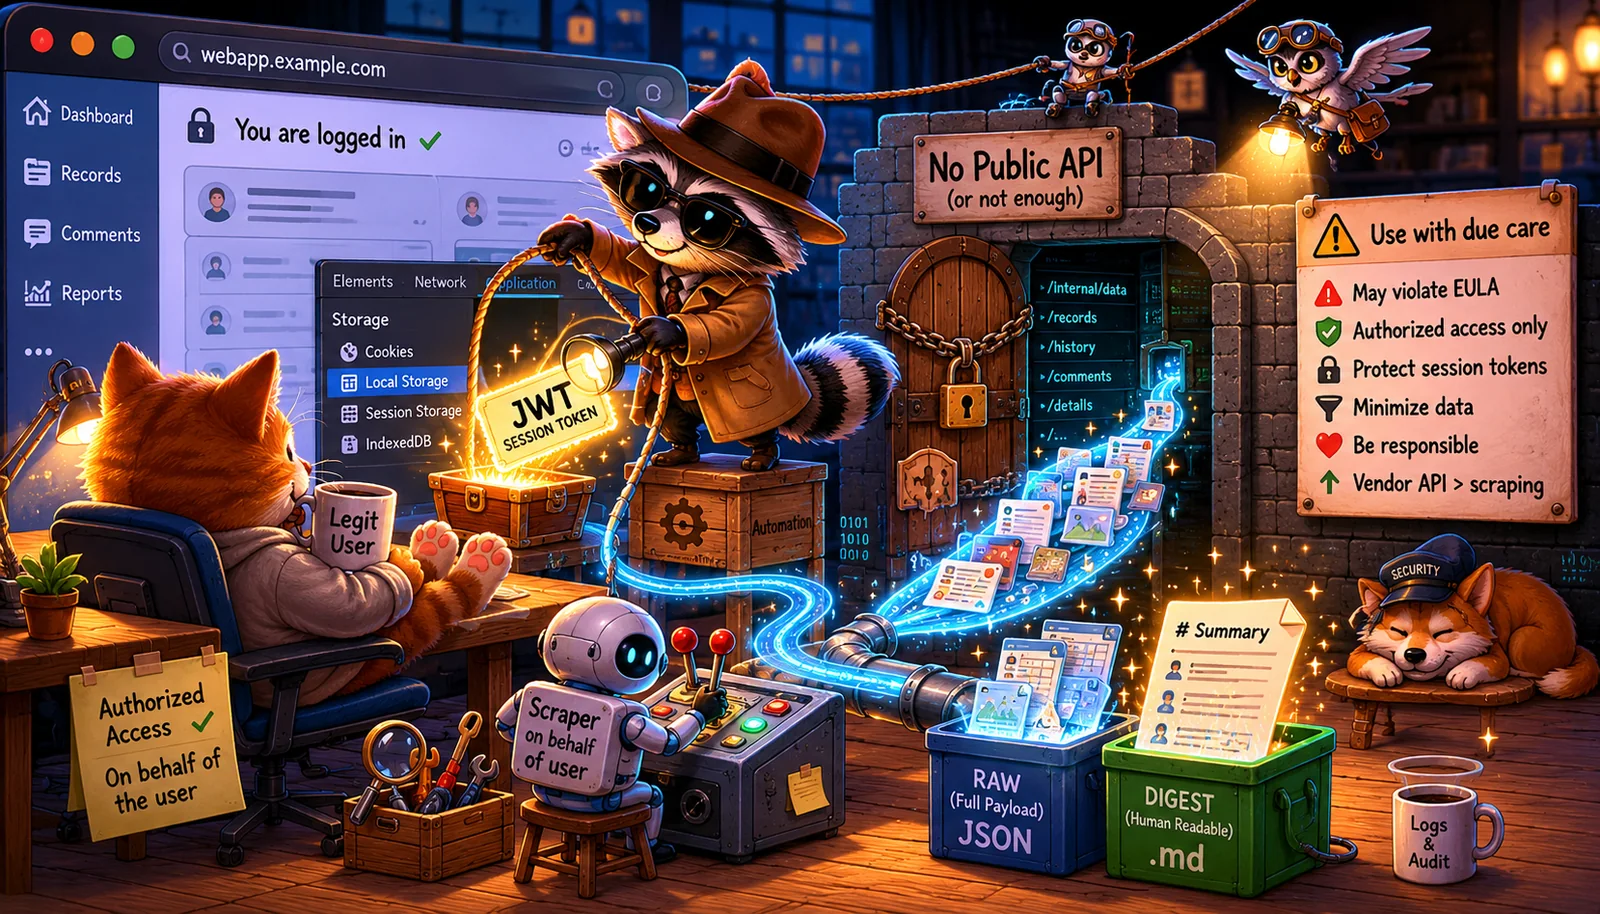
Dans ces cas-là, l'extraction de données assistée par le navigateur peut devenir un contournement pratique.
1. Pas de l'automatisation robotisée des processus (RPA)
Cette approche peut ressembler à la Robotic Process Automation (RPA), mais ce n'est pas tout à fait la même chose.
La RPA traditionnelle imite généralement l'interface utilisateur : elle clique sur des boutons, remplit des formulaires, fait défiler des pages, attend le chargement des écrans et lit les éléments visibles. Elle traite l'application web comme un espace de travail visuel et automatise les mêmes étapes qu'un humain effectuerait à la main.
L'extraction assistée par le navigateur opère à un autre niveau. Le navigateur sert toujours à l'authentification légitime de l'utilisateur et au contrôle d'accès, mais la collecte des données proprement dite s'effectue en observant et en réutilisant les propres échanges de l'application avec son backend. Au lieu de recopier des valeurs depuis l'écran, l'automatisation récupère les données structurées que l'application reçoit déjà pour afficher cet écran.
En termes simples :
- La RPA automatise ce que l'utilisateur fait sur la page.
- L'extraction assistée par le navigateur automatise ce que la page fait en coulisses pour le compte de l'utilisateur.
Cette distinction compte. L'extraction assistée par le navigateur est généralement plus stable, plus rapide et plus complète que l'automatisation visuelle de l'interface, car elle peut travailler sur des charges utiles structurées plutôt que sur des éléments d'interface rendus. En même temps, elle demande plus de précautions, car elle peut s'appuyer sur le comportement interne de l'application, des points d'accès non documentés, des cookies, le stockage de session, le stockage local ou d'autres artefacts liés à la session.
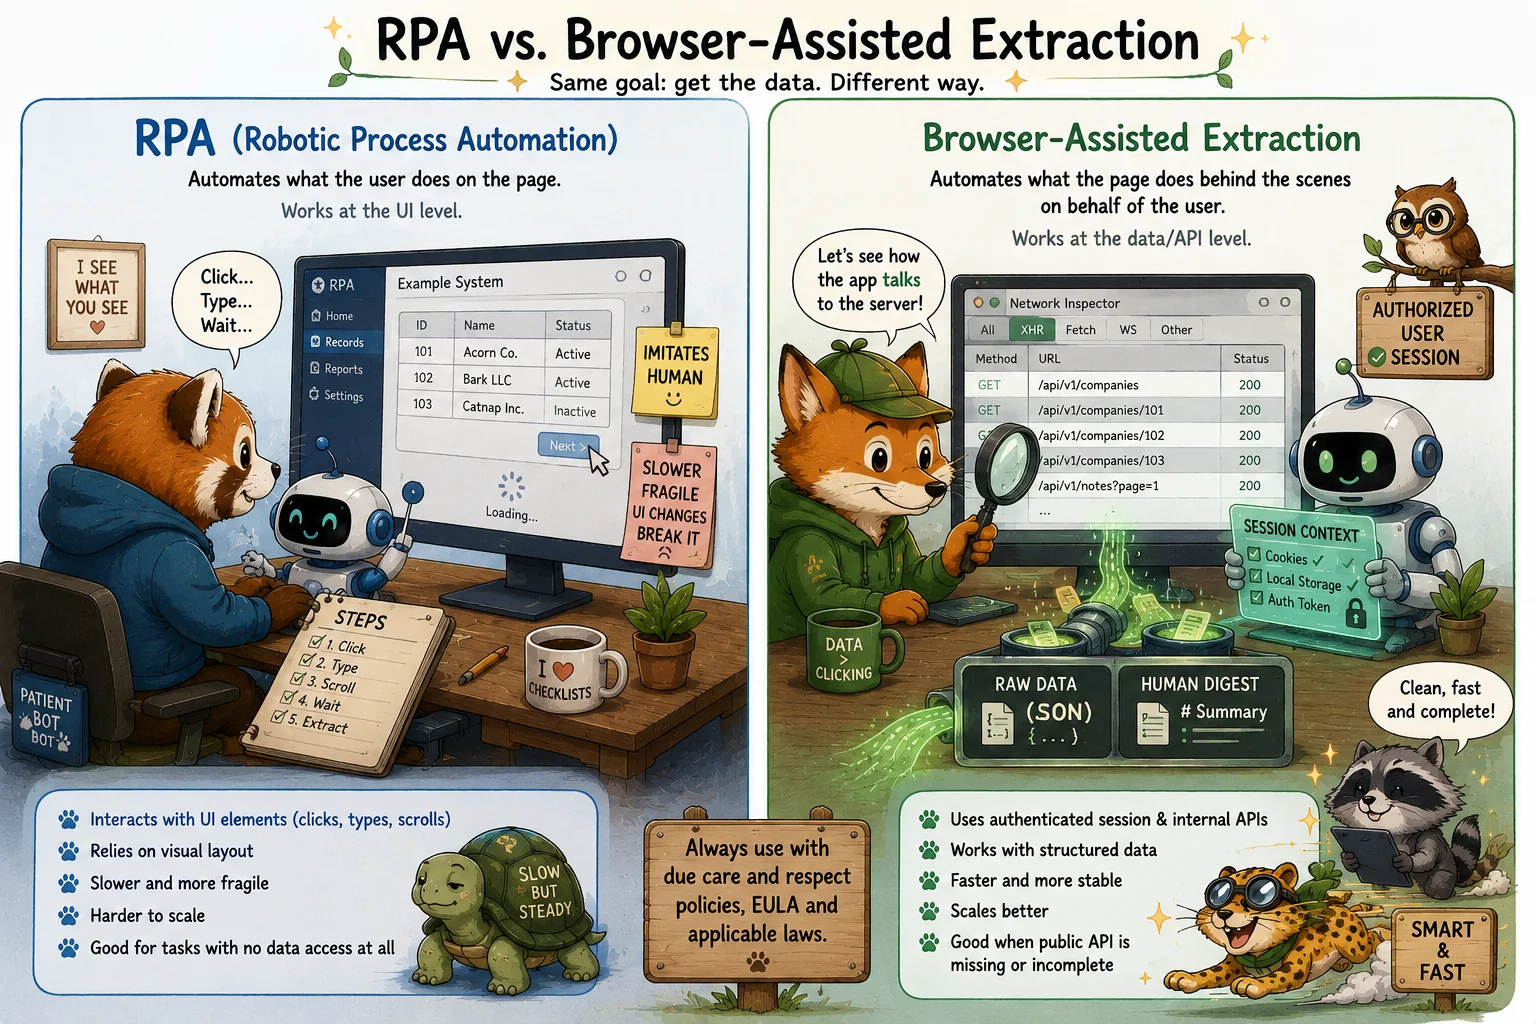
Ce modèle doit donc être traité comme un contournement maîtrisé. Il ne remplace ni une API officielle, ni une intégration prise en charge, ni une fonction d'export correctement documentée. Il est plus proche de la « découverte d'API par la session authentifiée du navigateur » que de la RPA classique.
Le principe reste le même : l'automatisation doit agir uniquement pour le compte d'un utilisateur autorisé, ne collecter que les données auxquelles l'utilisateur a le droit d'accéder, et être employée en tenant compte des considérations juridiques, contractuelles, de vie privée et de sécurité.
2. Le scénario
Supposons un système utilisé par une entreprise pour la gouvernance, la conformité, les opérations ou l'administration interne.
Le système a une interface web. Les utilisateurs autorisés peuvent s'y connecter, naviguer parmi les enregistrements, consulter les détails, et exporter ou copier manuellement des informations. Cependant, le système présente l'une des limitations suivantes :
- Aucune API publique n'est disponible.
- L'API publique est incomplète et n'expose pas toutes les données requises.
- La fonction d'export est insuffisante pour les besoins d'activité, d'audit, de migration ou de reporting.
- Des métadonnées importantes sont visibles dans le navigateur mais indisponibles par les méthodes d'intégration documentées.
- L'extraction manuelle serait lente, sujette aux erreurs et difficile à reproduire.
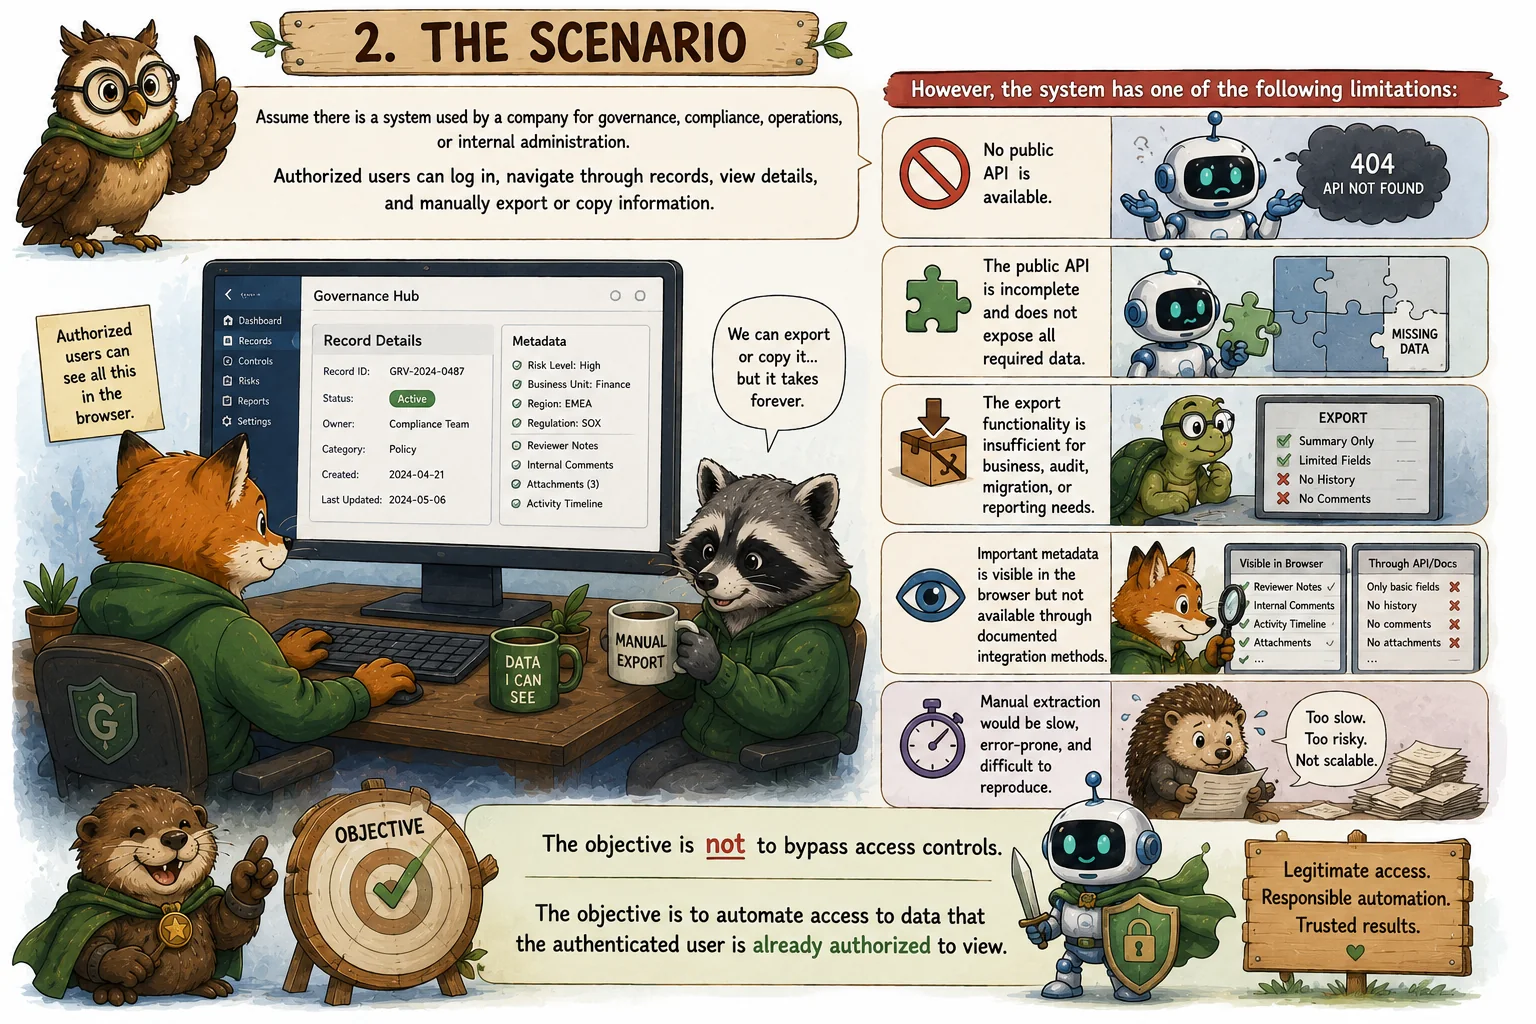
L'objectif n'est pas de contourner les contrôles d'accès. L'objectif est d'automatiser l'accès aux données que l'utilisateur authentifié est déjà autorisé à consulter.
3. L'approche générale
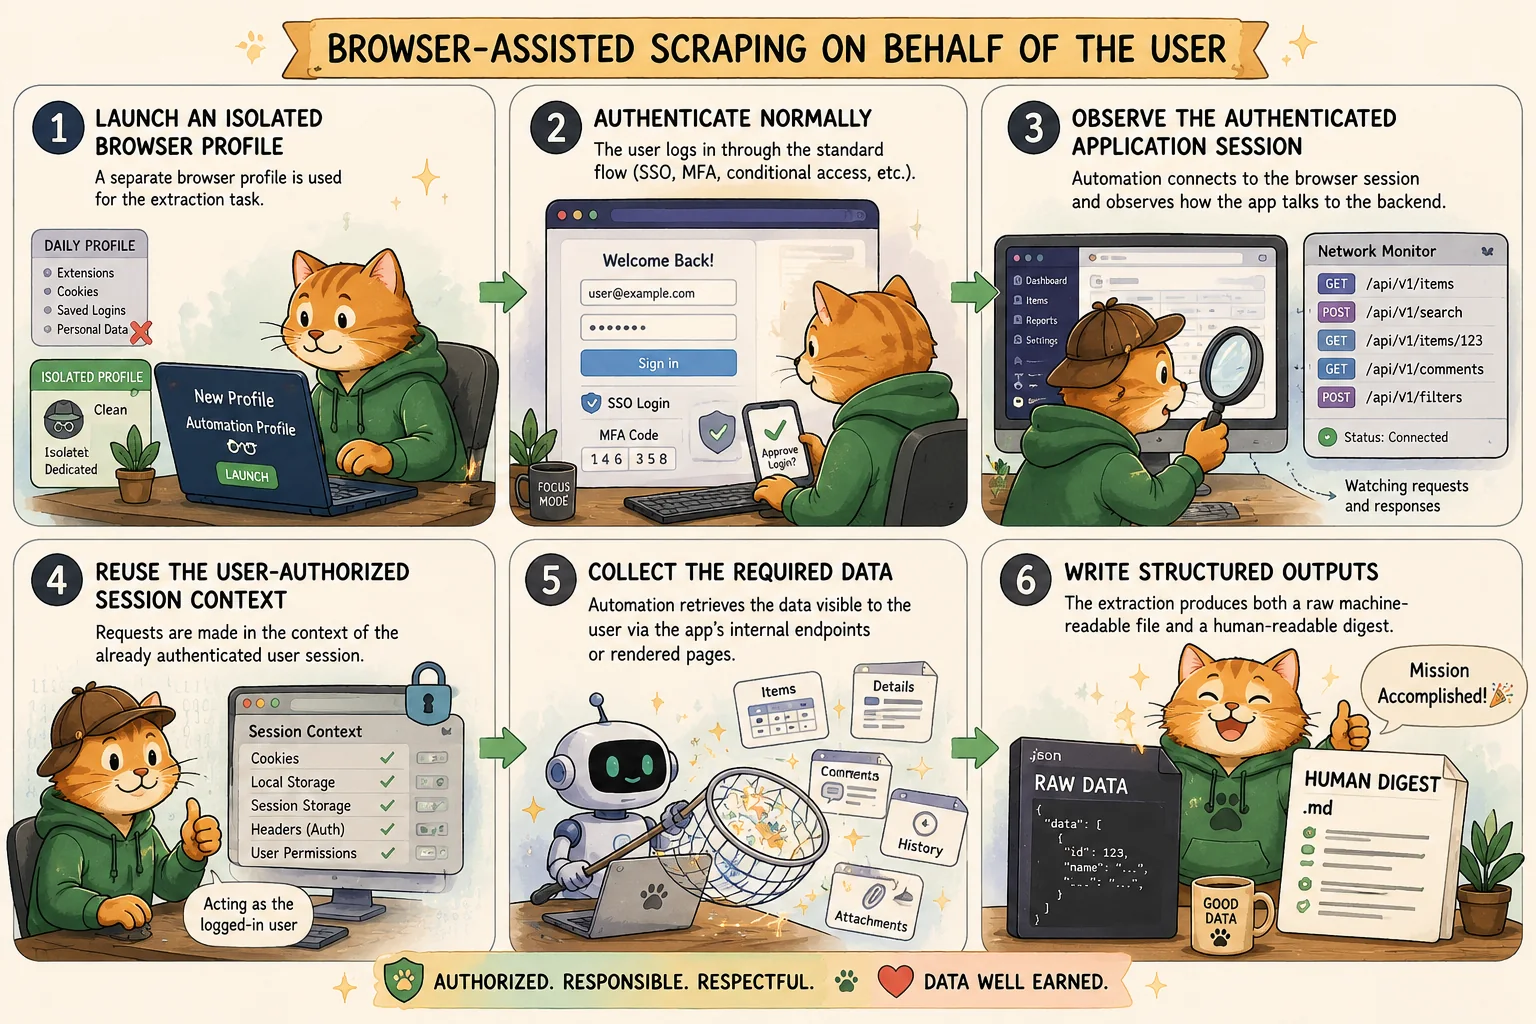
Le schéma général est du scraping assisté par le navigateur, pour le compte de l'utilisateur.
Un flux de travail typique peut se présenter ainsi :
- Lancer un profil de navigateur isolé. Un profil de navigateur distinct est utilisé pour la tâche d'extraction. Cela évite de mélanger la session d'automatisation avec le profil de navigation quotidien de l'utilisateur, ses extensions, ses identifiants enregistrés, ses cookies sans rapport et ses sessions personnelles.
- S'authentifier normalement. L'utilisateur se connecte par l'interface web habituelle, avec le parcours d'authentification normal, y compris SSO, MFA, accès conditionnel ou tout autre contrôle exigé par le système.
- Observer la session authentifiée de l'application. Après l'authentification, l'automatisation se connecte à la session du navigateur et observe comment l'application web communique avec son backend.
- Réutiliser le contexte de session autorisé par l'utilisateur. L'automatisation exécute des requêtes dans le contexte de la session déjà authentifiée de l'utilisateur. Dans certains systèmes, les éléments de session pertinents peuvent se trouver dans des mécanismes de stockage accessibles au navigateur, tels que les cookies, le stockage de session ou le stockage local.
- Collecter les données requises. L'automatisation récupère les données visibles par l'utilisateur via les points d'accès internes de l'application ou les pages rendues.
- Écrire des sorties structurées. L'extraction produit à la fois un fichier brut lisible par machine et une synthèse lisible par un humain (recommandée).
4. Pourquoi cela fonctionne
De nombreuses applications web sont conçues comme des clients navigateur qui dialoguent avec des services backend. Même en l'absence d'API publique, le navigateur utilise souvent lui-même des API internes pour charger les données affichées dans l'interface.
Cela signifie que le moyen le plus simple de comprendre comment récupérer toutes les informations pertinentes d'un système est parfois d'examiner comment le système lui-même les récupère pour le navigateur.
C'est la réalité pratique, et elle est inconfortable.
Sur le plan technique, l'application web sait déjà où se trouvent les données, quels points d'accès sont utilisés, quels paramètres sont requis, et comment les enregistrements sont paginés ou filtrés. L'extraction assistée par le navigateur automatise simplement ce que l'utilisateur pourrait faire à la main, à condition de rester dans les limites de ses droits d'accès légitimes.
5. Le « hack » qui n'en est pas vraiment un
Il existe une plaisanterie courante parmi les ingénieurs et les praticiens de l'automatisation de la conformité :
Le moyen le plus simple d'obtenir toutes les informations d'un système est de le « hacker ».
Dans ce contexte, « hacker » ne doit pas signifier accès non autorisé, exploitation, élévation de privilèges ou contournement de contrôles de sécurité. Cela veut dire comprendre comment l'application web fonctionne en interne et utiliser cette connaissance pour automatiser un processus par ailleurs manuel.
Par exemple, certaines applications web stockent dans le navigateur des artefacts de session temporaires afin que le frontend puisse communiquer avec les services backend. Dans certains cas, l'automatisation peut réutiliser la session authentifiée du navigateur pour extraire des données pour le compte de l'utilisateur.
Cela peut être une technique puissante quand une API officielle est indisponible ou incomplète. C'est aussi une technique à manier avec précaution, car les éléments de session sont sensibles et peuvent donner un accès équivalent à celui de l'utilisateur connecté.
6. Avis juridique et contractuel
Ce type d'automatisation doit être employé avec le plus grand soin.
Même lorsque l'utilisateur est légitimement autorisé à accéder aux données, le scraping assisté par le navigateur peut enfreindre le contrat de licence utilisateur final (EULA), les conditions d'utilisation, la politique d'utilisation acceptable, des restrictions contractuelles ou la politique de sécurité du système.
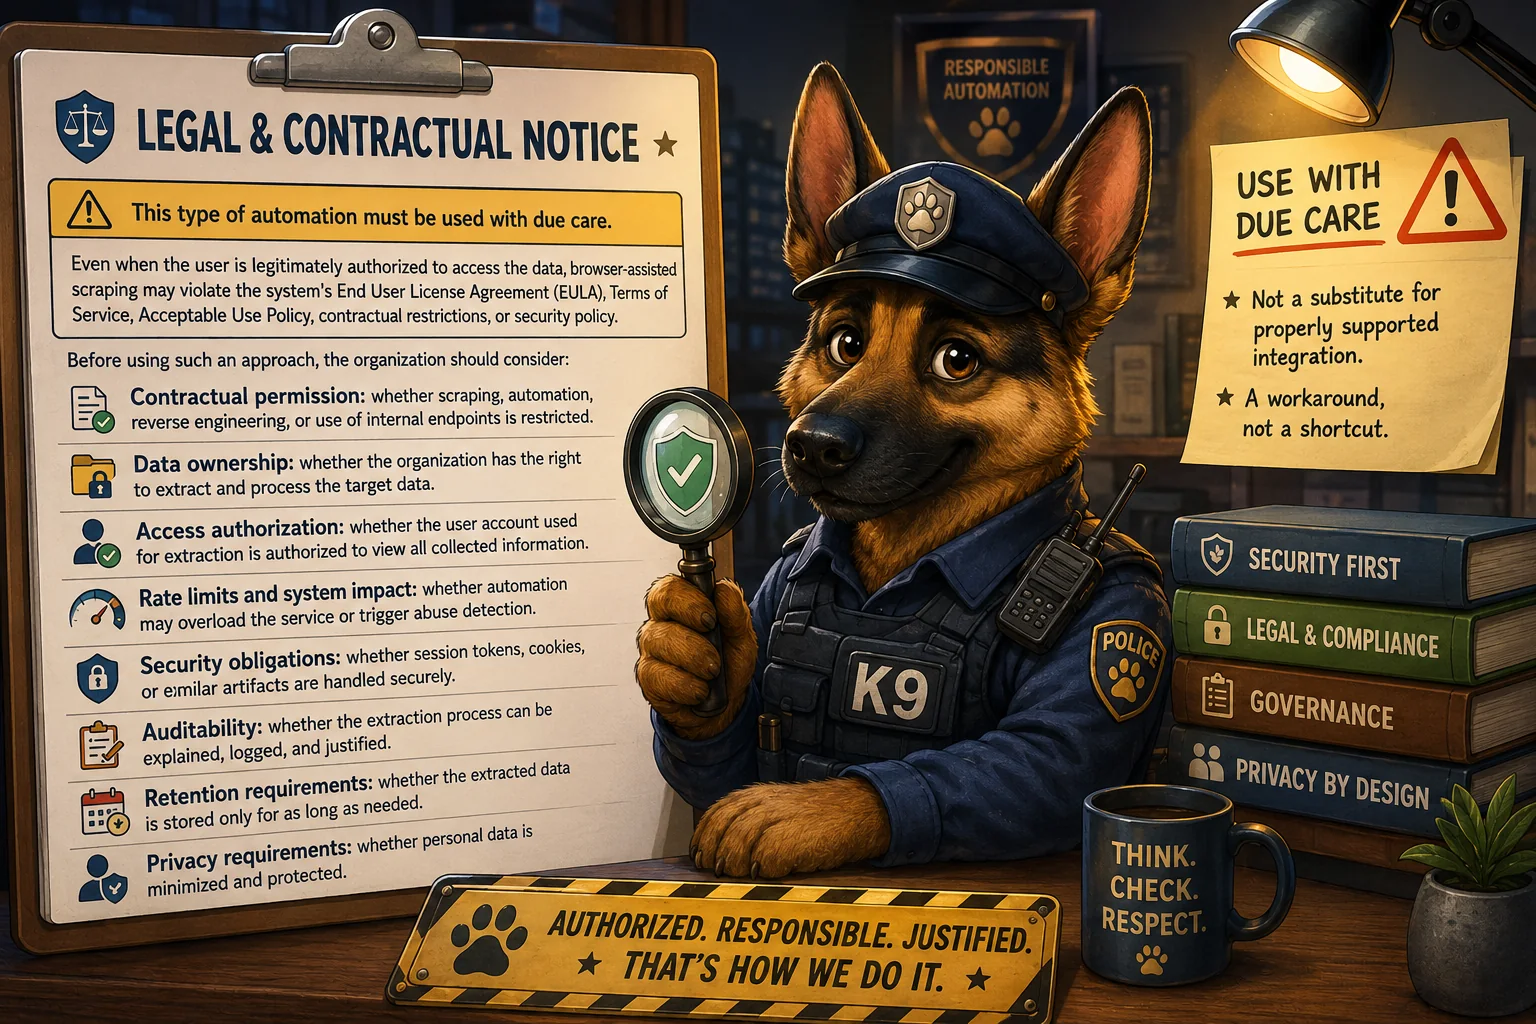
Avant de recourir à une telle approche, l'organisation devrait examiner :
- L'autorisation contractuelle : si le scraping, l'automatisation, la rétro-ingénierie ou l'usage de points d'accès internes sont restreints.
- La propriété des données : si l'organisation a le droit d'extraire et de traiter les données visées.
- L'habilitation d'accès : si le compte utilisateur employé pour l'extraction est autorisé à consulter toutes les informations collectées.
- Les limites de débit et l'impact sur le système : si l'automatisation risque de surcharger le service ou de déclencher la détection d'abus.
- Les obligations de sécurité : si les jetons de session, cookies ou artefacts similaires sont gérés de façon sécurisée.
- L'auditabilité : si le processus d'extraction peut être expliqué, journalisé et justifié.
- Les exigences de conservation : si les données extraites ne sont conservées que le temps nécessaire.
- Les exigences de vie privée : si les données personnelles sont minimisées et protégées.
Ce modèle ne doit pas être employé à la légère. C'est un contournement, pas un substitut à une intégration correctement prise en charge.
7. Considérations de sécurité
Les artefacts de session, y compris les cookies et les jetons, doivent être traités comme des identifiants sensibles.
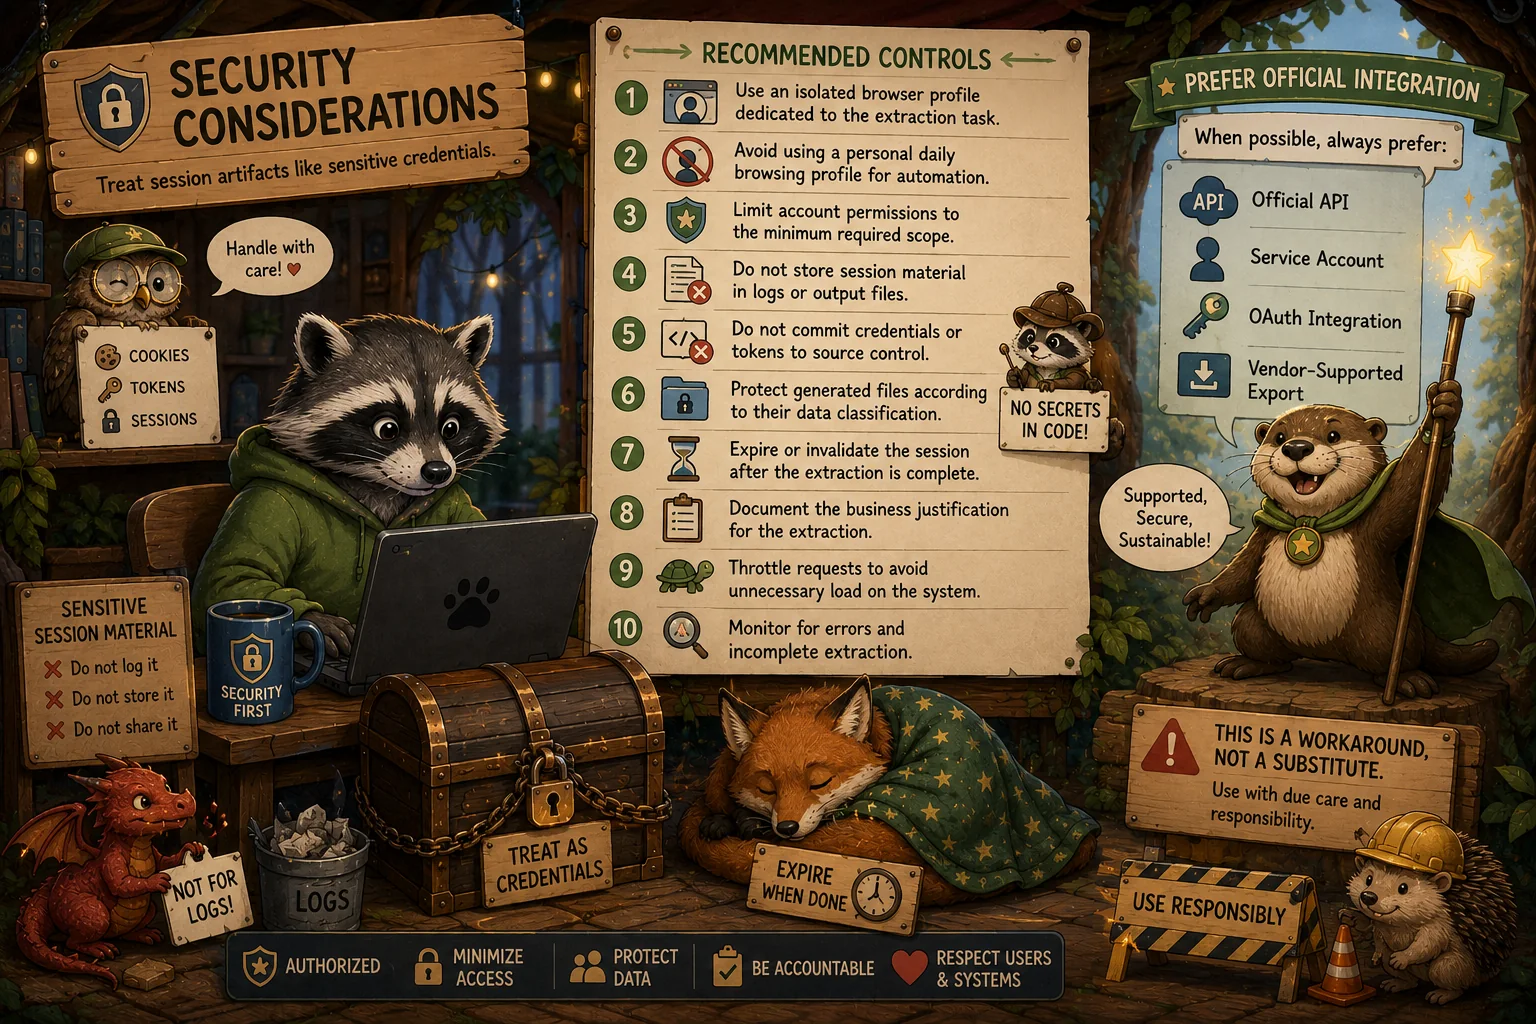
Si l'automatisation s'appuie sur une session authentifiée, les contrôles suivants sont fortement recommandés :
- Utiliser un profil de navigateur isolé dédié à la tâche d'extraction.
- Éviter d'utiliser un profil de navigation quotidien personnel pour l'automatisation.
- Limiter les permissions du compte au périmètre minimal requis.
- Ne pas conserver d'éléments de session dans les journaux ni dans les fichiers de sortie.
- Ne pas valider d'identifiants ni de jetons dans le contrôle de source.
- Protéger les fichiers générés selon leur classification des données.
- Faire expirer ou invalider la session une fois l'extraction terminée.
- Documenter la justification métier de l'extraction.
- Limiter le rythme des requêtes pour éviter une charge inutile sur le système.
- Surveiller les erreurs et les extractions incomplètes.
Dans la mesure du possible, une API officielle, un compte de service, une intégration OAuth ou un mécanisme d'export pris en charge par l'éditeur devrait toujours être préféré.
8. Exemple de cas d'usage théorique
Supposons qu'une entreprise doive extraire des enregistrements d'une plateforme SaaS interne pour une revue de conformité.
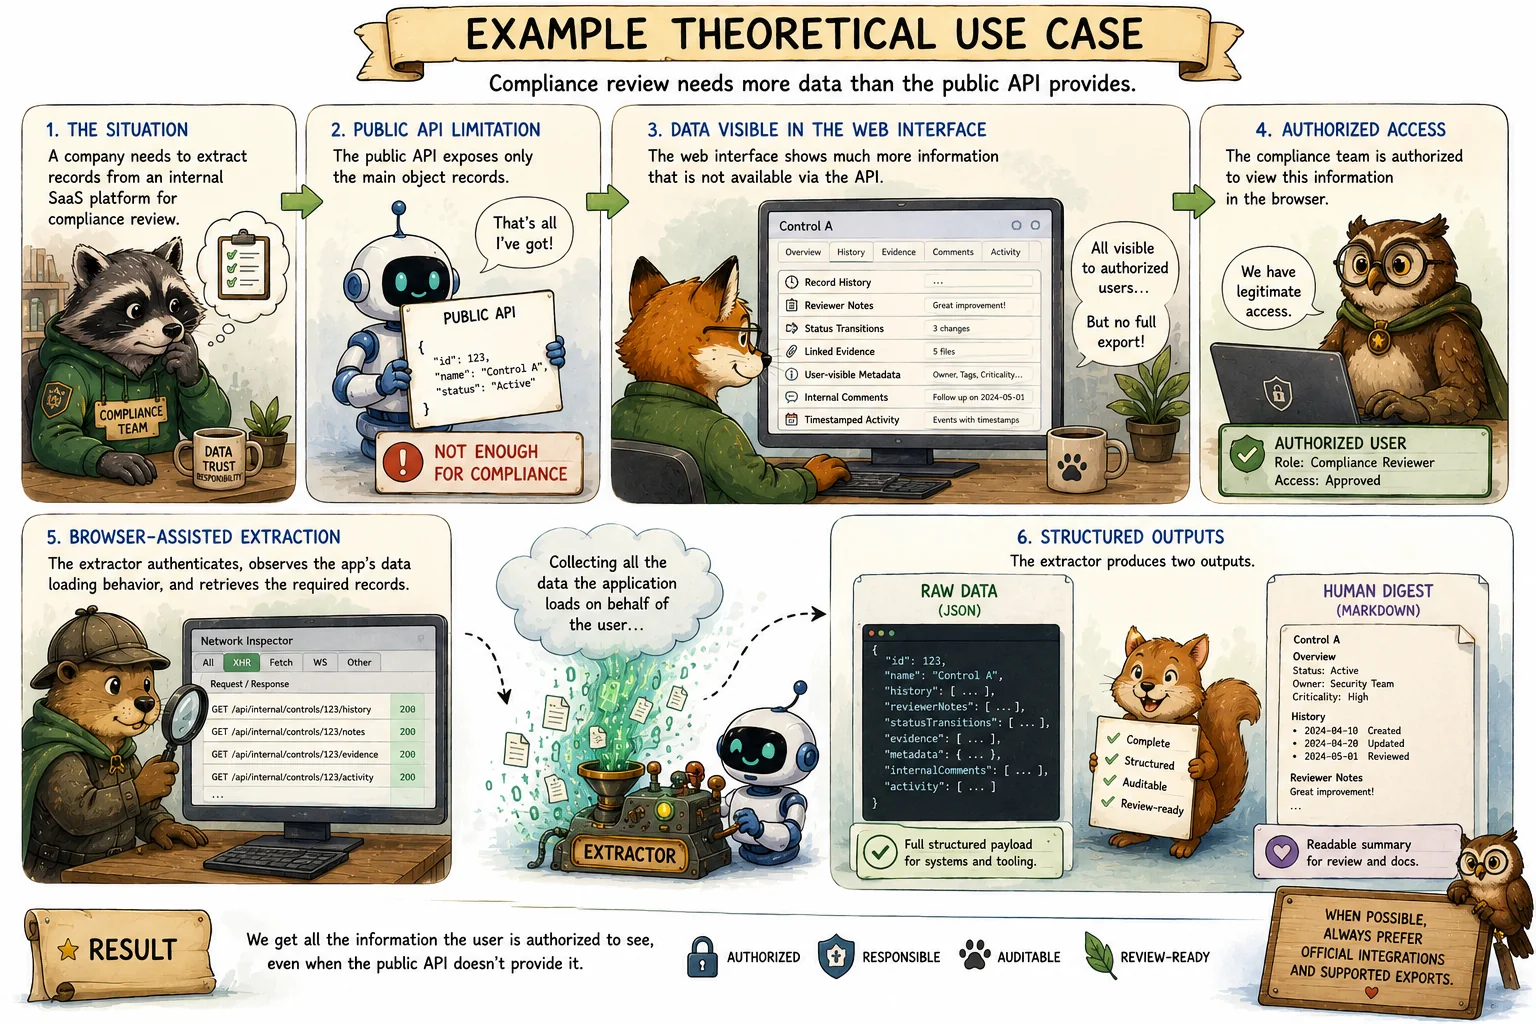
L'API publique n'expose que les enregistrements des objets principaux, mais l'interface web affiche des informations supplémentaires, telles que :
- L'historique des enregistrements
- Les notes des relecteurs
- Les transitions de statut
- Les preuves liées
- Les métadonnées visibles par l'utilisateur
- Les commentaires internes
- L'activité horodatée
L'équipe de conformité est autorisée à consulter ces informations dans le navigateur, mais il n'existe pas de fonction d'export complète.
Un extracteur assisté par le navigateur peut s'authentifier en tant qu'utilisateur autorisé, observer la manière dont l'application charge elle-même ses données, récupérer les enregistrements requis et produire deux sorties. Le fichier JSON conserve l'intégralité de la charge utile structurée. Le fichier Markdown en fournit une version lisible, adaptée à la relecture et à la documentation.
9. Utilisation responsable
Le scraping assisté par le navigateur peut être légitime lorsqu'il sert à récupérer des données auxquelles l'utilisateur est déjà autorisé à accéder et qu'aucun mécanisme d'export officiel adéquat n'existe.
Il doit toutefois être traité comme une solution d'ingénierie d'exception. Il devrait être examiné sous les angles juridique, sécurité, vie privée et opérationnel avant utilisation.
Le meilleur résultat reste une API prise en charge par l'éditeur. Mais lorsque l'API est absente ou insuffisante, une extraction assistée par le navigateur, soigneusement maîtrisée, peut offrir un pont pratique entre le travail manuel et une véritable intégration.
10. Conclusion
Les systèmes dépourvus d'API suffisantes créent de la friction pour la conformité, l'audit, le reporting, la migration et l'automatisation opérationnelle. Dans ces cas, l'extraction de données assistée par le navigateur peut être un contournement pragmatique.
Le principe clé est simple : n'automatiser que ce que l'utilisateur est légitimement autorisé à consulter, protéger les éléments de session comme des identifiants, éviter toute collecte de données inutile, respecter les restrictions contractuelles et documenter la justification.
Utilisée de façon responsable, cette approche peut transformer un processus par ailleurs manuel et peu fiable en un flux de travail reproductible, structuré et auditable.
Cette page est une copie intégrale de l'article tel que publié sur Medium. Lire sur Medium. Illustrations générées par IA.