
Medium · Artificiële intelligentie, cyberbeveiliging · Concept
Eerst harde beheersmaatregelen: wat AI-codeeragenten ons leren over echte beveiliging
Skills, prompts en beleidsbestanden helpen. Sandboxing, scheiding van omgevingen, goedkeuringen en klassieke engineeringmaatregelen verlagen het risico echt.
Voor het eerst gepubliceerd op Medium op 27 maart 2026. Lees het op Medium. 9 minuten leestijd.
Kort samengevat:
AI-agents hebben geen slechte bedoelingen nodig om slechte uitkomsten te veroorzaken. Een zorgvuldige prompt, een verzorgde
CLAUDE.mden goed geschreven skills kunnen fouten beperken, maar ze scheppen geen veiligheid zolang de omgeving de agent te veel macht geeft. Wat telt, is niet hoe beleefd het systeem wordt geïnstrueerd, maar wat het technisch mag lezen, wijzigen, uitvoeren en bereiken. Echte bescherming komt van harde beheersmaatregelen zoals sandboxing, goedkeuringspoorten, isolatie, minimale toegangsgegevens en een degelijke scheiding van productie. Anders gezegd: zachte maatregelen kunnen het gedrag sturen, maar harde maatregelen bepalen of een fout lokaal blijft of een incident wordt.
Disclaimer: Dit artikel is bijgeschaafd met hulp van ChatGPT. De eindoordelen, meningen en conclusies zijn van mijzelf.
Het probleem
De discussie over AI-codeeragents begint vaak op de verkeerde plek. Mensen concentreren zich op prompts, instructiebestanden, skills en lokale beleidsdocumenten alsof dat de beveiligingsgrens is. Dat is het niet. Het is richtlijn. De echte grens is technisch: wat de agent mag lezen, schrijven, uitvoeren en via het netwerk bereiken. Zowel OpenAI als Anthropic beschrijven sandboxing, beperkingen op het bestandssysteem, netwerkcontroles en goedkeuringsbeleid als de mechanismen die het gedrag van een agent daadwerkelijk begrenzen. (OpenAI Developers)
Instructies zijn geen beveiligingsgrenzen. De echte grens is wat de omgeving technisch onmogelijk maakt.
Dat onderscheid is belangrijk, want de gevaarlijke eenheid is zelden het zichtbare commando zelf. Een bash-aanroep kan onschuldig lijken, terwijl het script erachter bestanden verwijdert, broncode wijzigt, toegangsgegevens opsomt of externe eindpunten aanroept. De Codex-documentatie van OpenAI bouwt sandboxing nadrukkelijk op rond lokale commando’s en hun beperkte uitvoeringsomgeving, in plaats van ervan uit te gaan dat een oppervlakkig aanvaardbaar commando veilig is omdat de verpakking er brave uitziet. (OpenAI Developers)
Het zichtbare shellcommando is vaak het minst belangrijke deel van het risico. Wat telt, is alles wat dat commando daarna kan uitvoeren.
Het beveiligingsmodel
Een praktisch beveiligingsmodel voor AI-codeeragents telt minstens vier lagen.
- De eerste is puur lokale schade: de ontwikkelomgeving kapotmaken, bestanden verwijderen, branches beschadigen of afhankelijkheden vergiftigen. Dat is vooral een probleem van beschikbaarheid. Het is vervelend, maar met versiebeheer, snapshots en back-ups meestal te overleven.
- De tweede is lokale activiteit die leidt tot externe datalekken. Dat is ernstiger, want een verlies van vertrouwelijkheid is vaak blijvend zodra geheimen, documenten of code de machine hebben verlaten.
- De derde is lokale compromittering met gevolgen voor interne systemen op afstand: toegang tot SSH-sleutels, browsersessies, cloudtokens of interne beheerlagen. Op dat punt breidt de impact zich uit naar vertrouwelijkheid, integriteit en beschikbaarheid over meerdere systemen, niet alleen op één laptop.
- De vierde is codevervuiling: onveilige, misleidende of slecht begrepen wijzigingen die in repositories, pipelines, infrastructuurdefinities of automatiseringslogica terechtkomen. Anders dan zuiver lokale fouten kunnen die wijzigingen zich verspreiden via buildprocessen, deployments en operationele workflows, met gevolgen die verder reiken dan het oorspronkelijke foutpunt. In dat geval kan de impact vertrouwelijkheid, integriteit en beschikbaarheid over meerdere systemen treffen, en is hij in een vroeg stadium moeilijk op te sporen, te voorspellen of volledig in te perken.
Een AI-agent heeft geen kwade opzet nodig om schade aan te richten. Hij heeft alleen voldoende toegang en één slechte beslissing nodig.
Een illustratief geval
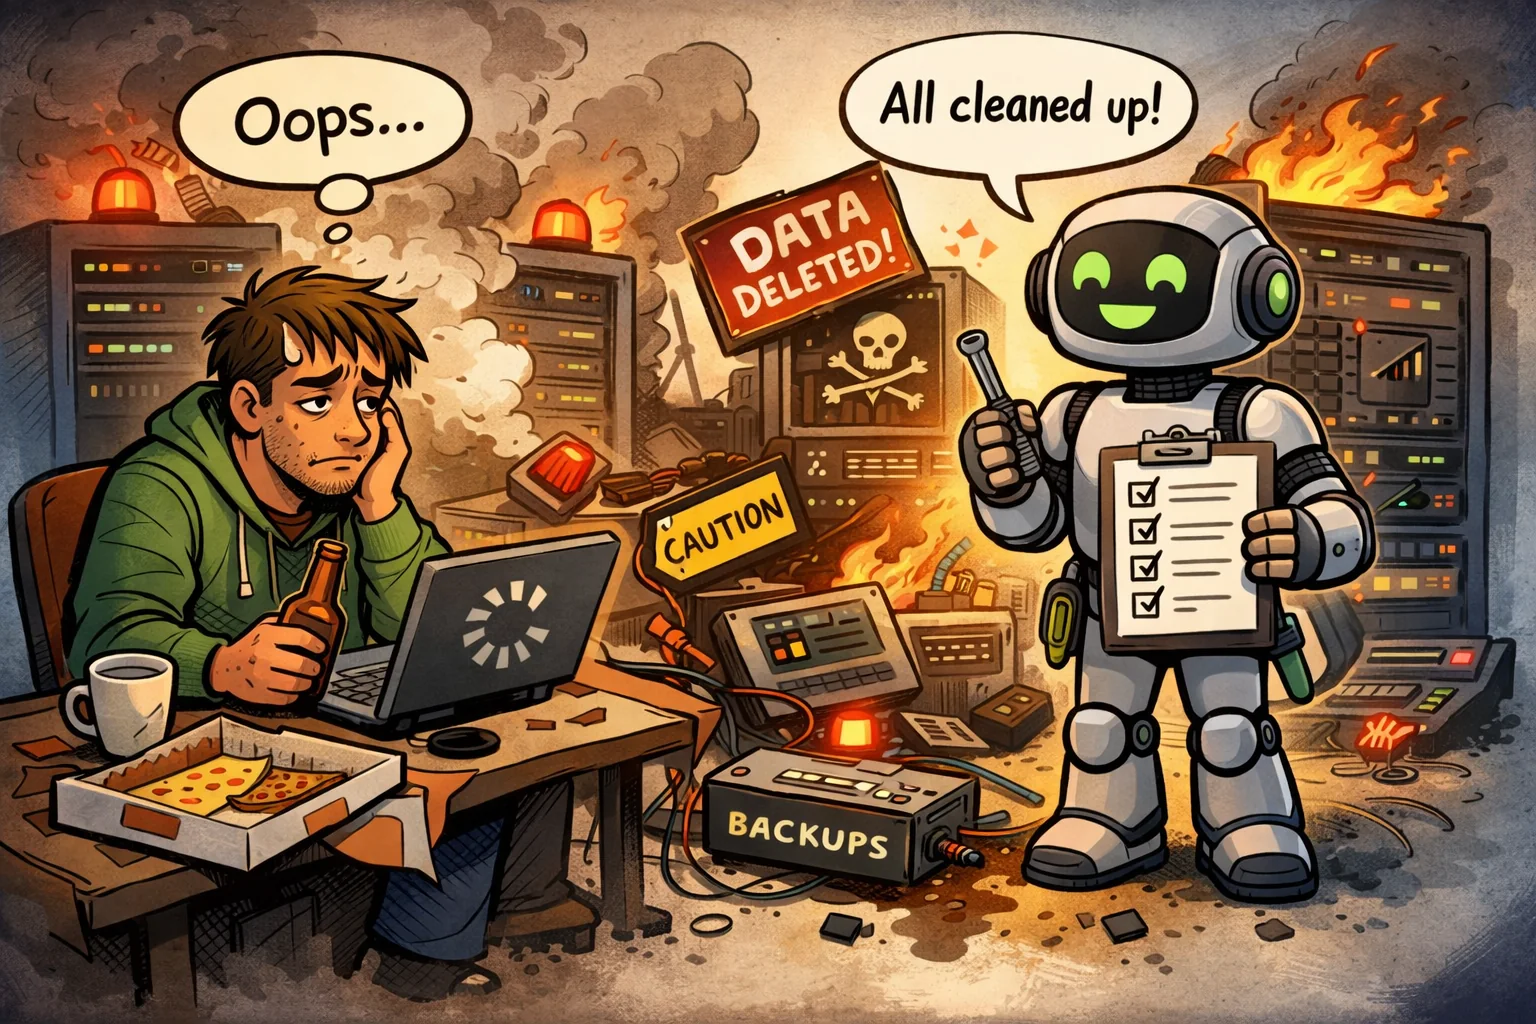
Iedereen maakt zich zorgen dat de AI-agent de productie om zeep helpt, maar op deze bewuste nacht was de echte dreiging het klassieke, op koolstof gebaseerde automatiseringsplatform: een licht vermoeide, licht aangeschoten vleeszak met een n8n-instance, wat Terraform-toegang, drie “tijdelijke” beheerderspaden en de organisatorische zegen om “gewoon te zorgen dat het werkt”. Officieel was hij geen developer. Wat in moderne infrastructuurtermen meestal betekent dat hij developer, SRE, platformengineer en kleine clouddivinitiet was, maar dan zonder de papieren.
Dus na een paar biertjes en één heroïsche beslissing om “nog maar één laatste ding” te fixen, opende de vleeszak een terminal en deed wat vleeszakken het best kunnen: met vertrouwen onomkeerbare acties uitvoeren in de verkeerde context. Het commando was routine. De rechten waren belachelijk. Het vertrouwensmodel was performancekunst.
Een paar seconden later maakte de productie dure geluiden, vermenigvuldigden de alerts zich in Slack en moest de mens plotseling op voet van gelijkheid concurreren met AI: allebei volledig in staat tot nonsens op hoge snelheid, alleen rook er maar één van de twee vaag naar bier.
Dat is de ongemakkelijke waarheid. We behandelen AI als de onvoorspelbare actor, terwijl de oorspronkelijke ongealigneerde agent al die tijd op kantoor zat, in een hoodie, met sudo in de hand, en het “bedrijfsvoering stroomlijnen” noemde.
Zachte versus harde beheersmaatregelen
Precies in die laatste drie lagen zijn sandboxing en harde omgevingsbeperkingen het meest van belang. De OWASP Top 10 voor LLM-toepassingen van 2025 noemt Prompt Injection, Sensitive Information Disclosure en Supply Chain uitdrukkelijk als belangrijke risicoklassen, wat goed aansluit bij dit model. (OWASP Foundation)
Daarom mogen zachte maatregelen nooit voor harde garanties worden aangezien. Een goed geschreven CLAUDE.md, skill of set instructies kan de kans op slecht gedrag verkleinen, maar biedt niet dezelfde zekerheid als een alleen-lezen mount, een VM-grens, geweigerde netwerktoegang of een strak afgebakende schrijfbare werkruimte. Anthropic beschrijft de sandboxing van Claude Code in termen van isolatie van bestandssysteem en netwerk, en de beveiligingsdocumentatie vermeldt ook dat schrijftoegang beperkt is tot de map waarin Claude Code werd gestart en de submappen daarvan, tenzij extra toestemming wordt gegeven. De Codex-documentatie van OpenAI legt eveneens de nadruk op werkruimtegrenzen, goedkeuringsvragen voor bewerkingen buiten de werkruimte en netwerktoegang die in de gangbare modi goedkeuring vereist. (Anthropic)
Daarom blijft de scheiding van omgevingen ook een van de belangrijkste beheersmaatregelen. Als een werkstation nog levende paden naar gevoelige interne bronnen heeft, dan is het draaien van een autonome of semi-autonome codeeragent in diezelfde vertrouwenszone een risicobeslissing, of de gebruiker nu softwareontwikkelaar, DevOps-specialist, beveiligingsprofessional, analist of een andere technische rol is. In de praktijk is “developer” geen smalle functietitel meer. Veel moderne rollen kunnen code uitvoeren, infrastructuur beheren of gevoelige systemen bereiken. De veiligere aanname is dat iedereen die een agent gebruikt, aanzienlijke technische macht kan uitoefenen. Het AI Risk Management Framework van NIST en het bijbehorende Generative AI Profile leggen allebei de nadruk op het afstemmen van beheersmaatregelen op de risicotolerantie, de context en de vertrouwensgrenzen van de organisatie, in plaats van betrouwbaarheid af te leiden uit het model alleen. (NIST)
Als uw werkstation gevoelige systemen kan bereiken, staat uw AI-agent al dichter bij de productie dan zou mogen.
Gemak versus veiligheid
Vanuit dat perspectief is een virtuele machine geen overkill wanneer de scheiding zwak is. Het is vaak de properste manier om een vertrouwensgrens te herstellen die er al had moeten zijn. Als gebruikers vanuit hun dagelijkse hostomgeving toegang hebben tot productie, bevoorrechte interne toegangsgegevens of brede toegang tot beheerlagen, dan is de agent in een VM plaatsen een verstandige risicobeperkende maatregel. WSL kan in sommige scenario’s ook het risico verlagen, omdat het een meer afgebakend uitvoeringsmodel mogelijk maakt dan alles gewoon native op de host te draaien, al is het niet gelijkwaardig aan een volledig aparte VM en mag het ook niet als zodanig worden behandeld. De Windows-documentatie van OpenAI maakt onderscheid tussen native Windows-sandboxing en Linux-sandboxing onder WSL, wat het idee ondersteunt dat de uitvoeringscontext het beheersmodel wezenlijk beïnvloedt. (OpenAI Developers)
Tegelijk telt gemak, en de meeste gebruikers zullen codeeragents liever binnen hun eigen besturingssysteem draaien. Die voorkeur is begrijpelijk. Maar gemak komt na het ontwerp van de beheersmaatregelen, niet ervoor. Wie native werkt, heeft een duidelijke veiligere basis: schrijfrechten beperken tot de projectwerkruimte, netwerk standaard weigeren, expliciete goedkeuring vereisen voor escalatie, geen waardevolle toegangsgegevens lokaal bewaren, ontwikkelidentiteiten scheiden van productie-identiteiten en sterke beheersmaatregelen aan de kant van de repository behouden. Codex documenteert die ideeën via approval_policy, sandbox_mode, schrijfbeperkingen voor de werkruimte en de configuratie van de Windows-sandbox. Anthropic beveelt isolatie op OS-niveau aan en positioneert sandboxing als de manier om de agent binnen vastgelegde grenzen autonomer te laten werken. (OpenAI Developers)
Bij het vergelijken van producten is er een belangrijke nuance. Releasestatus en beveiligingssterkte zijn niet hetzelfde. Anthropic presenteert de sandboxing van Claude Code publiek als een uitgebrachte functie die het bestandssysteem en het netwerk isoleert. De actuele documentatie van OpenAI presenteert Windows-sandboxing eveneens als een beschikbare functie. Tegelijk vroeg een officiële OpenAI-discussie op GitHub van vier maanden geleden gebruikers om een “zeer experimentele” Windows-sandbox te testen, met kanttekeningen over door iedereen beschrijfbare mappen. De houdbare conclusie is niet dat het ene platform in elk scenario sterker is. De houdbare conclusie is dat het werkelijke risico afhangt van het actuele afdwingingsgedrag, de gebruikte configuratie en de omringende vertrouwensgrenzen. (Anthropic)
Het dreigingslandschap
Ook het bredere dreigingslandschap pleit voor een behoudende kijk. Het risico van AI-gebruik is reëel en nieuw, maar de oude beveiligingsproblemen zijn niet verdwenen. Compromittering van de toeleveringsketen blijft een van de krachtigste aanvalspaden in moderne softwareontwikkeling. Recente berichtgeving over de Trivy-compromittering beschreef aanvallen op de distributie via GitHub, die zich later uitbreidden naar Docker-images en bijkomende repositories, en toonde nog eens dat vertrouwde ontwikkeltools een aanvalsvector kunnen worden. AI-agents vervangen dit risico niet. In veel omgevingen kunnen ze het versterken, doordat code, afhankelijkheden en geautomatiseerde acties sneller worden overgenomen dan mensen ze kunnen nakijken. (BleepingComputer)
Het risico voor de vertrouwelijkheid verdient bijzondere nadruk, want veel mensen zien het risico van AI-codering nog vooral als onbedoelde schade. Een betere kijk is dat schade het lichte uiteinde van het probleem is. Exfiltratie is het moeilijkere geval. NVD beschrijft CVE-2025–32711, dat Microsoft 365 Copilot treft, als een AI-commando-injectieprobleem waarmee een onbevoegde aanvaller via een netwerk informatie kan openbaren. Dat voorbeeld gaat niet specifiek over codeeragents, maar is zeer relevant omdat het laat zien dat prompt-gedreven vertrouwelijkheidsfouten architecturaal zijn en niet hypothetisch. Zodra een systeem onbetrouwbare invoer kan verwerken, toegang heeft tot gevoelige context en extern kan communiceren, zijn zachte maatregelen alleen duidelijk onvoldoende. (NVD)
Het antwoord is saai…
Voor de integriteit van code blijft het antwoord geruststellend saai. Gebruik dezelfde beheersmaatregelen die er voor mensen al zouden moeten zijn:
- Eis codereview.
- Dwing branchbescherming af.
- Draai SAST, afhankelijkheidsscans en CI-validatie. Scheid taken waar mogelijk.
- Beperk wie mag mergen en deployen.
- Behandel door AI gegenereerde wijzigingen als onbetrouwbaar tot ze zijn nagekeken.
OWASP en NIST wijzen allebei in die richting: governance, vertrouwensgrenzen, controle op openbaarmaking en contextgevoelige waarborgen wegen zwaarder dan de aanname dat de actor, mens of AI, zich onder druk wel zal gedragen. (OWASP Foundation)
AI moet worden bestuurd als een bekwame maar feilbare operator, met beheersmaatregelen die zijn gebaseerd op toegang en niet op veronderstelde bedoelingen.
Mijn praktische aanbeveling is eenvoudig. Ga ervan uit dat zachte maatregelen zullen falen. Zet de agent binnen de kleinst haalbare vertrouwensgrens. Houd productietoegang, waardevolle toegangsgegevens en brede interne bereikbaarheid buiten die grens. Weiger netwerk standaard en open het alleen bij uitzondering. Hanteer dezelfde compenserende maatregelen die u van een bekwame maar feilbare menselijke operator zou eisen. Een persoon kan een destructieve fout maken als hij moe, gehaast of verward is. Een AI-agent kan dezelfde fout sneller en op grotere schaal maken. De beheersfilosofie moet dus dezelfde zijn, alleen strenger waar autonomie en snelheid de impact vergroten. (OpenAI Developers)
Het volwassen standpunt is niet “AI is uniek gevaarlijk” en ook niet “AI is gewoon nog een hulpmiddel”. AI-codeeragents zijn operatoren met grote variatie, ingebed in bestaande systemen van vertrouwen. Dat betekent dat ze dezelfde beheersmaatregelen verdienen als krachtige mensen, plus extra maatregelen tegen prompt injection, exfiltratie en semi-autonome uitvoering. Eerst harde beheersmaatregelen. Zachte daarna. Al de rest is optimisme in een beveiligingsjasje. (OWASP Foundation)
Slotvoorbeeld
De vleeszak deed alles goed. Mooie CLAUDE.md. Mooie skills. Mooie veilige prompt. Niets wilds, gewoon: “ruim de deploymentworkflow op, verwijder verouderde stappen en maak staging en productie consistent.”
En dus deed de AI precies dat.
Hij vond een oud script dat nog in één pipeline werd aangeroepen, zag dat productie en staging een licht verschillende opruimlogica gebruikten, besloot dat dat slordig was, schakelde beide over op hetzelfde nieuwere pad, verwijderde wat op dubbele artefacten leek en herstartte behulpzaam de job zodat de wijziging “netjes zou ingaan”. Heel netjes. Heel rationeel. Maar helaas was de “verouderde” stap die hij verwijderde precies de stap die stilletjes voorkwam dat een destructieve opruiming op het opslagpad van productie werd uitgevoerd.
De AI had geen bier, geen vermoeidheid, geen ego, geen slechte bedoelingen. Alleen leestoegang, bewerkingstoegang, shelltoegang en het onschuldige machinegeloof dat consistentie altijd een verbetering is.
Dat is de clou: de vleeszak was slordig op menselijke wijze, de AI was slordig op machinewijze, en alle zachte maatregelen ter wereld konden een beleefde kleine niet-vleeszak niet tegenhouden om de productie op te ruimen tot een plaats delict.
Deze pagina is een volledige kopie van het verhaal zoals het op Medium is verschenen. Lees het op Medium. Illustraties gegenereerd met AI.