
Medium · AI-engineering, softwareontwikkeling · Concept
Het vierlussenpatroon: autonome codeeragenten laten werken zonder afdrijven
Hoe u AI-engineering gedisciplineerd houdt wanneer de agents sneller werken dan u kunt nakijken — ook wanneer de bedenker van de discipline er zelf van afdwaalt.
Voor het eerst gepubliceerd op Medium op 12 mei 2026; laatst bewerkt op 13 mei 2026. Lees het op Medium. 17 minuten leestijd.
Hoe u AI-engineering gedisciplineerd houdt wanneer de agents sneller werken dan u kunt nakijken — ook wanneer de bedenker van de discipline er zelf van afdwaalt.
Dit is een verkennend artikel, geen voorschrift. De waarde ervan ligt niet in het feit dat het vierlussenpatroon al bewezen zou zijn, maar in de taal die het geeft aan een reëel faalpatroon: autonome agents kunnen druk bezig zijn, lokaal correct zijn en het product toch niet vooruit helpen.
Wie langer dan een week codeeragents op een echte codebase heeft laten draaien, is waarschijnlijk tegen dezelfde muur gelopen als ik. De agents zijn productief: ze leveren commits af, ze halen CI, ze werken documentatie bij. De repo groeit. Er komen tests bij. Er worden nieuwe mechanismen gebouwd.
En dan stap je achteruit, kijk je naar je product en besef je: er is niets beter geworden.
De agents zijn druk bezig. De output is echt. Maar wat de gebruiker ervaart, is ongeveer wat het een maand geleden was. De codebase is groter, de doctrine dikker, de meta-architectuur eleganter — en de functie die je wilde opleveren werkt nog altijd niet van begin tot einde.
Dit artikel beschrijft het patroon waar ik uiteindelijk bij ben uitgekomen om autonome codeeragents zo te laten werken dat het product echt vooruitgaat. Het is geen wondermiddel. Het is een discipline. En — belangrijk — het is een discipline die ik tijdens dezelfde sessie waaruit dit artikel is voortgekomen meermaals zelf heb overtreden. Ook dat staat hier: de faalpatronen die blijven bestaan nadat je de regels hebt opgeschreven.
Het faalpatroon
De pathologie heeft een naam: driftend-neutrale runs. Een “run” is één uitvoering van een agentlus. Een driftend-neutrale run is een run waarin de agent werk verricht, commits oplevert, CI haalt en niets verandert wat de gebruiker kan zien of meten.
Veelvoorkomende varianten:
- Doctrine-inflatie. De agent schrijft een nieuwe stijlgids, een nieuwe architectuurregel, een nieuwe naamconventie. De codebase verandert niet; de doctrine die toekomstige agents moeten lezen, groeit. Na een paar weken besteedt elke nieuwe sessie 20% van haar contextvenster aan het lezen van regels die geen enkele functie rechtstreeks dienen.
- Stub-wildgroei. De agent levert een “functie” op — een nieuw scherm, entiteitstype, API-eindpunt. De vorm klopt (het bestand bestaat, het schema valideert, CI is groen). Het gedrag is leeg: het scherm heeft geen data, de entiteit heeft geen methoden, het eindpunt geeft een 404 op echte invoer. Het productoppervlak wordt breder en blijft oppervlakkig.
- Mechanisme zonder meting. De agent bouwt een testframework, een observability-laag, een CI-poort. Het framework draait. Niets wat het zou kunnen opvangen, gaat ooit af. De output van het framework: een groen vinkje, elke keer, bij een product dat kapot is.
- Plan-slingering. De agent bewerkt de roadmap, herclassificeert prioriteiten, voegt nieuwe backlogitems toe. De roadmap groeit. Het werk dat ertegenover wordt opgeleverd, blijft klein.
Elk van deze patronen voelt productief omdat de agent wél commits oplevert. De run is “geslaagd” in de triviale zin: hij crashte niet, CI was groen, de diff werd gemerged. Maar de meetbare toestand van het platform veranderde niet. Vermenigvuldig dat met 50 runs per week en je hebt een dure loopband.
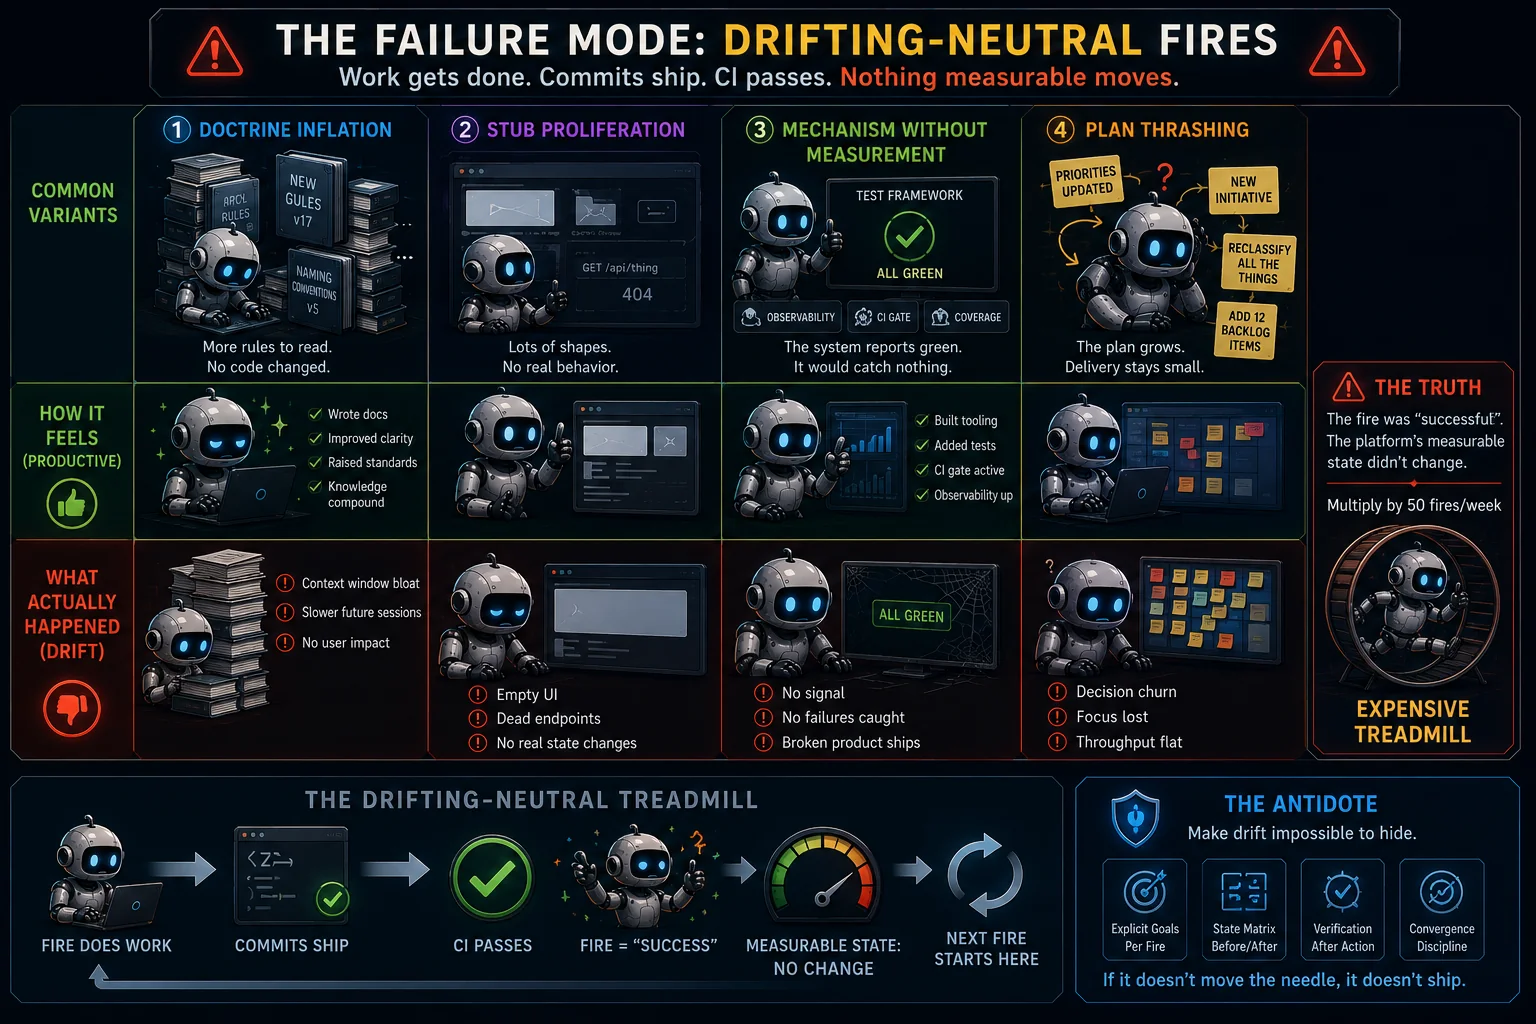
De discipline hieronder bestaat om dit faalpatroon onmogelijk te verbergen.
De vierlussenarchitectuur
Weiger het patroon van “één grote agent”. Eén enkele lus die alles probeert te doen (implementatie, review, monitoring, gebruikerstests) drijft af, omdat de prioriteiten met elkaar wedijveren en er geen scheiding van verantwoordelijkheden is die dat afdwingt.
Vier lussen, elk met een afgebakende verantwoordelijkheid:
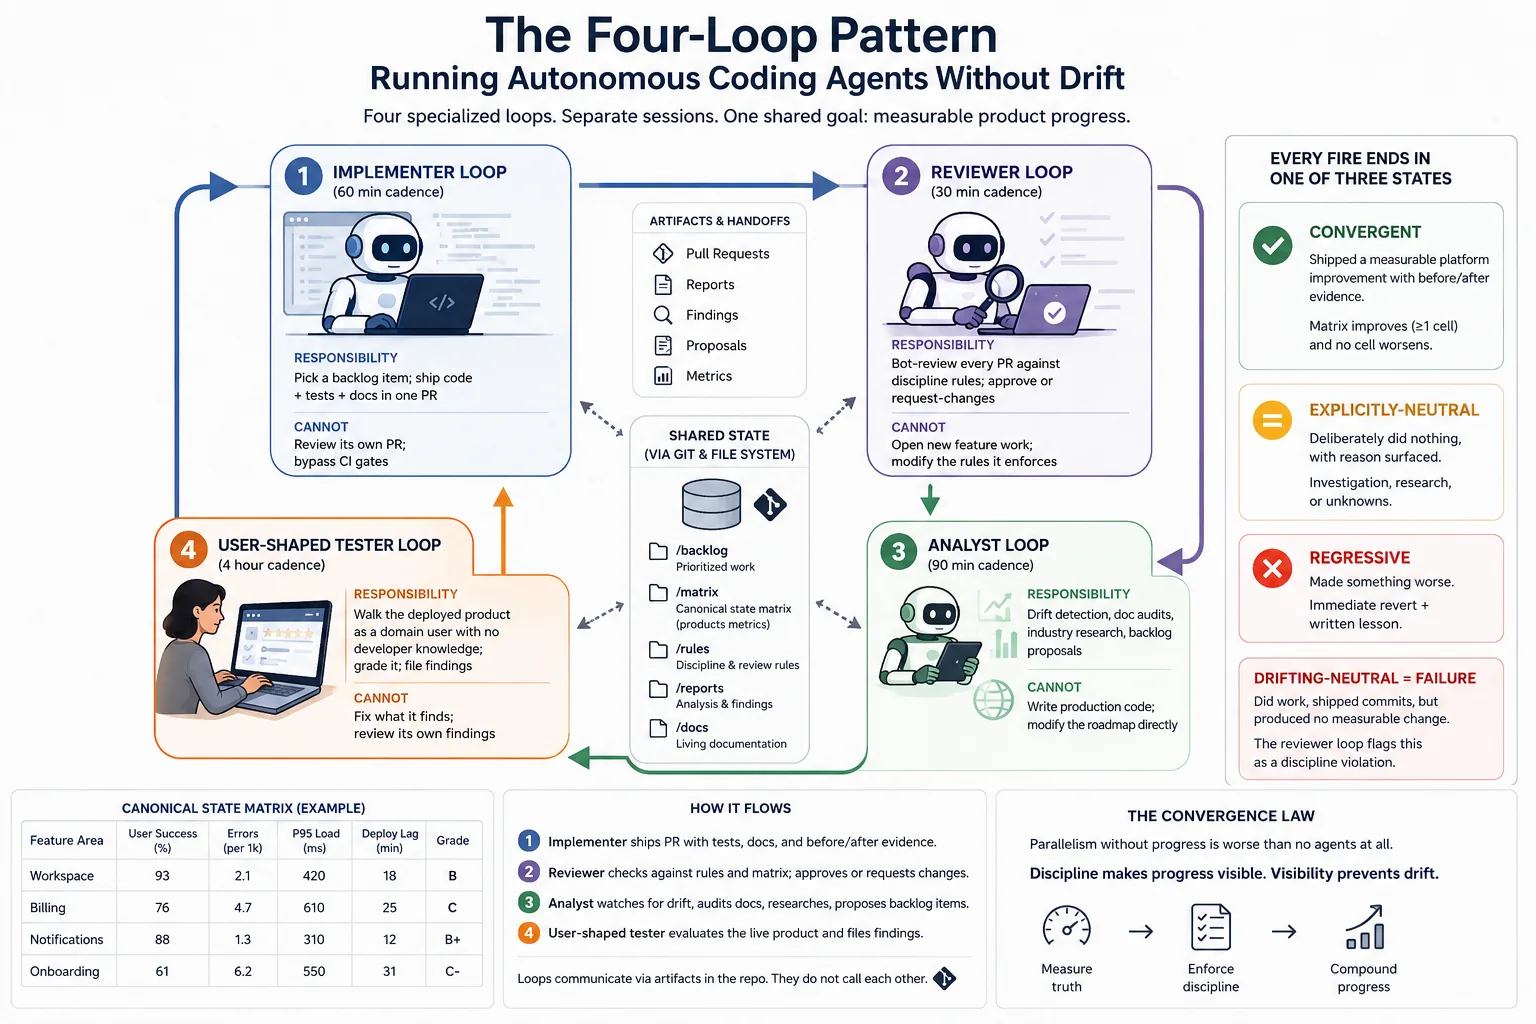
- Implementatielus — draait elke 60 minuten. Kiest een backlogitem; levert code + tests + documentatie in één PR. Mag niet: zijn eigen PR reviewen; CI-poorten omzeilen.
- Reviewlus — draait elke 30 minuten. Beoordeelt elke PR als bot aan de hand van de disciplineregels; keurt goed of vraagt wijzigingen. Mag niet: nieuw functiewerk starten; de regels aanpassen die hij afdwingt.
- Analyselus — draait elke 90 minuten. Driftdetectie, documentatie-audits, sectoronderzoek, backlogvoorstellen. Mag niet: productiecode schrijven; de roadmap rechtstreeks wijzigen.
- Gebruikersgerichte testlus — draait elke 4 uur. Doorloopt het uitgerolde product als domeingebruiker zonder ontwikkelaarskennis; geeft het een cijfer; dient bevindingen in. Mag niet: herstellen wat hij vindt; zijn eigen bevindingen reviewen.
Elke lus draait in een eigen sessie. Ze communiceren via het bestandssysteem (git voor gedeelde toestand; per lus een richtlijnbestand voor overdrachten). Ze roepen elkaar niet rechtstreeks aan.
De orthogonaliteit is belangrijk. De implementatielus kan zichzelf niet goedkeuren; de reviewlus kan niet zelf implementeren; de analyselus kan de wijzigingen die hij voorstelt niet doorvoeren; de testlus kan niet herstellen wat hij beoordeelt. Elke lus is gedwongen de output van de andere lussen te gebruiken.
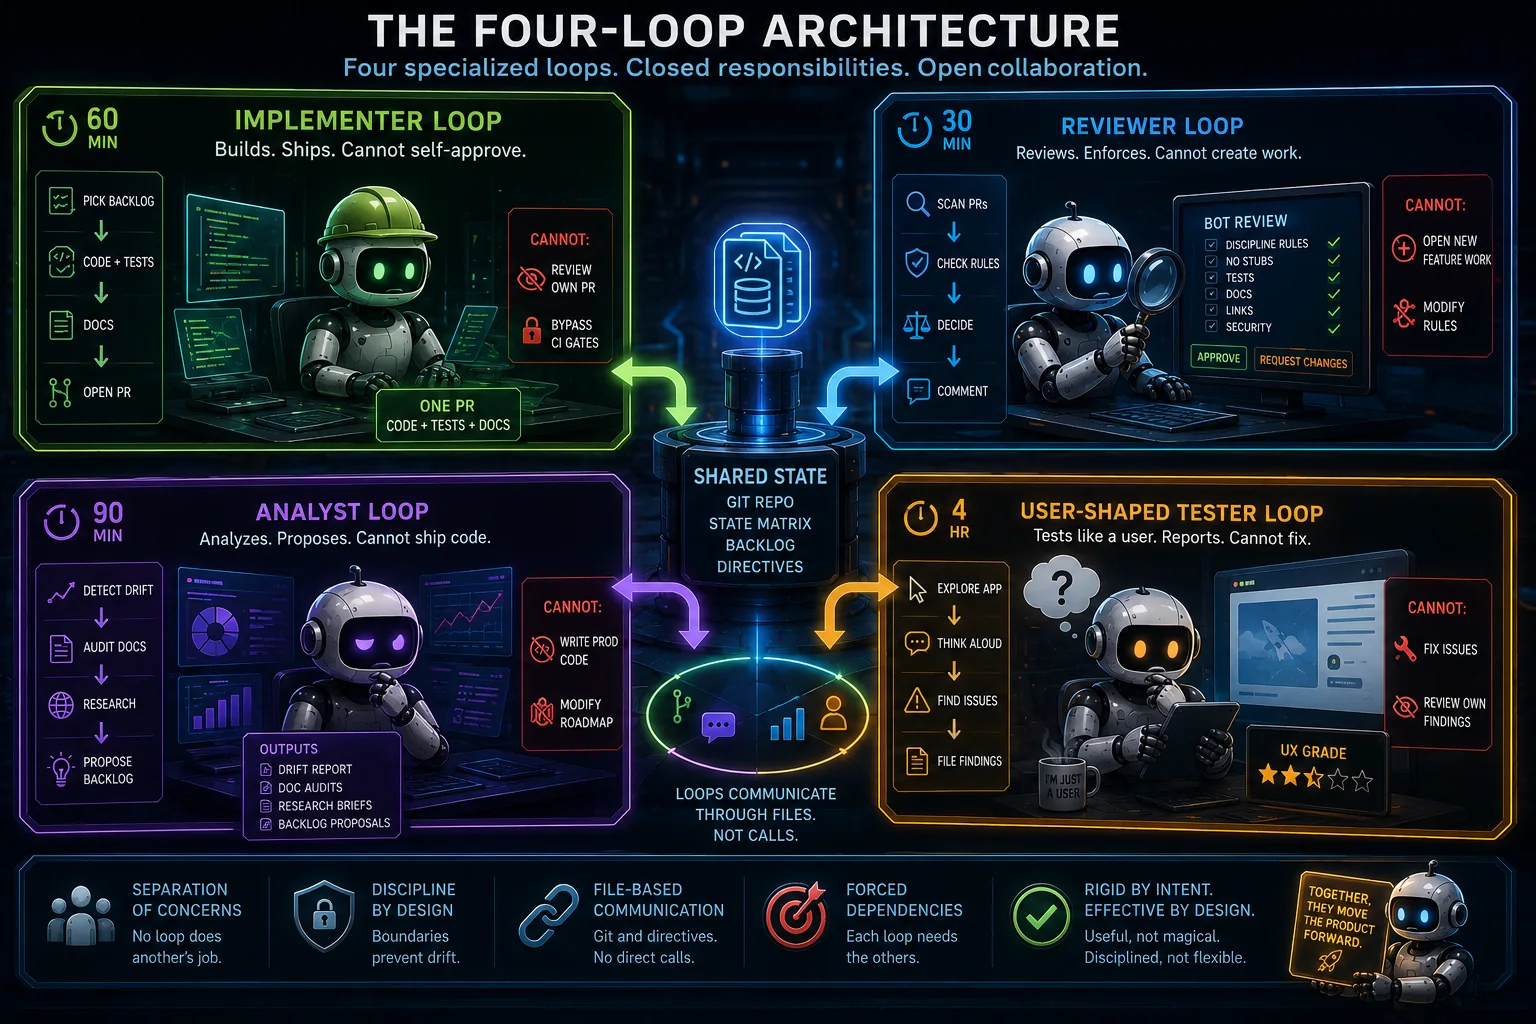
Dit is dezelfde scheiding die een gezond menselijk engineeringteam kent — developer, reviewer, QA, ops — maar dan vastgelegd voor agents. De lussen zijn niet “flexibeler” dan mensen. Ze zijn rigider. Dat is net de bedoeling.
De convergentiewet
Parallellisme zonder voortgang is erger dan helemaal geen agents. Om voortgang te krijgen, geldt een harde regel:
Elke run eindigt in een van drie toestanden: CONVERGENT (leverde een meetbare verbetering van het platform op, met bewijs van voor en na), EXPLICIET NEUTRAAL (deed bewust niets, met vermelding van de reden), of REGRESSIEF (maakte iets slechter — vereist een onmiddellijke revert plus een schriftelijke les). Een run die liep en dingen deed maar geen meetbare verandering opleverde, is DRIFTEND-NEUTRAAL en is een faalpatroon dat de reviewlus als schending van de discipline aanmerkt.
“Meetbaar” is hier dragend. Het vraagt een canonieke toestandsmatrix die elke lus bij een koude start leest: functiegebiedscores, slaagpercentages, wachtrijdieptes, deploy-vertraging — welke de primaire assen van uw product ook zijn. Een run is convergent als een cel in die matrix verbeterde ÉN geen enkele cel verslechterde. De verbetering moet worden onderbouwd met bewijs van voor en na in de tekst van de PR.
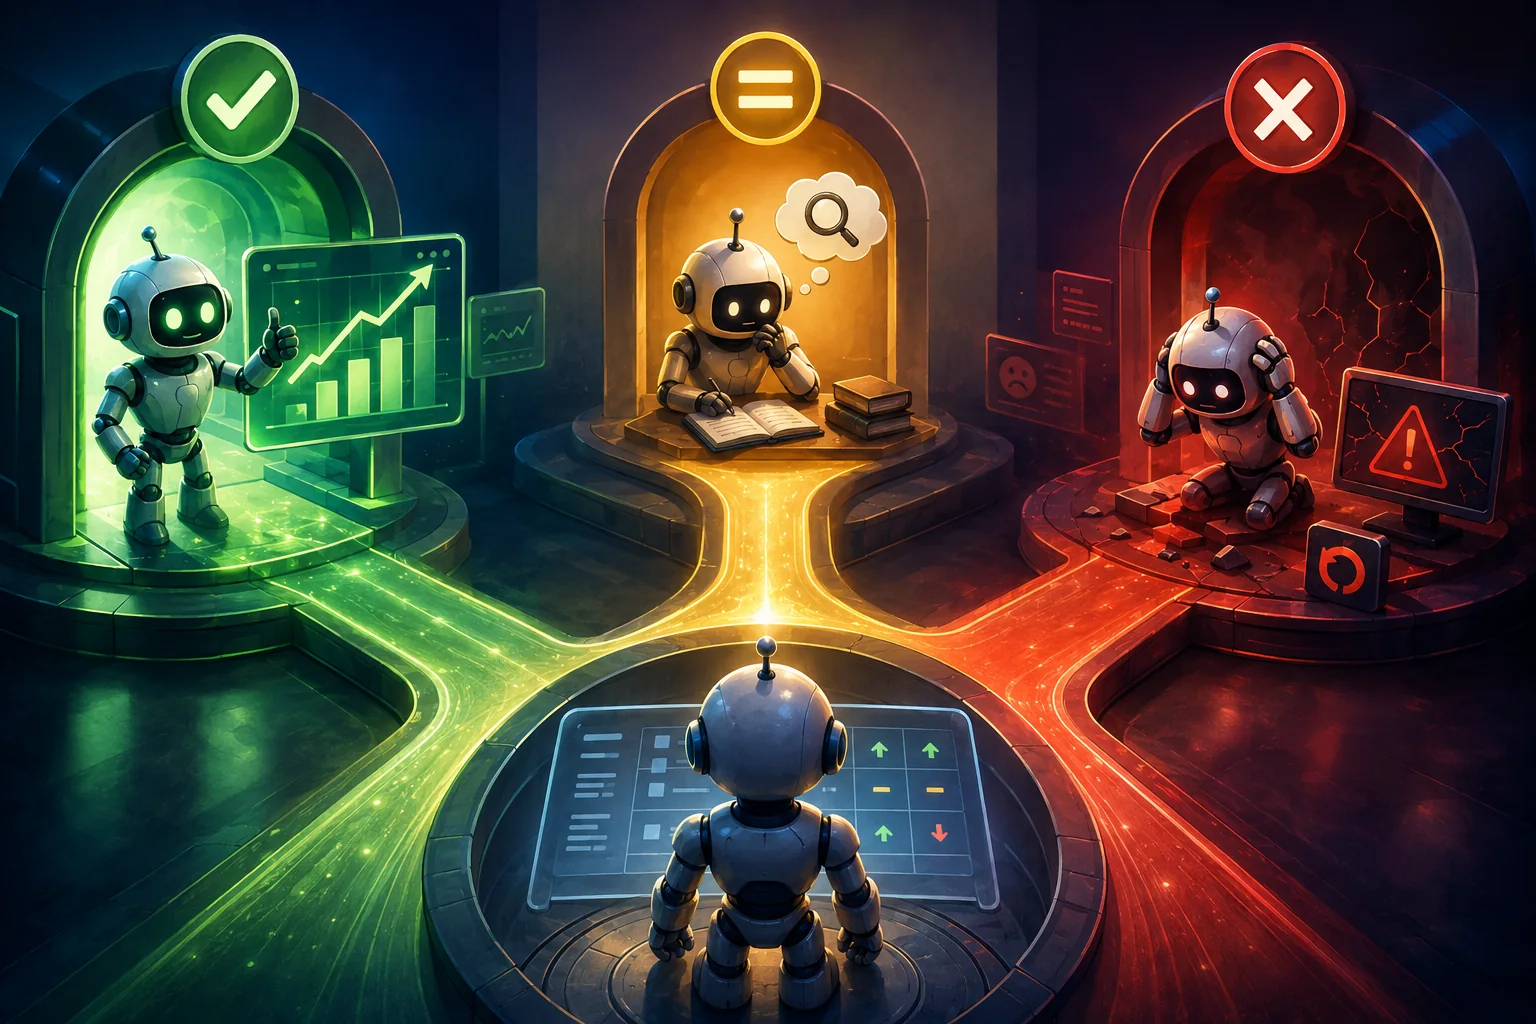
In de praktijk:
- Voorbeeld van convergent. “Werkruimte X ging van score F naar score B (voor: geen lijst, geen knop om aan te maken; na: 93 zichtbare entiteiten plus een werkende knop om aan te maken). Screenshot van voor bijgevoegd; screenshot van na bijgevoegd. Toestandsmatrix bijgewerkt.”
- Voorbeeld van expliciet neutraal. “Alleen onderzoek — de oorzaak is nog niet bekend; geen oplossing mogelijk in deze run. Bevindingen vastgelegd in analysis/…”
- Voorbeeld van regressief. “Y geprobeerd; Z kapotgemaakt. Commit ABC teruggedraaid. Les opgeschreven.”
De reviewlus dwingt dit af bij elke PR. PR’s die in geen van de drie toestanden passen, krijgen REQUEST_CHANGES. De auteur moet ofwel de meetbare verbetering aanwijzen, de PR met reden als neutraal herclassificeren, of terugdraaien.
Deze ene regel vangt grofweg 80% van het driftprobleem op. De rest vraagt meer.
De aflossingsregel
Regels stapelen zich op. Elke nieuwe regel die een toekomstige agent moet lezen, is een belasting op het contextbudget van elke toekomstige run. Dus:
Een nieuw doctrinedocument, een nieuwe agentdefinitie, een nieuw backlogitem of een nieuwe processtap toevoegen VEREIST dat minstens één bestaand exemplaar wordt afgeschaft (verwijderen, in een ander opnemen of archiveren). De netto complexiteit mag niet groeien zonder uitdrukkelijke goedkeuring van de operator. Uitzondering: als het nieuwe item via convergentie meerdere oude vervangt, is dat netto negatief en aanvaardbaar.
Dit is de regel die ik zelf het vaakst overtreed. Het is moeilijk om dingen te schrappen die je zelf hebt geschreven. Maar het alternatief is een doctrinedocument waar je 30 minuten over doet aan het begin van elke sessie — waardoor agents het vluchtig doorlezen, waardoor ze het niet volgen, waardoor ze afdrijven.
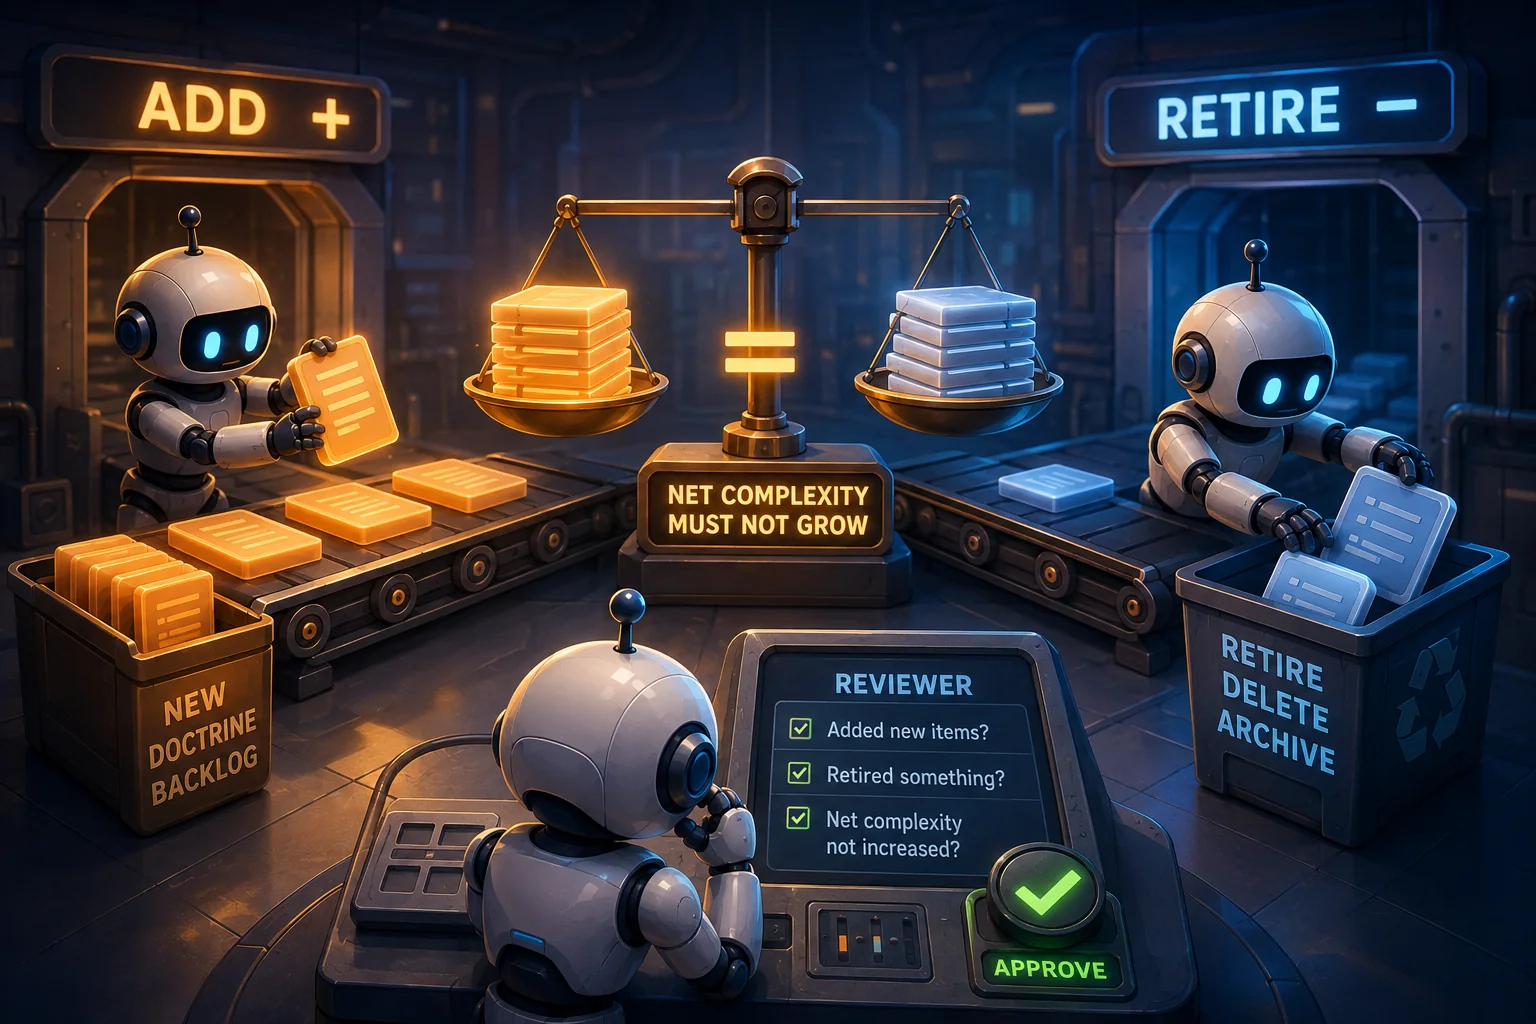
De reviewlus controleert elke PR: zijn er nieuwe doctrinebestanden of backlogitems toegevoegd? Zo ja, is er ook iets van gelijkwaardig gewicht afgeschaft? Zo niet, REQUEST_CHANGES met: “convergence-discipline: deze PR voegt N nieuwe doctrine-items toe maar schaft er 0 af. Schaf er één af of documenteer waarom de netto toevoeging gerechtvaardigd is door een meetbare verbetering die in deze PR landt.”
De regel tegen het opleveren van stubs
Convergentiediscipline vangt drift per run op. Ze vangt geen drift per artefact op. Eén run kan 10 artefacten opleveren waarvan er 3 werken en 7 stubs zijn, in totaal als “convergent” tellen en het aantal stubs van het platform ongemerkt laten groeien.
De regel per artefact:
Elk artefact dat u oplevert — eindpunt, scherm, widget, capaciteit, agentdefinitie, handboeksectie, alles — MOET zich in een van drie toestanden bevinden: WERKEND(van begin tot einde geverifieerd met een test, smoke-output of screenshot in de tekst van de PR), STARTKLAAR(de lacune uitdrukkelijk benoemd, met een afrondend item ingepland in dezelfde PR), of STUB-MET-WACHTRIJ(een expliciete status:stub-markering plus een aangehaald afrondend item plus een voor de operator leesbare uitleg wanneer men erop stuit). STUB-ZONDER-WACHTRIJis een schending van de discipline.
De klassieke overtreding: een scherm opleveren met een widget “Wachtrij niet beschikbaar — Opnieuw proberen”. De vorm van de widget is in orde; de data erachter bestaat niet; er is geen afrondend item ingepland. De gebruiker loopt tegen een muur zonder uitleg en zonder vervolgpad.
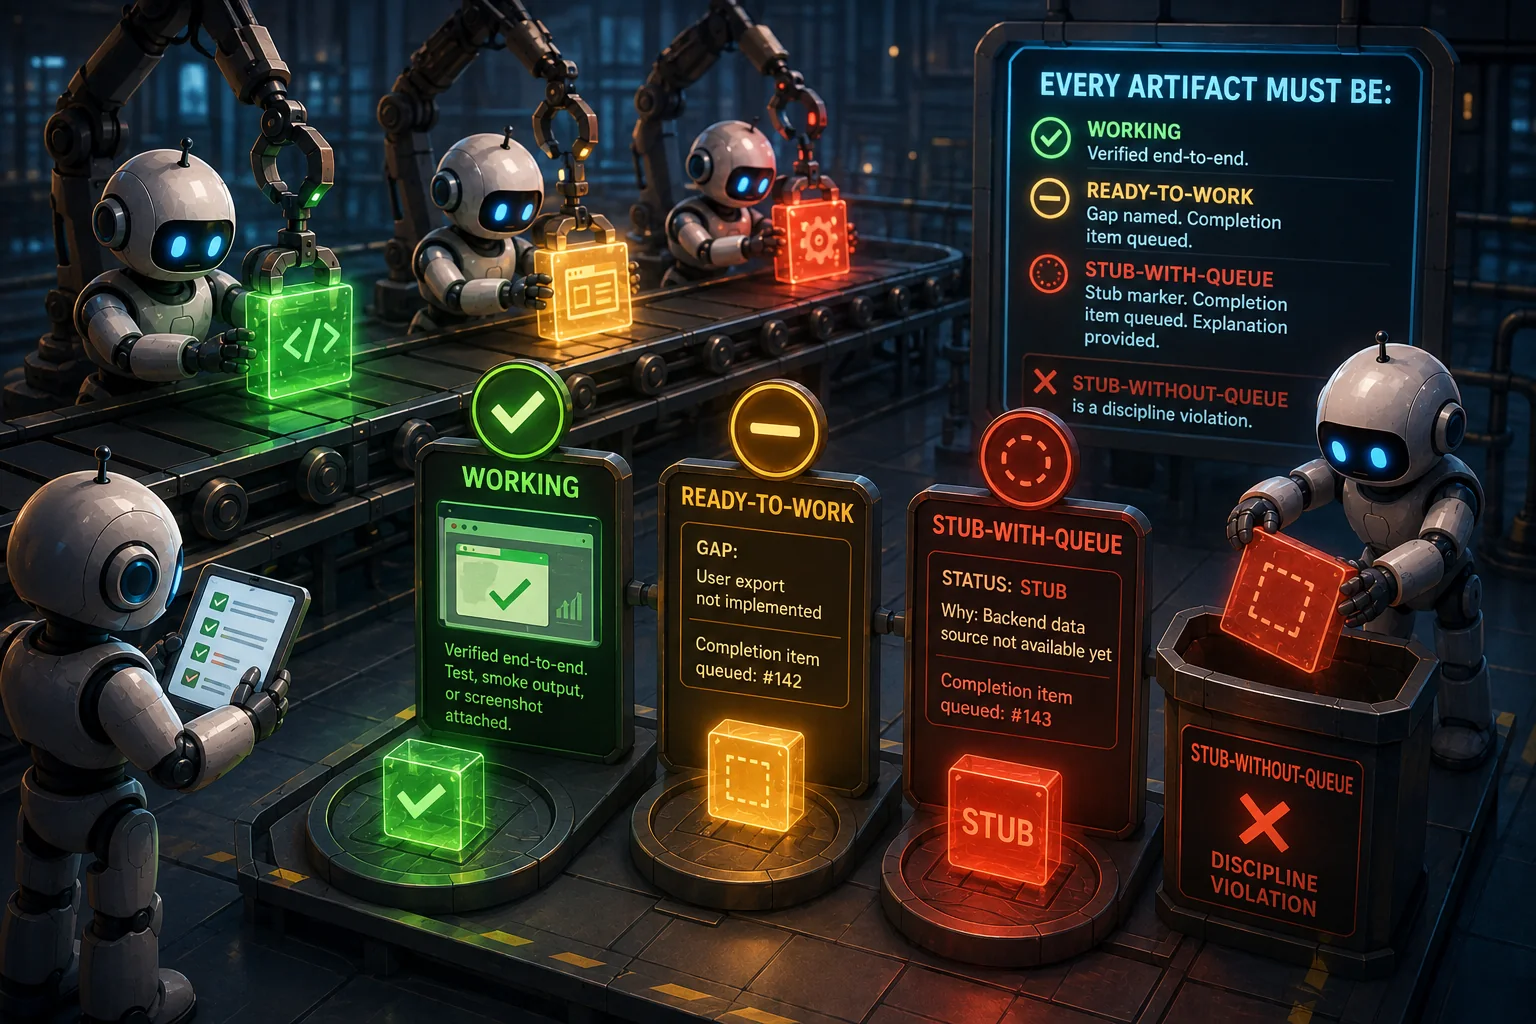
Een subtielere overtreding: een documentatiebestand opleveren met markdownlinks naar zusterbestanden die niet bestaan. Het linkdoel zou een stub-met-wachtrij-bestand moeten zijn, maar is zelfs dat niet — het is een leegte. De linkchecker van de reviewer laat CI falen; de deploypoort weigert; het platform loopt vast. Precies dit faalpatroon heb ik opgeleverd in de sessie waaruit dit artikel voortkwam — en de analyselus ving het binnen enkele uren op. Daarover verderop meer.
Het universele koudestartprotocol
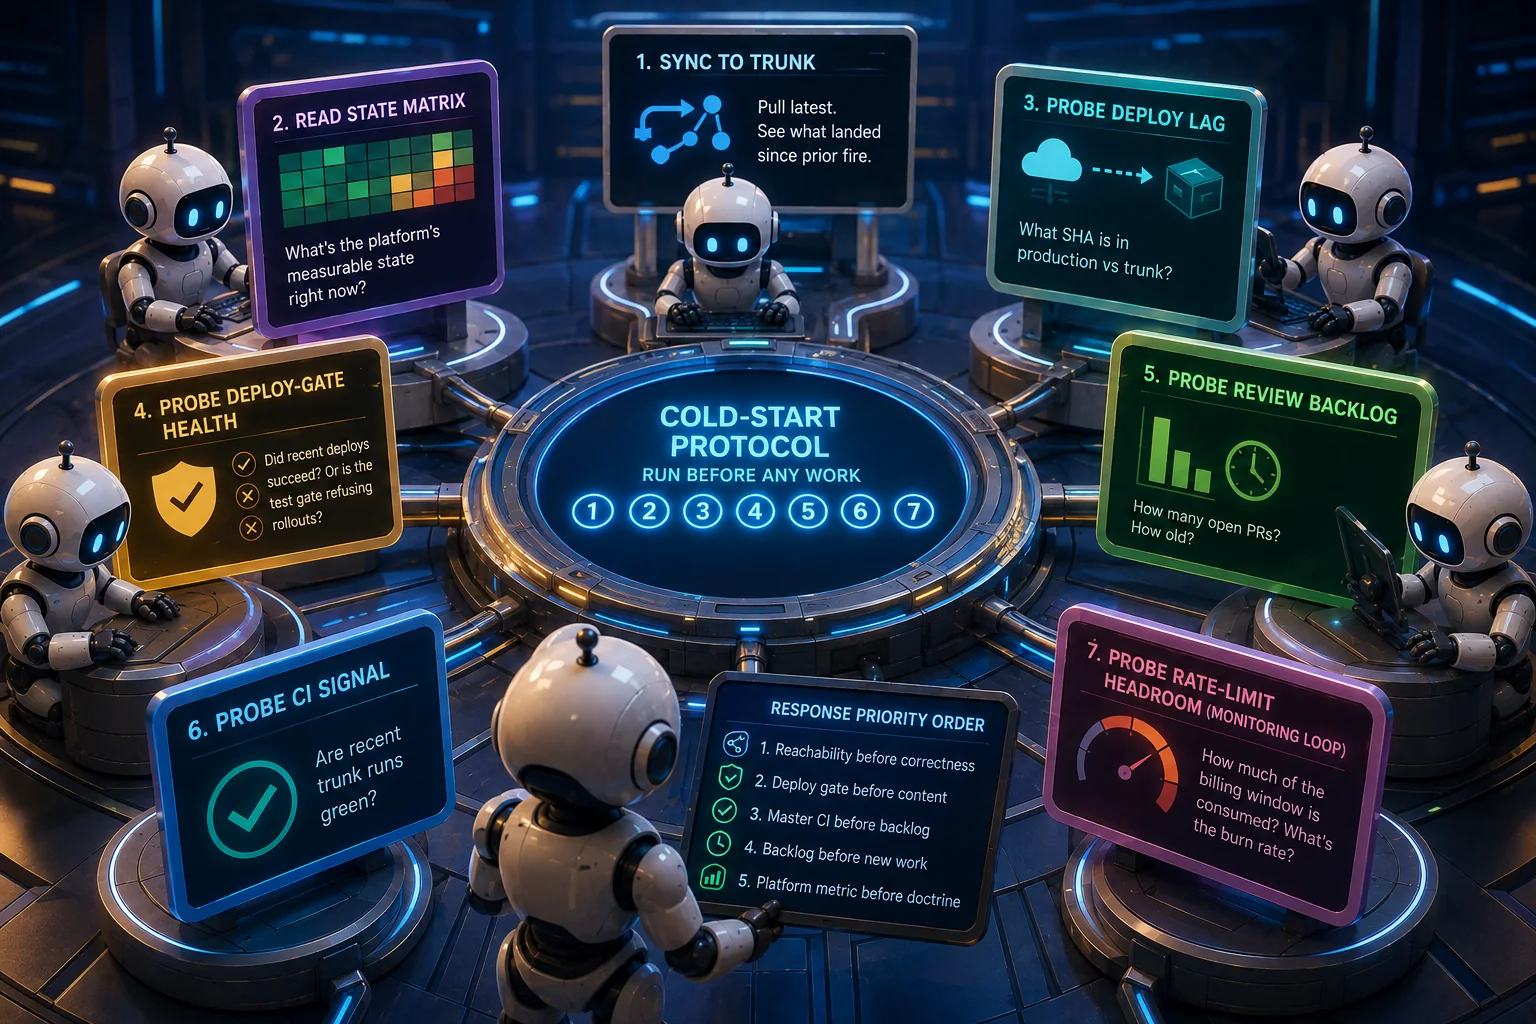
Elke lus voert aan het begin van elke run dezelfde zes controles uit, voordat enig werk begint:
- Synchroniseer met de huidige trunk. Pull. Kijk wat er sinds de vorige run is binnengekomen.
- Lees de canonieke toestandsmatrix. Wat is de meetbare toestand van het platform op dit moment?
- Controleer de deploy-vertraging. Welke SHA draait in productie tegenover de trunk? Het vaakst voorkomende knelpunt zit precies hier.
- Controleer de gezondheid van de deploypoort. Waren recente deployments geslaagd? Of weigert de testpoort uitrol?
- Controleer de reviewachterstand. Hoeveel openstaande PR’s? Hoe oud?
- Controleer het CI-signaal. Zijn de recente runs op de trunk groen?
Plus een zevende in de monitoringlus:
- Controleer de resterende ruimte binnen de limieten. Hoeveel van het huidige factureringsvenster is verbruikt? Wat is het verbruikstempo?
Na de controles past elke lus zijn reactieregels toe in een prioriteitsvolgorde met onderbouwing: bereikbaarheid vóór correctheid, deploypoort vóór inhoud, CI van de hoofdbranch vóór backlog, backlog vóór nieuw werk, platformmetriek vóór doctrine.
Dit klinkt bureaucratisch. Het is het tegenovergestelde — het neemt de agent de vrijheid om slecht te kiezen. Een lus die wordt geconfronteerd met “deploypoort geweigerd, vier PR’s niet gereviewd, CI rood, backlog groeit, laagst gescoorde functiegebied op F” hoeft niet meer na te denken over prioriteit. Het protocol beslist: eerst de deploypoort.
Dertien robuustheidsinvarianten
Protocollen die de toestand onderzoeken, zijn van nature broos. Controles lopen vast, bestanden ontbreken, netwerken vallen uit. Dus:
- I-1. Elke controle heeft een harde timeout (standaard 10 seconden, 30 seconden voor SSH).
- I-2. Elke controle heeft een afgeslankte terugvaloptie (het falen van een controle betekent niet dat de run faalt).
- I-3. Conflicten worden opgelost via prioriteit met onderbouwing, niet via de eerste treffer.
- I-4. Detectie van verouderde toestand (ouder dan 24 uur leidt tot een nieuwe doorloop).
- I-5. Herstel na een crash bij een koude start (open gelaten branches, verlopen locks, niet-gecommitte toestand).
- I-6. Concurrentie via leases. Elk lustype houdt een eigen lockbestand aan. Twee gelijktijdige runs van hetzelfde lustype kunnen niet botsen.
- I-7. Niets doen als standaard is gelijk aan expliciet neutraal, met melding. Stille runs zonder actie zijn onmogelijk.
- I-8. Auditlog per run. Controleresultaten, beslissing, actie en verificatie worden allemaal vastgelegd.
- I-9. Verificatie na de actie is verplicht. Mislukte verificatie betekent TERUGDRAAIEN, niet opnieuw proberen.
- I-10. Kostenplafond per run (200.000 tokens). Op hol geslagen lussen blijven begrensd.
- I-11. Een operator-onderbreking leidt tot een nette stop. Een STOP-bestand midden in een run betekent een schone exit, geen halve toestand.
- I-12. Veilig voor de opstart. Werkt bij de allereerste run, wanneer de toestandsbestanden nog niet bestaan.
- I-13. Worktree-isolatie. Elke lus werkt in zijn eigen git worktree — aparte werkmap, dezelfde gedeelde
.git-repository. Zonder dit botsen twee lussen die één werkboom delen bij elke checkout en pull. Ontdek deze les niet op de harde manier; configureer het meteen vanaf het begin.
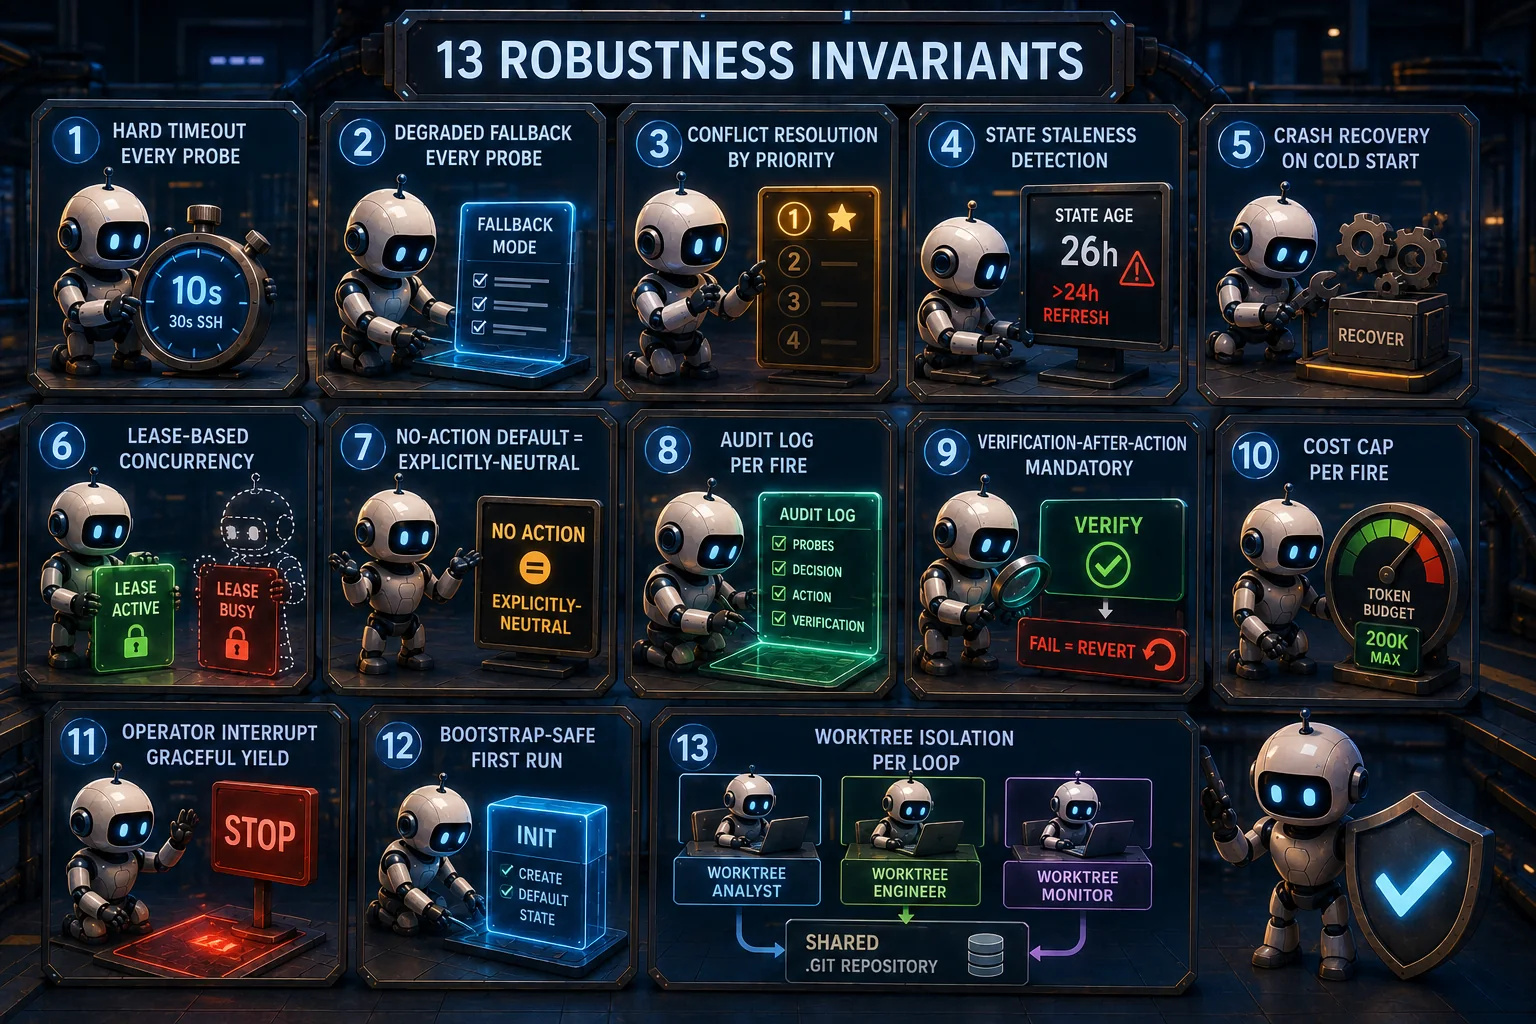
I-13 is degene die ik na deze sessie heb toegevoegd. De andere twaalf had ik goed. Het botsingspatroon dat I-13 voorkomt, wordt beschreven in de sectie “Wat dit patroon nog steeds breekt” hieronder.
De matrix van model en denkmodus
Moderne platformen voor codeeragents laten u zowel de modelgrootte kiezen ALS de denkmodus (normaal versus uitgebreid denken met een expliciet redeneerbudget). Het kostenverschil tussen goedkoopst en duurst bedraagt ruwweg 60×. Als elke activiteit standaard “het slimste model met het diepste denken” gebruikt, verbrandt u geld aan routinewerk dat niets aan diepgang heeft.
De koppeling van activiteit aan model:
- Routinematige botreview van een PR — kleiner model, normaal denken. Patroonherkenning aan de hand van regels; geen nieuw redeneerwerk nodig.
- Codereview van een substantiële wijziging — grootste model, uitgebreid denken (16k+ tokens). Subtiele correctheid vraagt diepgang.
- Toestandscontrole bij een koude start — kleiner model, normaal denken. Mechanisch; diepgang verspild.
- Synthese over meerdere polen, zoals driftdetectie — kleiner model, uitgebreid denken (~8k tokens). Vergelijking van meerdere bronnen profiteert van wat meer redeneerruimte.
- Oorzaakanalyse bij gestokte convergentie — grootste model, uitgebreid denken (16k tokens). Het diagnosticeren van fouten op systeemniveau.
- Architectuurbeslissing die verhardt — grootste model, uitgebreid denken (16k+ tokens). Een verkeerde architectuur kost weken; betaal voor diepgang.
- Routinematige debugging met bekende patronen — kleiner model, normaal denken. Opzoekwerk.
- Nieuwe debugging van meer dan 30 minuten — grootste model, uitgebreid denken (16k+ tokens). Diepgang loont.
- Beveiligingsaudit — grootste model, uitgebreid denken (16k+ tokens). Subtiel redeneren over dreigingsmodellen.
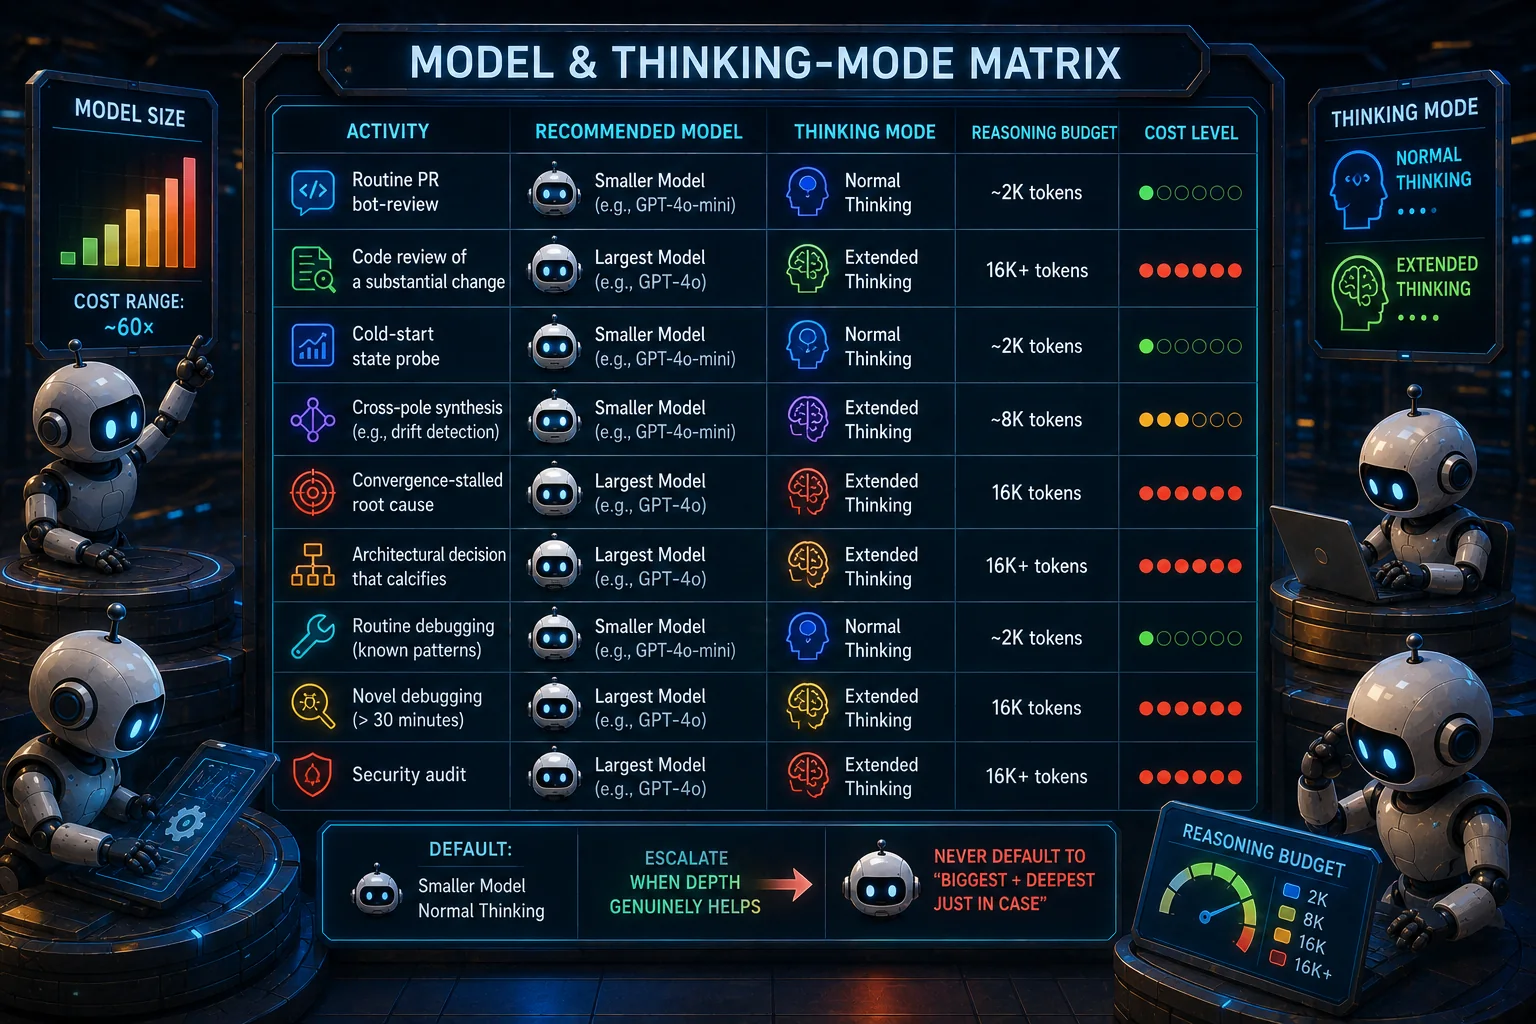
Standaard: kleiner model + normaal denken. Schaal op wanneer diepgang echt helpt. Kies nooit “het grootste + het diepste voor alle zekerheid” als standaard — de grootste kostenpost in elk agentsysteem zijn subagents die het model van hun ouder overnemen terwijl ze een goedkoper model zouden moeten kiezen.
De grens tussen agent en operator
De belangrijkste regel: agents schuiven werk niet stilzwijgend door naar de menselijke operator.
Wanneer een autonoom codeersysteem iets niet kan — domeinexpertise, marktpositionering, tests met echte gebruikers, beslissingen over het businessmodel — is er de verleiding om “de operator moet…” in de documentatie te schrijven. Dat is niet eerlijk. Zo worden de moeilijke delen afgeschoven op het moment dat de operator er het minst klaar voor is (vroeg in het leven van het product, wanneer er nog geen MVP is).
Wat agents WEL opleveren: functiescores optillen van kapot naar werkend; ontwerppolish; concurrentieanalyses op basis van openbare bronnen; integratiediepte; UX-tests vóór de eerste klant (via de gebruikersgerichte testlus); onboardingflows; rapportagefuncties.
Wat alleen de operator kan beslissen: strategische prioriteit (welke functie het zwaarst weegt voor de markt die hij kent); businessmodel; de uiteindelijke esthetische voorkeur tussen twee conforme ontwerpen; expliciete toestemming om te omzeilen (wanneer een agent zegt “deze test is flaky, mag ik omzeilen”); herclassificatie van prioriteitsniveaus.
Tests met echte klanten worden UITGESTELD, niet doorgeschoven. Echte gebruikers binnenhalen vóór de MVP verbrandt goodwill op een kapot product. De gebruikersgerichte testlus neemt die rol over tot de MVP-drempel is bereikt. Daarna komen echte gebruikers erbij om te vinden wat de gesimuleerde tester heeft gemist.
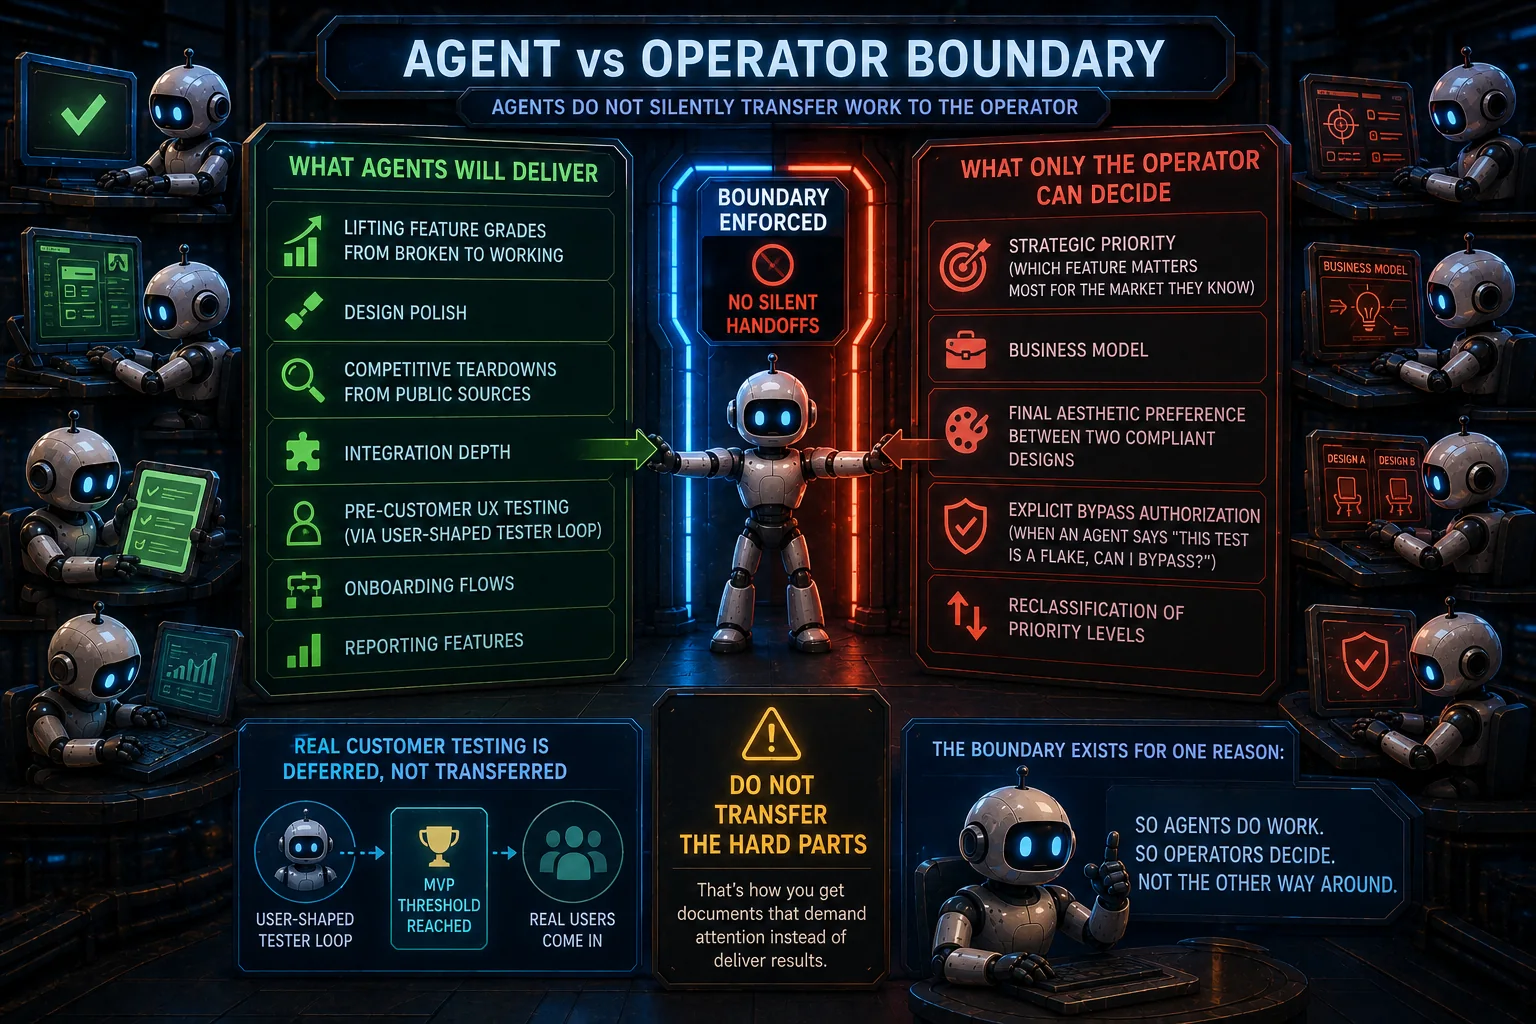
Dit is de grens die operators het hardst moeten afdwingen. Zonder die grens wordt het agentsysteem iets dat aandacht van de operator opeist in plaats van iets dat werk verzet.
Het ene canonieke toestandsbestand
Alle vier de lussen, alle disciplineregels, alle protocollen — ze zijn nutteloos als er geen gedeelde definitie is van “wat is de toestand van het platform op dit moment”.
Eén bestand. Een trendtabel waaraan alleen wordt toegevoegd. Elke rij is een momentopname. De kolommen zijn de metrieken waar het product om draait: functiescores per gebied, slaagpercentages, aantallen blokkades, wachtrijdieptes.
Elke lus leest dit bestand bij een koude start. Convergente runs werken het bij. Driftend-neutrale runs niet. Na een week of twee IS de trend in dit bestand het antwoord op “leveren de agents convergentie op”.
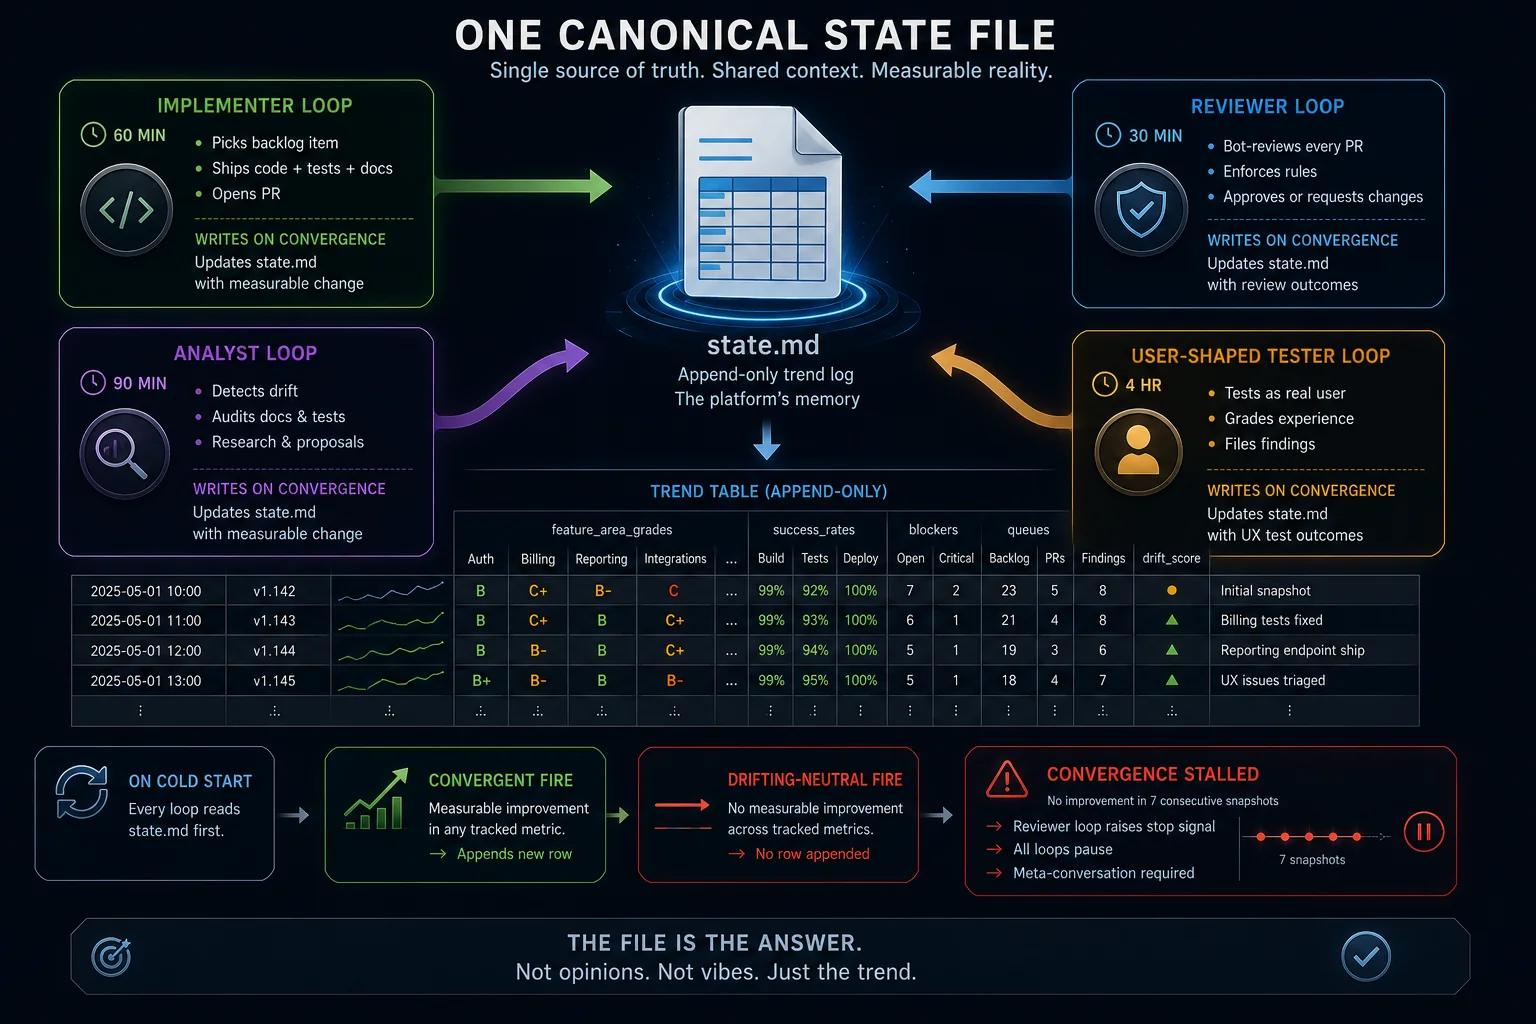
Als 7 opeenvolgende momentopnames geen beweging tonen, meldt de reviewlus: “convergentie gestokt — lussen pauzeren, metagesprek nodig.” Het bestand is het veiligheidsventiel dat het geval opvangt waarin elke afzonderlijke run beweert productief te zijn, maar het geheel dat niet is.
Wat dit patroon nog steeds breekt
Dit is de sectie die het oorspronkelijke concept van dit artikel niet had. Het kostte me een sessie vol drift om haar toe te voegen.
Auteursdrift
De persoon (of agent) die een regel schrijft, overtreedt haar routinematig voordat de inkt droog is. Ik leverde een discipline per artefact op die zei “elk artefact wordt WERKEND, STARTKLAAR of STUB-MET-WACHTRIJ opgeleverd” — en in dezelfde sessie leverde ik een documentatieboom op met 16 hangende markdownlinks die in geen van die toestanden pasten. De analyselus ving het binnen enkele uren op. Ik was de auteur van de regel die mijn eigen overtreding aanwees.
De les: zelfhandhaving van discipline werkt niet. De review- en analyselussen zijn geen luxe; ze zijn het enige dat auteursdrift opvangt. Bouw ze eerst. De regels die u zelf schrijft, zullen u niet binden zonder externe handhaving.
Botsingen in een gedeelde werkboom
Als u alle vier de lussen vanuit dezelfde fysieke map laat draaien, botsen ze bij elke git-bewerking. De ene lus doet git checkout <branch> en de git status van de andere lus meldt plotseling een andere werkelijkheid. Half gemergede commits worden aan de verkeerde sessie toegeschreven. Ongevolgde bestanden verschijnen en verdwijnen, afhankelijk van welke branch de laatste lus uitcheckte.
De oplossing is invariant I-13 hierboven: elke lus werkt in zijn eigen git worktree. Aparte werkmap, gedeelde .git-database. Het commando git worktree add is één regel en lost de hele klasse van fouten definitief op.
Ik leerde dit door herhaaldelijk te botsen met mijn eigen analyselus, terwijl ik in dezelfde map een hoofdsessie rechtstreeks als operator draaide.
Valkuilen bij het starten
Drie vallen waar u in trapt nog voordat de lussen beginnen te draaien.
- Val 1: Prompts van meerdere regels worden afgekapt. Het doorgeven van procesargumenten onder Windows stopt bij de eerste regeleinde. Een briefing van 3.300 tekens die als positioneel argument aan het agent-programma wordt meegegeven, komt bij het programma aan als de eerste 70 tekens. Gebruik de vlag voor bestandsinvoer (
--append-system-prompt-file <path>of het equivalent) of geef de tekst door via stdin — alles wat geen regeleinden in argv zet. - Val 2: Slash-commando’s bestaan alleen in de gebruikersinterface. Als uw briefing de agent opdraagt als eerste actie
/rename "Dev /loop"uit te voeren, kan die dat niet. Slash-commando’s worden afgehandeld door de gebruikersinterface, niet door de agent. Stel de sessienaam in bij het starten (de meeste platformen hebben een vlag-nof--name) en laat de instructie volledig weg. - Val 3: De doorgifte van native argumenten door PowerShell 5.1 is onbetrouwbaar. Spaties, apostroffen en schuine strepen in argumentwaarden kunnen worden verminkt wanneer PS 5.1 ze via de modus
-Fileaan een native exe doorgeeft. De diagnose is ondubbelzinnig: dezelfde exe handmatig starten vanuit interactieve PowerShell werkt; starten via cmd → powershell -File script.ps1 -Param "value" faalt. De oplossing: laat de PowerShell-laag vallen en laat cmd de native exe rechtstreeks aanroepen.
Alle drie raakte ik in één sessie. Geen enkele is exotisch — ze zijn dragend voor elke opzet op een Windows-host. Geen enkele staat in de README’s van agentplatformen. Reken een dag om ze te vinden.
De kloof tussen kosten en waarde
De sessie waaruit dit artikel voortkwam, kostte grofweg $157 aan rekenkracht tegen API-tarief (het eigenlijke abonnement is vast; het dollarbedrag is wat hetzelfde werk zou kosten bij betalen per gebruik). De sessie leverde negen gemergede pull requests op met doctrine, infrastructuur en proces. Ze leverde nul voor de gebruiker zichtbare productverbeteringen op. De productfix die ik vroeg in de sessie committe, haalde de productie nooit omdat de deploypoort weigerde — wegens 15 falende tests plus de 16 hangende markdownlinks die ik zelf had opgeleverd.
Dit is de kloof tussen kosten en waarde, rechtuit benoemd. De discipline die ik in dit artikel beschrijf, is precies in die sessie opgebouwd. De meetbare toestand van het platform verbeterde niet. De infrastructuur waarmee toekomstige sessies hem wel verbeteren, bestaat nu — en u moet eerlijk zijn tegenover uzelf (en uw operator) wanneer dat de afweging is die u hebt gemaakt.
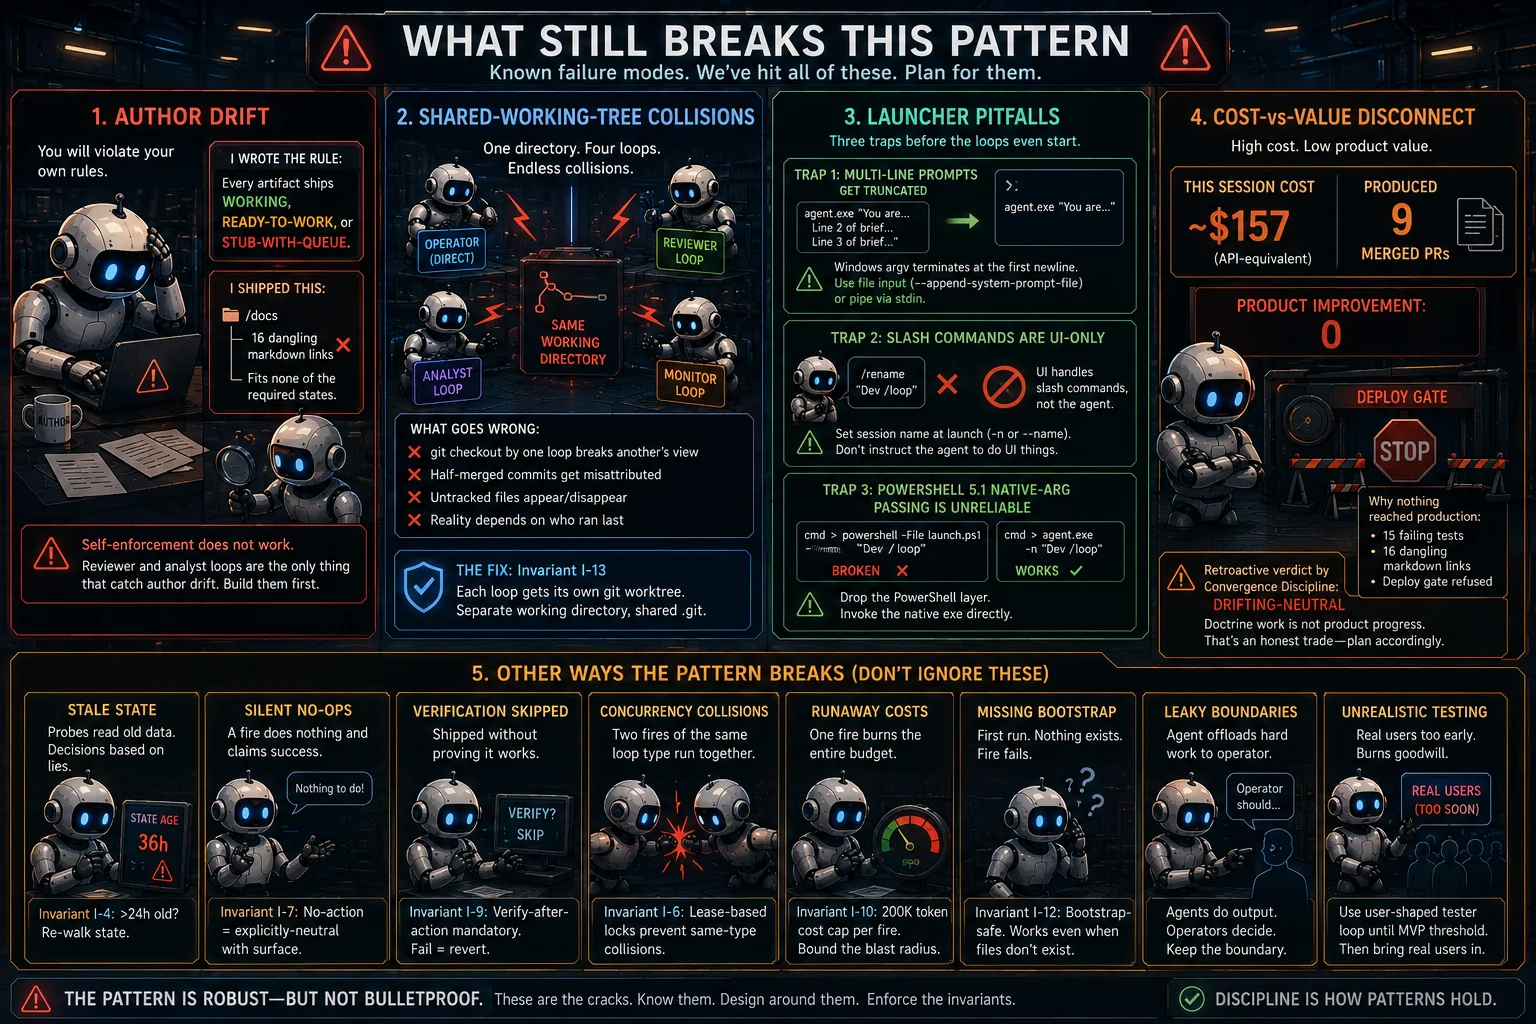
De convergentieregel, met terugwerkende kracht toegepast, zou de hele sessie als DRIFTEND-NEUTRAAL hebben aangemerkt. Dat is de regel die doet wat hij moet doen. Hij zegt u ook iets ongemakkelijks: een sessie die is opgezet om een artikel over discipline te produceren, kan moeilijk ook productvoortgang produceren, want elke minuut die naar doctrine gaat, is een minuut die niet naar de functie gaat. Plan dienovereenkomstig.
Wat dit NIET zal doen
Eerlijke grenzen aan wat de discipline wel en niet kan opleveren:
- Ze tilt elk functiegebied van kapot naar werkend. Ze bereikt niet de absolute topscore zonder werkmethoden op domeinniveau plus verificatie van toestandswijzigingen.
- Ze levert een productieklare esthetiek via een poort voor het designsysteem. Ze schept niet de esthetische basis voor het eerst — de operator kiest de ontwerptaal.
- Ze stelt concurrentieanalyses voor functiepariteit samen uit openbare bronnen. Ze beslist niet over strategische positionering tegenover gevestigde spelers — dat is de marktkennis van de operator.
- Ze voert UX-tests uit vóór de eerste klant, via een gesimuleerde onwetende gebruiker. Ze vindt niet de echte pijnpunten van klanten — echte gebruikers komen erbij na de MVP.
- Ze houdt convergentie vol tegen bekende kosten. Ze brengt u niet van MVP naar “beste op de markt” — daarvoor zijn inputs nodig die de lussen niet hebben.
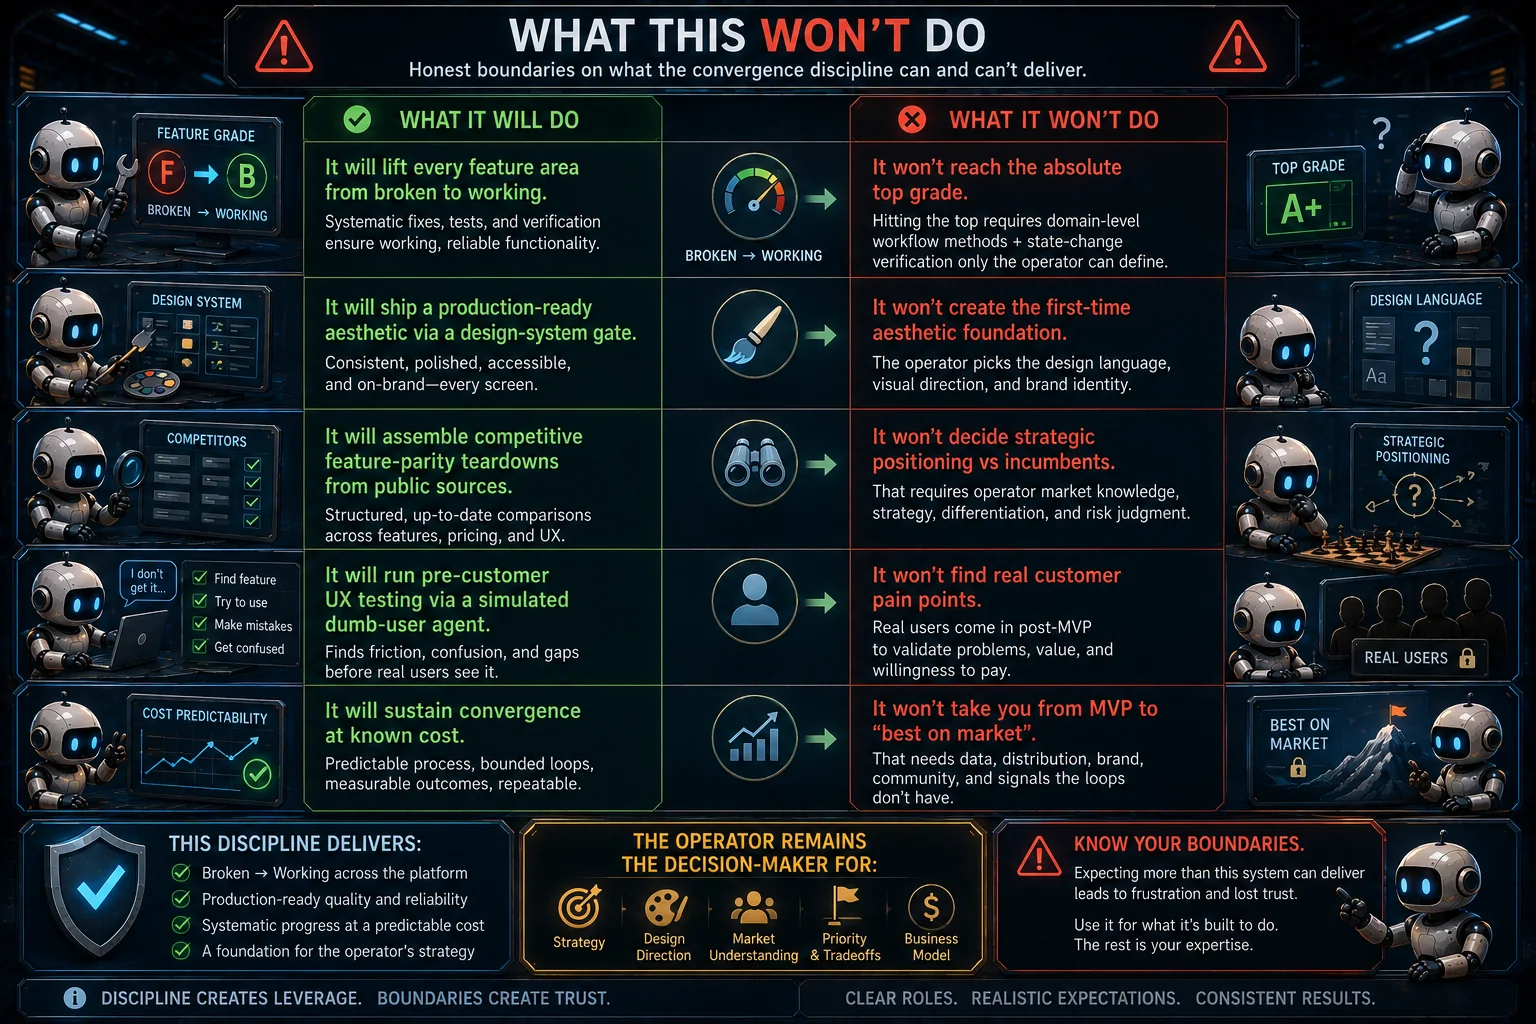
Benoemen wat niet zal gebeuren, maakt deel uit van de discipline. Zonder dat verwachten operators meer dan het systeem kan leveren en verliezen ze vertrouwen wanneer het tekortschiet.
Wat het kost
Een vierlussensessie die 8 uur per dag draait met een tempo dat de matrix respecteert, kost per maand grofweg het equivalent van het tooling-budget van één engineer van gemiddeld niveau. Het eigenlijke abonnement is vast; de beperking zijn de limieten per factureringsvenster, niet de dollars.
Alles standaard op het grootste model met het diepste denken zetten? Grofweg 5 tot 7 keer dat bedrag. De discipline van de matrix is het verschil tussen houdbaar autonoom engineeren en een op hol geslagen factuur.
Wat het per sessie kost, is veranderlijker. Een sessie die enkel doctrine oplevert — zoals die waaruit dit artikel voortkwam — verbrandt budget zonder productverbetering. Dat is geen verspilling als de doctrine zich in de komende sessies terugbetaalt in convergentie, maar het IS verspilling als de doctrine onafgedwongen blijft liggen.
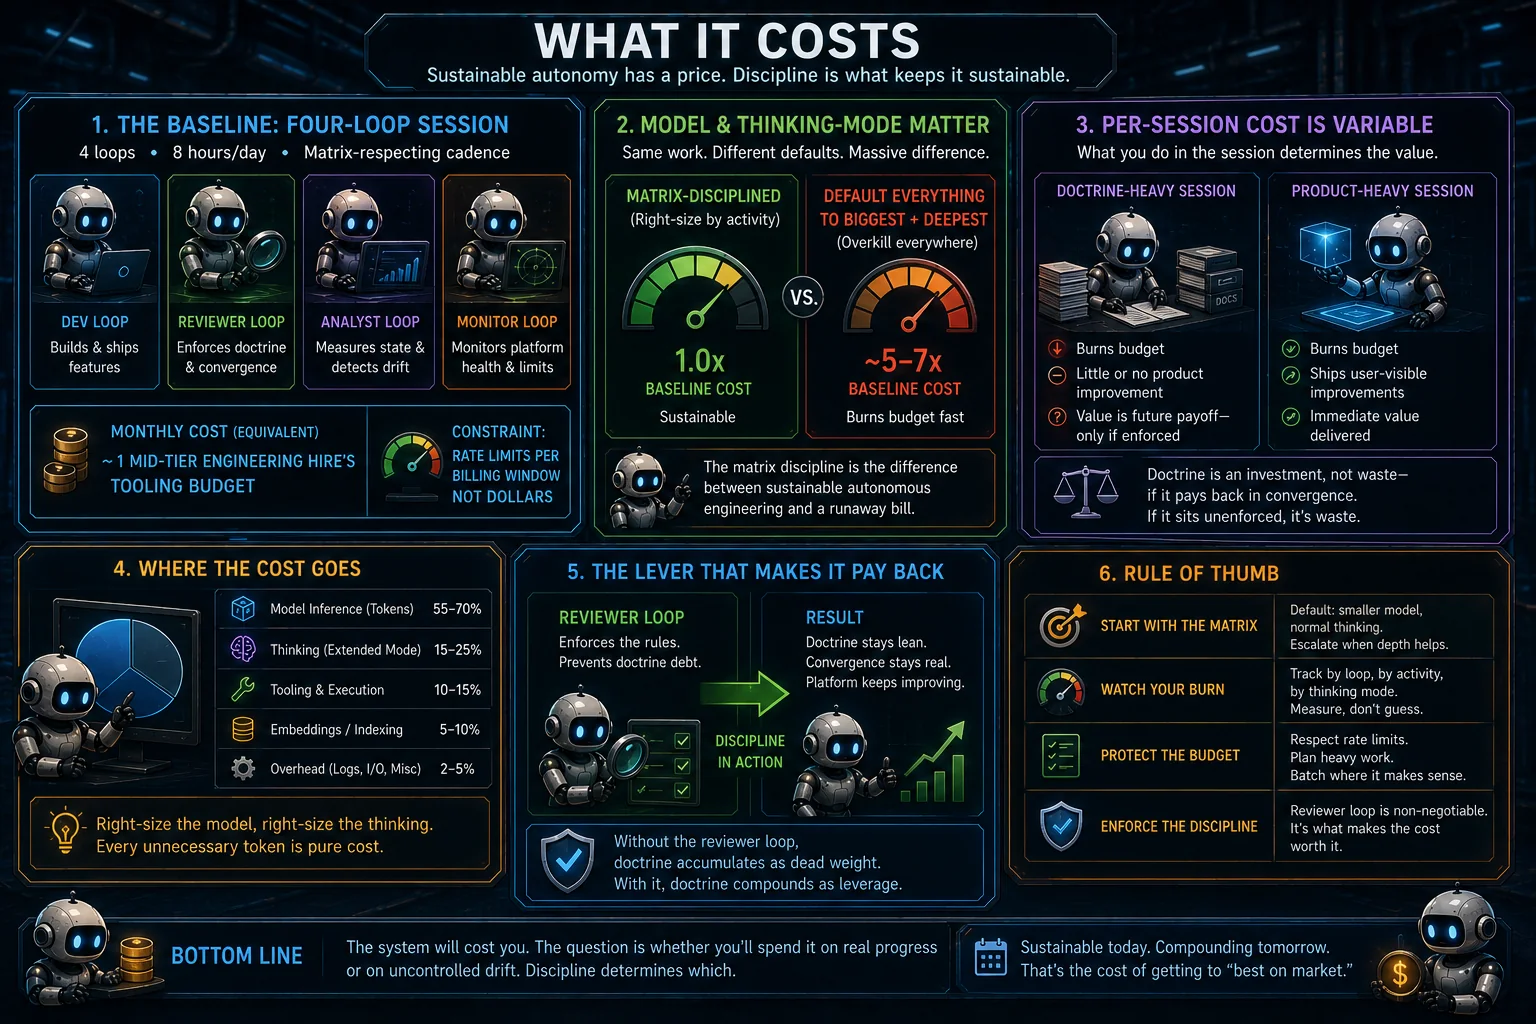
De reviewlus zorgt ervoor dat doctrine zich terugbetaalt. Zonder die lus stapelt doctrine zich op als dood gewicht.
De les die ik steeds opnieuw leer
Elke keer dat ik een nieuwe regel, agent of werkwijze aan dit systeem toevoeg, zet ik last op de toekomst. De convergentiediscipline is de enige regel die netto de last verlaagt — ze dwingt elke andere toevoeging om zich terug te betalen in meetbare verbetering.
De pathologie die ik aan het begin van dit artikel beschreef — “de agents zijn productief maar het product beweegt niet” — is een falen van discipline, geen falen van tooling. De agents doen precies wat u zegt: commits opleveren, CI halen, documentatie bijwerken. Ze kregen alleen niet te horen dat de commits een meetbare as moesten doen bewegen.
Zodra u hun dat zegt, met expliciete regels per run en per artefact, met één canoniek toestandsbestand, met scheiding van verantwoordelijkheden over vier lussen, met de eerlijke grens rond wat alleen mensen kunnen en met worktree-isolatie zodat ze niet botsen — worden de agents bruikbaar.
Niet magisch. Bruikbaar. Soms.
Dat “soms” is het deel dat het oorspronkelijke concept van dit artikel miste. De discipline is het doel. Ook als ze is opgeschreven, ook als de regels expliciet zijn, ook als de reviewlus draait, zult u (en uw agents) afdrijven. De drift wordt opgevangen — daar is de analyselus voor — maar niet voorkomen. Het mechanisme corrigeert zichzelf, maar het voorkomt zichzelf niet.
Dat onderscheid doet ertoe. De literatuur over AI-engineeringtools staat vol “magische” beweringen. De werkelijkheid is: een kleine set gedisciplineerde patronen, streng afgedwongen door andere agents (niet door zelfdiscipline), die autonome agents de meeste tijd echt werk laten doen, met opgevangen en gecorrigeerde drift de rest van de tijd. Al de rest is toneel.
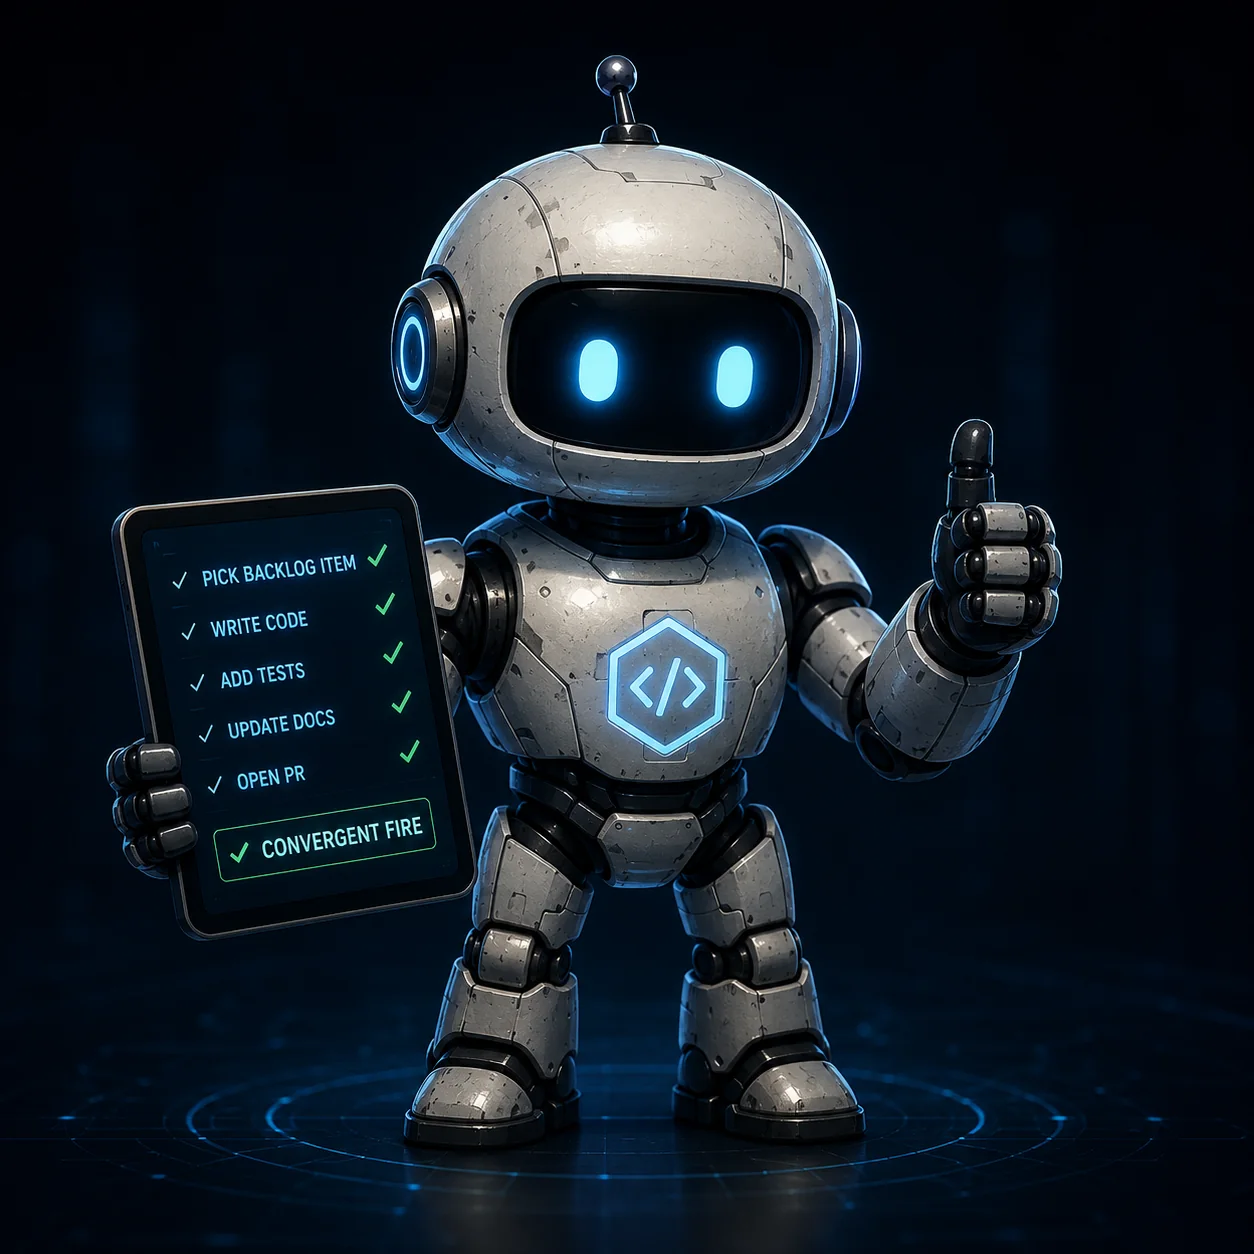
Als u codeeragents op een echte codebase laat draaien en de faalpatronen ziet die ik heb beschreven, kunnen de patronen hierboven helpen. Ze zijn niet nieuw; de meeste zijn een codificatie van wat goede engineeringteams al doen. Het nieuwe is dat ze dragend worden gemaakt voor autonome lussen waar geen mens in de directe omgeving is om ze impliciet af te dwingen — en dat de faalpatronen worden benoemd die de discipline toch overleven.
Addendum. Spiekbriefje
Deze pagina is een volledige kopie van het verhaal zoals het op Medium is verschenen. Lees het op Medium. Illustraties gegenereerd met AI.