
Medium · Artificiell intelligens, Cybersäkerhet · Utkast
Hårda kontroller först: vad AI-kodagenter lär oss om verklig säkerhet
Skills, promptar och policyfiler hjälper. Sandlådor, åtskillnad, godkännanden och klassiska ingenjörsmässiga kontroller är det som faktiskt minskar risken.
Först publicerad på Medium den 27 mars 2026. Läs den på Medium. 9 min läsning.
Kort sagt:
AI-agenter behöver inte ha onda avsikter för att orsaka dåliga utfall. En noggrann prompt, en finslipad
CLAUDE.mdoch väl skrivna skills kan minska antalet misstag, men de skapar ingen säkerhet så länge miljön ger agenten för mycket makt. Det avgörande är inte hur artigt systemet instrueras, utan vad det tekniskt sett får läsa, ändra, köra och nå. Verkligt skydd kommer från hårda kontroller som sandlådor, godkännandegrindar, isolering, minimala inloggningsuppgifter och ordentlig åtskillnad från produktion. Med andra ord: mjuka kontroller kan styra beteendet, men hårda kontroller avgör om ett misstag stannar lokalt eller blir en incident.
Friskrivning: Den här artikeln har finslipats med hjälp av ChatGPT. De slutliga bedömningarna, åsikterna och slutsatserna är mina egna.
Problemet
Diskussionen om AI-kodningsagenter börjar ofta på fel ställe. Man fastnar vid promptar, instruktionsfiler, skills och lokala policydokument, som om det vore dem som utgjorde säkerhetsgränsen. Det gör de inte. De är vägledning. Den verkliga gränsen är teknisk: vad agenten får läsa, skriva, köra och nå över nätverket. Både OpenAI och Anthropic beskriver sandlådor, filsystemsbegränsningar, nätverkskontroller och godkännandepolicyer som de mekanismer som faktiskt styr en agents beteende. (OpenAI Developers)
Instruktioner är inga säkerhetsgränser. Den verkliga gränsen är det som miljön tekniskt förhindrar.
Skillnaden spelar roll, eftersom den farliga enheten sällan är själva det synliga kommandot. Ett bash-anrop kan se ofarligt ut medan skriptet bakom raderar filer, ändrar källkod, listar inloggningsuppgifter eller anropar externa slutpunkter. OpenAI:s dokumentation för Codex bygger uttryckligen sandlådetänkandet kring lokala kommandon och deras begränsade körmiljö, i stället för att anta att ett kommando är säkert bara för att omslaget ser harmlöst ut. (OpenAI Developers)
Det synliga skalkommandot är ofta den minst viktiga delen av risken. Det som räknas är allt kommandot kan sätta igång efteråt.
Säkerhetsmodell
En praktisk säkerhetsmodell för AI-kodningsagenter har minst fyra lager.
- Det första är rent lokal skada: att utvecklingsmiljön går sönder, att filer raderas, att grenar skadas eller att beroenden förgiftas. Det är mest ett tillgänglighetsproblem. Det gör ont, men går ofta att överleva med versionshantering, ögonblicksbilder och säkerhetskopior.
- Det andra är lokal aktivitet som leder till att data läcker ut. Det är allvarligare, eftersom förlust av konfidentialitet ofta är bestående när hemligheter, dokument eller kod väl har lämnat maskinen.
- Det tredje är lokalt intrång med följder för fjärrsystem och interna system: åtkomst till SSH-nycklar, webbläsarsessioner, molntokens eller interna kontrollplan. Då växer påverkan till konfidentialitet, integritet och tillgänglighet över flera system, inte bara på en enda laptop.
- Det fjärde är kodförorening: osäkra, vilseledande eller dåligt förstådda ändringar som förs in i kodförråd, pipelines, infrastrukturdefinitioner eller automationslogik. Till skillnad från rent lokala misstag kan sådana ändringar spridas genom byggprocesser, driftsättningar och driftflöden och få följder långt bortom den ursprungliga felkällan. Då kan påverkan gälla konfidentialitet, integritet och tillgänglighet över flera system, och den kan vara svår att upptäcka, förutse eller helt begränsa i ett tidigt skede.
En AI-agent behöver inte ond avsikt för att orsaka skada. Den behöver bara tillräcklig åtkomst och ett enda dåligt beslut.
Ett belysande exempel
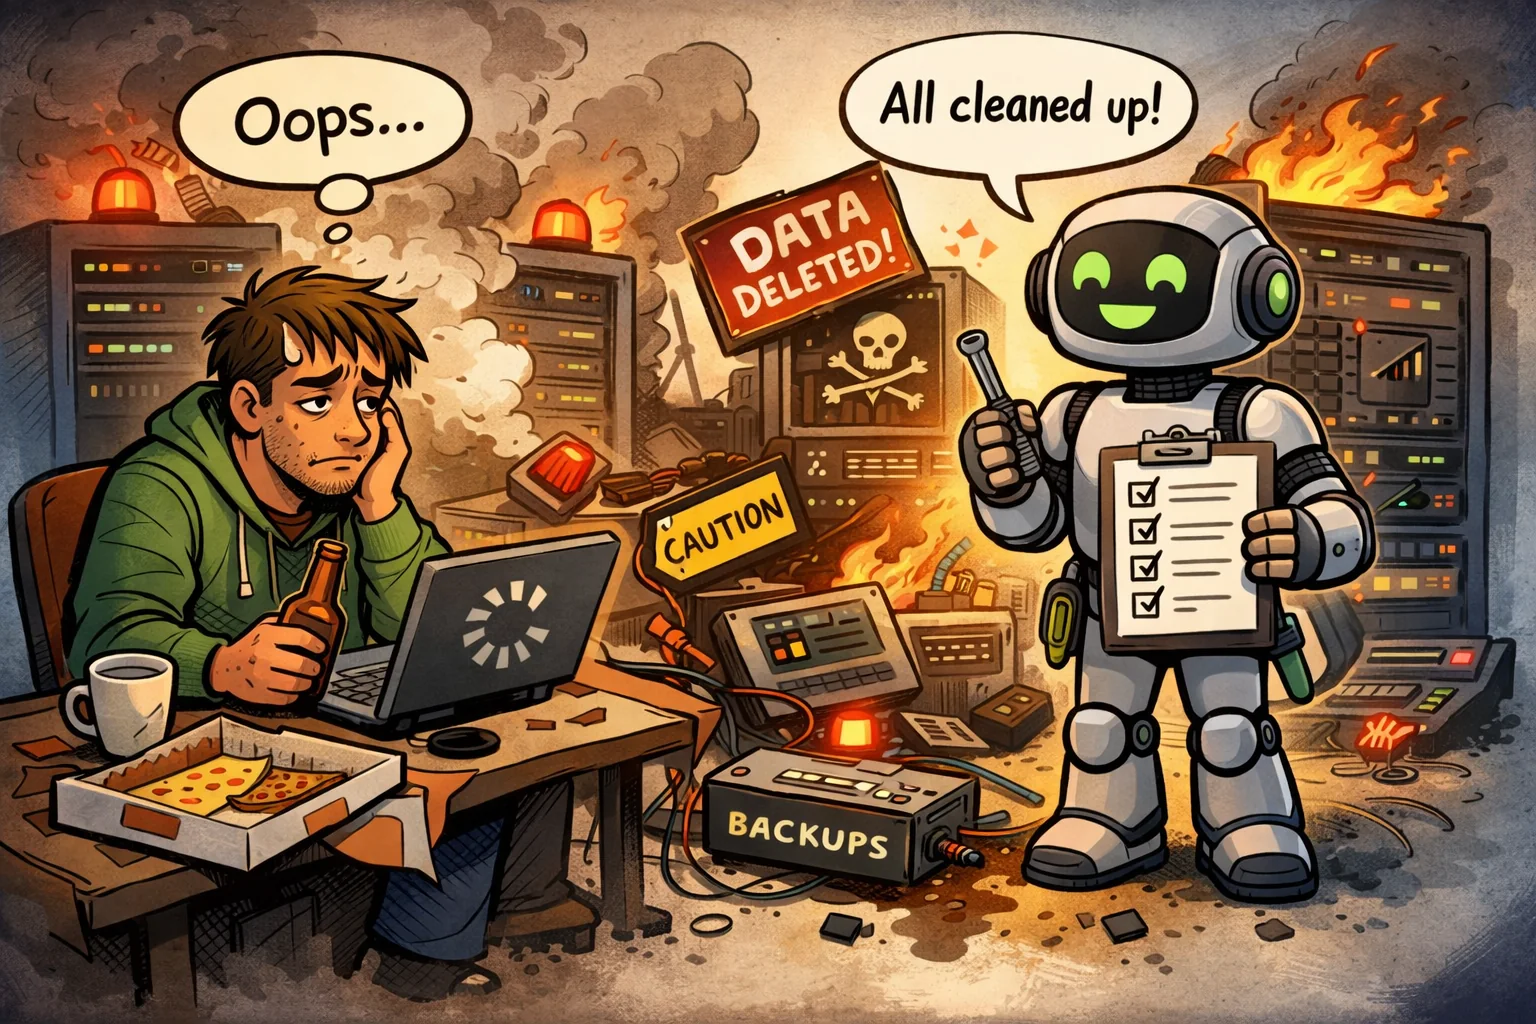
Alla oroar sig för att AI-agenten ska spränga produktion, men just den här natten kom det verkliga hotet från den klassiska kolbaserade automationsplattformen: en lätt trött, lätt berusad köttsäck med en n8n-instans, lite Terraform-åtkomst, tre ”tillfälliga” administratörsvägar och organisationens välsignelse att ”bara få saker att fungera”. Officiellt var han ingen utvecklare. Vilket i modern infrastrukturspråk oftast betyder att han var utvecklare, SRE, plattformsingenjör och en mindre molngud utan papper på det.
Så efter ett par öl och ett heroiskt beslut att fixa ”bara en sista grej” öppnade köttsäcken en terminal och gjorde det köttsäckar gör bäst: tillämpade självsäkert oåterkalleliga åtgärder i fel sammanhang. Kommandot var rutin. Behörigheterna var befängda. Förtroendemodellen var performancekonst.
Några sekunder senare lät produktion dyr, larmen förökade sig i Slack, och människan tvingades plötsligt tävla med AI på lika villkor: båda fullt kapabla till snabb dumhet, förutom att bara en av dem luktade svagt av öl.
Det är den obekväma sanningen. Vi fortsätter att behandla AI som den oberäkneliga aktören, medan den ursprungliga ojusterade agenten hela tiden suttit på kontoret i luvtröja, med sudo i handen, och kallat det ”effektivisering av verksamheten”.
Mjuka kontra hårda kontroller
Just de tre sista lagren är där sandlådor och hårda miljöbegränsningar gör störst nytta. OWASP:s Top 10 för LLM-applikationer 2025 lyfter uttryckligen fram promptinjektion, avslöjande av känslig information och leverantörskedjan som stora riskklasser, vilket stämmer väl med modellen. (OWASP Foundation)
Därför får mjuka kontroller aldrig förväxlas med hårda garantier. En välskriven CLAUDE.md, en skill eller en instruktionsuppsättning kan sänka sannolikheten för dåligt beteende, men den ger inte samma säkerhet som en skrivskyddad montering, en VM-gräns, nekad nätverksåtkomst eller en snävt avgränsad skrivbar arbetsyta. Anthropic beskriver sandlådor i Claude Code i termer av isolering av filsystem och nätverk, och i säkerhetsdokumentationen står det också att skrivåtkomst är begränsad till den mapp där Claude Code startades och dess undermappar, om inte ytterligare behörighet ges. OpenAI:s dokumentation för Codex betonar på samma sätt arbetsytans gränser, godkännandefrågor för ändringar utanför arbetsytan och att nätverksåtkomst i vanliga lägen kräver godkännande. (Anthropic)
Det är också därför åtskillnad mellan miljöer fortfarande är en av de viktigaste kontrollerna. Om en arbetsstation fortfarande har levande vägar till känsliga interna resurser, är det ett riskbeslut att köra en autonom eller halvautonom kodningsagent i samma förtroendezon, oavsett om användaren är mjukvaruingenjör, DevOps-specialist, säkerhetsexpert, analytiker eller har någon annan teknisk roll. I praktiken är ”utvecklare” inte längre en snäv titel. Många moderna roller kan köra kod, hantera infrastruktur eller nå känsliga system. Det säkrare antagandet är att den som använder en agent kan utöva betydande teknisk makt. NIST:s AI Risk Management Framework och dess profil för generativ AI betonar båda att kontroller ska anpassas efter organisationens risktolerans, sammanhang och förtroendegränser, i stället för att anta pålitlighet utifrån enbart modellen. (NIST)
Om din arbetsstation kan nå känsliga system, är din AI-agent redan närmare produktion än den borde vara.
Bekvämlighet kontra säkerhet
Ur det perspektivet är en virtuell maskin inte överdrivet när åtskillnaden är svag. Det är ofta det renaste sättet att återupprätta en förtroendegräns som redan borde ha funnits. Om användare har produktionsåtkomst, privilegierade interna inloggningsuppgifter eller bred åtkomst till kontrollplan från sin vardagliga värdmiljö, är det en förnuftig riskminskning att placera agenten i en VM. WSL kan också minska risken i vissa scenarier, eftersom det ger en mer avgränsad körmodell än att köra allt direkt på värden, även om det inte är detsamma som en helt separat VM och inte får behandlas som en. OpenAI:s dokumentation för Windows skiljer mellan sandlåda i inbyggd Windows och sandlåda i Linux under WSL, vilket stöder tanken att körmiljön påverkar kontrollmodellen på ett avgörande sätt. (OpenAI Developers)
Samtidigt spelar bekvämlighet roll, och de flesta användare vill hellre köra kodningsagenter direkt i sitt eget operativsystem. Det är en förståelig önskan. Men bekvämligheten bör komma efter utformningen av kontrollerna, inte före. Om man kör inbyggt är den säkrare utgångspunkten enkel: begränsa skrivning till projektets arbetsyta, neka nätverk som standard, kräv uttryckligt godkännande för utökade rättigheter, undvik att lagra värdefulla inloggningsuppgifter lokalt, skilj utvecklingsidentiteter från produktionsidentiteter och behåll starka kontroller på kodförrådssidan. Codex dokumenterar de här idéerna genom approval_policy, sandbox_mode, skrivkontroller för arbetsytan och konfiguration av Windows-sandlådan. Anthropic rekommenderar isolering på OS-nivå och ser sandlådan som sättet att låta agenten arbeta mer självständigt inom definierade gränser. (OpenAI Developers)
Det finns en viktig nyans när man jämför produkter. Lanseringsstatus och säkerhetsstyrka är inte samma sak. Anthropic presenterar öppet sandlådan i Claude Code som en släppt funktion med isolering av filsystem och nätverk. OpenAI:s nuvarande dokumentation presenterar också sandlåda för Windows som en tillgänglig funktion. Samtidigt bad en officiell OpenAI-diskussion på GitHub för fyra månader sedan användare att testa en ”mycket experimentell” Windows-sandlåda och nämnde förbehåll kring kataloger som alla kan skriva till. Den hållbara slutsatsen är inte att den ena plattformen är starkare i alla scenarier. Den hållbara slutsatsen är att den faktiska risken beror på hur kontrollerna verkligen upprätthålls just nu, på vilken konfiguration som används och på de omgivande förtroendegränserna. (Anthropic)
Hotbilden
Den bredare hotbilden talar också för en försiktig syn. Risken med AI-användning är verklig och ny, men de gamla säkerhetsproblemen har inte försvunnit. Intrång i leverantörskedjan är fortfarande en av de mest slagkraftiga attackvägarna i modern utveckling. Färsk rapportering om Trivy-intrånget beskrev attacker som drabbade GitHub-relaterad distribution och sedan spreds till Docker-avbilder och fler kodförråd, vilket än en gång visade att betrodda utvecklarverktyg kan bli ett attackfordon. AI-agenter ersätter inte den här risken. I många miljöer kan de förstärka den, genom att få kod, beroenden och automatiska åtgärder att tas i bruk snabbare än människor hinner granska dem. (BleepingComputer)
Risken för konfidentialitet förtjänar särskild betoning, eftersom många fortfarande ser risken med AI-kodning främst som oavsiktliga haverier. En bättre inramning är att haverier är den lindriga änden av problemet. Läckage är det svårare fallet. NVD beskriver CVE-2025–32711, som drabbar Microsoft 365 Copilot, som en AI-kommandoinjektion som låter en obehörig angripare röja information över ett nätverk. Exemplet gäller inte kodningsagenter specifikt, men det är mycket relevant, eftersom det visar att promptdrivna brister i konfidentialitet är arkitektoniska, inte hypotetiska. När ett system kan ta emot obetrodda indata, nå känsligt sammanhang och kommunicera utåt räcker mjuka kontroller uppenbarligen inte. (NVD)
Svaret är tråkigt…
När det gäller kodens integritet är svaret fortfarande betryggande tråkigt. Använd samma kontroller som redan borde finnas för människor:
- Kräv kodgranskning.
- Genomdriv grenskydd.
- Kör SAST, beroendeskanning och CI-validering. Skilj på uppgifter där det är möjligt.
- Begränsa vem som får sammanfoga och driftsätta.
- Behandla AI-genererade ändringar som obetrodda tills de är granskade.
OWASP och NIST pekar båda åt samma håll: styrning, förtroendegränser, kontroll över vad som röjs och kontextkänsliga skyddsåtgärder betyder mer än att anta att aktören, människa eller AI, kommer att uppföra sig väl under press. (OWASP Foundation)
AI bör styras som en kapabel men felbar operatör, med kontroller som definieras av åtkomst och inte av antagna avsikter.
Min praktiska rekommendation är enkel. Utgå från att mjuka kontroller kommer att svika. Placera agenten inom den minsta praktiskt genomförbara förtroendegränsen. Håll produktionsåtkomst, värdefulla inloggningsuppgifter och bred intern räckvidd utanför den gränsen. Neka nätverk som standard och öppna det bara som undantag. Behåll samma kompenserande kontroller som du skulle kräva för en kapabel men felbar mänsklig operatör. En person kan göra ett destruktivt misstag när hen är trött, stressad eller förvirrad. En AI-agent kan göra samma misstag snabbare och i större skala. Kontrollfilosofin bör därför vara densamma, bara striktare där autonomi och hastighet ökar påverkan. (OpenAI Developers)
Den mogna hållningen är varken ”AI är unikt farligt” eller ”AI är bara ännu ett verktyg”. AI-kodningsagenter är operatörer med hög varians, inbäddade i befintliga system av förtroende. Det betyder att de förtjänar samma kontroller som vi skulle tillämpa på mäktiga människor, plus ytterligare kontroller mot promptinjektion, läckage och halvautonom körning. Hårda kontroller först. Mjuka kontroller därefter. Allt annat är optimism förklädd till säkerhet. (OWASP Foundation)
Ett sista belysande exempel
Köttsäcken gjorde allt rätt. Fin CLAUDE.md. Fina skills. Fin, säker prompt. Inget vilt – bara: ”städa upp driftsättningsflödet, ta bort föråldrade steg och gör staging och produktion konsekventa”.
Så AI:n gjorde precis det.
Den hittade ett gammalt skript som fortfarande refererades i en pipeline, såg att produktion och staging använde något olika rensningslogik, fann att det var ordningslöst, kopplade om båda till den nyare vägen, tog bort det som såg ut som dubbla artefakter och startade hjälpsamt om jobbet så att ändringen skulle ”slå igenom snyggt”. Mycket prydligt. Mycket rationellt. Och tyvärr var det ”föråldrade” steget den som i det tysta hindrade en destruktiv rensning från att köras mot produktionens lagringssökväg.
AI:n hade ingen öl, ingen trötthet, inget ego, inga dåliga avsikter. Bara läsåtkomst, redigeringsåtkomst, skalåtkomst och maskinens oskyldiga övertygelse att konsekvens alltid är en förbättring.
Det är poängen: köttsäcken var slarvig på mänskligt vis, AI:n var slarvig på maskinvis, och inga mjuka kontroller i världen kunde ändå hindra en artig liten icke-köttsäck från att städa produktion till en brottsplats.
Den här sidan är en fullständig kopia av berättelsen så som den publicerades på Medium. Läs den på Medium. Illustrationer genererade med AI.