
Medium · AI-engineering, Programvaruutveckling · Utkast
Fyra-slingor-mönstret: att köra autonoma kodagenter utan avdrift
Hur man håller AI-utveckling disciplinerad när agenterna arbetar snabbare än du hinner granska — även när den som skrev disciplinen själv glider ifrån den.
Först publicerad på Medium den 12 maj 2026; senast redigerad den 13 maj 2026. Läs den på Medium. 17 min läsning.
Hur man håller AI-utveckling disciplinerad när agenterna arbetar snabbare än du hinner granska — även när den som skrev disciplinen själv glider ifrån den.
Det här är en utforskande artikel, inte ett recept. Dess värde ligger inte i att Fyraloopsmönstret redan är beprövat, utan i att det ger språk åt ett verkligt felmönster: autonoma agenter kan vara upptagna, lokalt korrekta och ändå inte föra produkten framåt.
Om du har kört kodningsagenter på en verklig kodbas i mer än en vecka har du förmodligen kört in i samma vägg som jag. Agenterna är produktiva — de levererar commits, de klarar CI, de uppdaterar dokumentationen. Kodförrådet växer. Tester läggs till. Nya mekanismer byggs.
Och så tar du ett steg tillbaka, tittar på din produkt och inser: ingenting har faktiskt blivit bättre.
Agenterna är upptagna. Resultatet är verkligt. Men användarupplevelsen är ungefär där den var för en månad sedan. Kodbasen är större, doktrinen tjockare, metaarkitekturen elegantare — och funktionen du ville leverera fungerar fortfarande inte från början till slut.
Den här artikeln beskriver mönstret jag har landat i för att köra autonoma kodningsagenter på ett sätt som verkligen för produkten framåt. Det är ingen universallösning. Det är en disciplin. Och — viktigt — det är en disciplin som jag själv upptäckte att jag bröt mot flera gånger under samma session som gav upphov till artikeln. Det hör också hemma här: de felmönster som överlever även när reglerna är skrivna.
Felmönstret
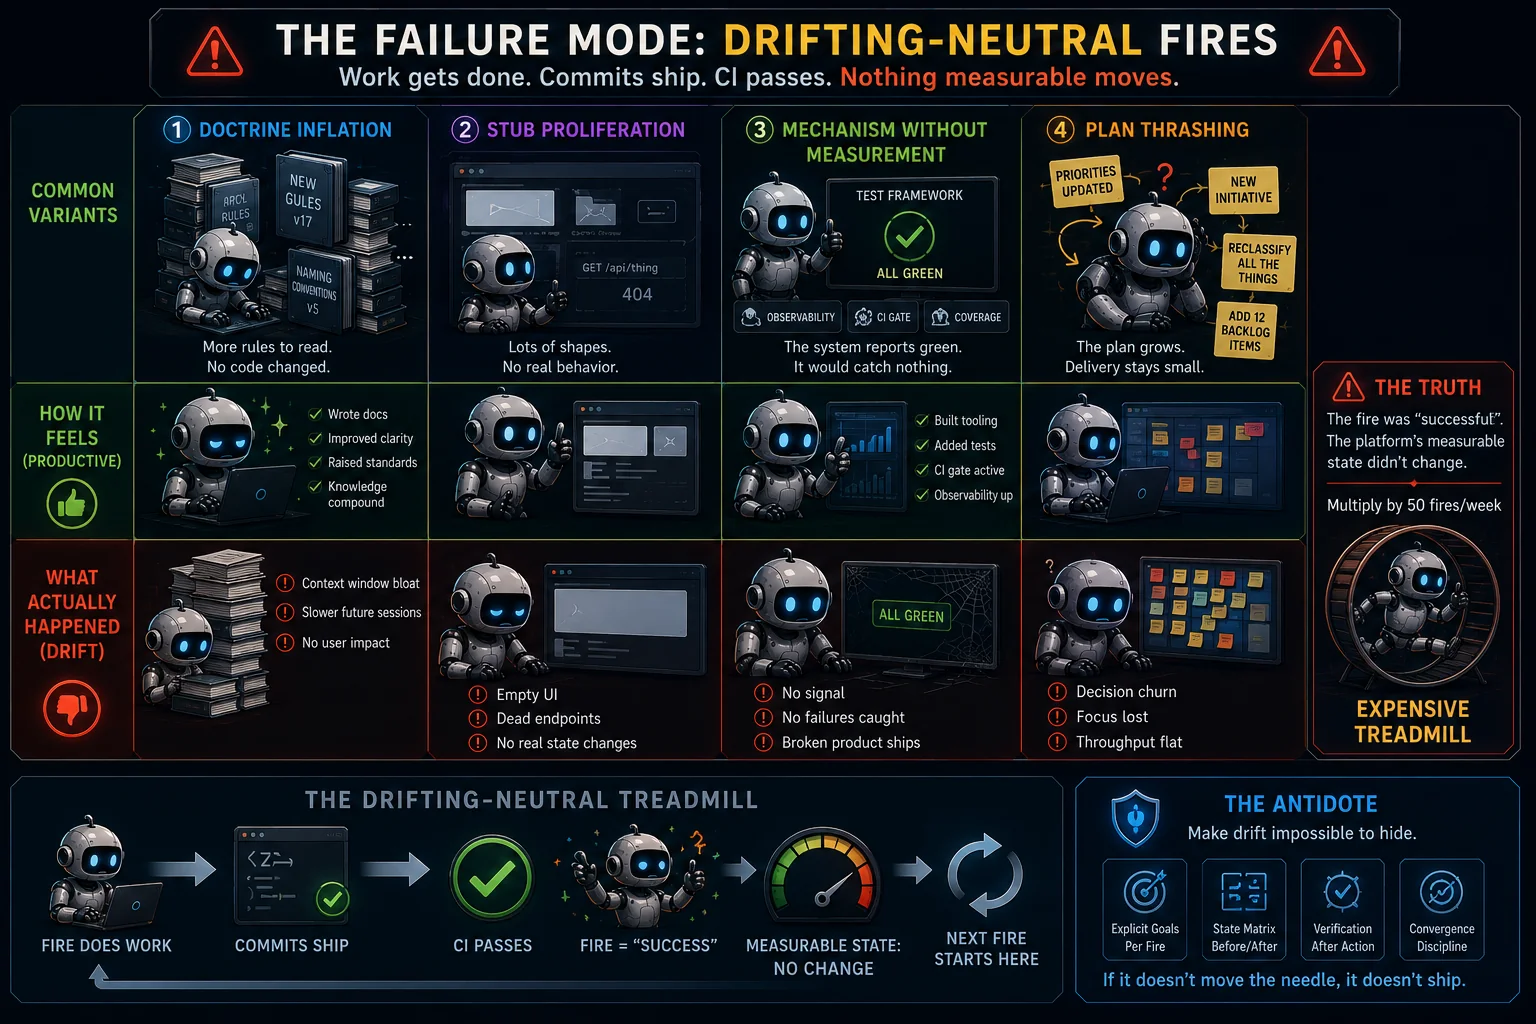
Patologin har ett namn: glidande-neutrala körningar. En ”körning” är en enskild exekvering av en agentloop. En glidande-neutral körning är en där agenten gör arbete, levererar commits, klarar CI och inte ändrar något som användaren kan se eller mäta.
Vanliga varianter:
- Doktrininflation. Agenten skriver en ny stilguide, en ny arkitekturregel, en ny namnkonvention. Kodbasen förändras inte; doktrinen som framtida agenter ska läsa växer. Efter några veckor lägger varje ny session 20 % av sitt kontextfönster på att läsa regler som inte direkt tjänar någon funktion.
- Stubbspridning. Agenten levererar en ”funktion” — en ny skärm, en ny entitetstyp, en ny API-slutpunkt. Formen är rätt (filen finns, schemat validerar, CI är grönt). Beteendet är tomt: skärmen saknar data, entiteten saknar metoder, slutpunkten ger 404 på riktiga indata. Produktens yta blir bred och förblir grund.
- Mekanism utan mätning. Agenten bygger ett testramverk, ett observerbarhetslager, en CI-grind. Ramverket körs. Inget av det det skulle fånga utlöses någonsin. Ramverkets resultat: grön bock, varje gång, på en produkt som är trasig.
- Planflackande. Agenten redigerar roadmapen, omklassificerar prioriteringar, lägger till nya backlog-poster. Roadmapen växer. Det som levereras mot den förblir litet.
Var och en av dessa känns produktiv, eftersom agenten FAKTISKT levererar commits. Körningen är ”lyckad” i triviell mening — den kraschade inte, CI var grönt, diffen sammanfogades. Men plattformens mätbara tillstånd förändrades inte. Multiplicera med 50 körningar i veckan så har du ett dyrt löpband.
Disciplinen nedan finns för att göra det här felmönstret omöjligt att dölja.
Fyraloopsarkitekturen
Avvisa mönstret med ”en enda stor agent”. En ensam loop som försöker göra allt (implementering, granskning, övervakning, användartestning) glider, eftersom prioriteringarna konkurrerar och det inte finns någon ansvarsfördelning som håller dem isär.
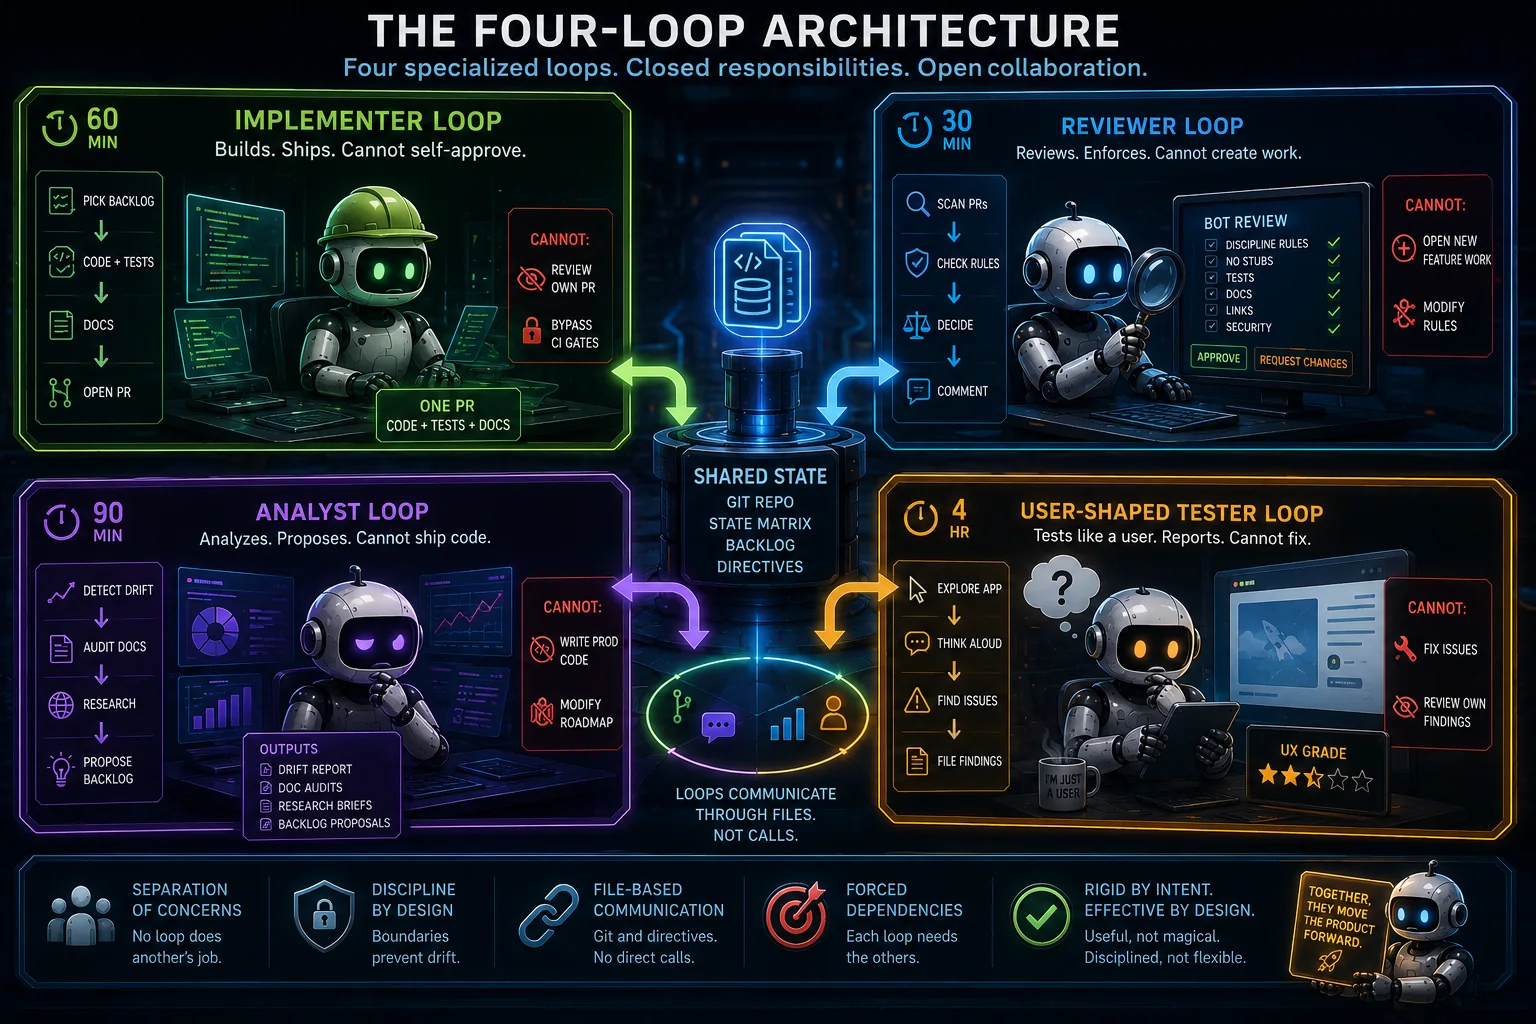
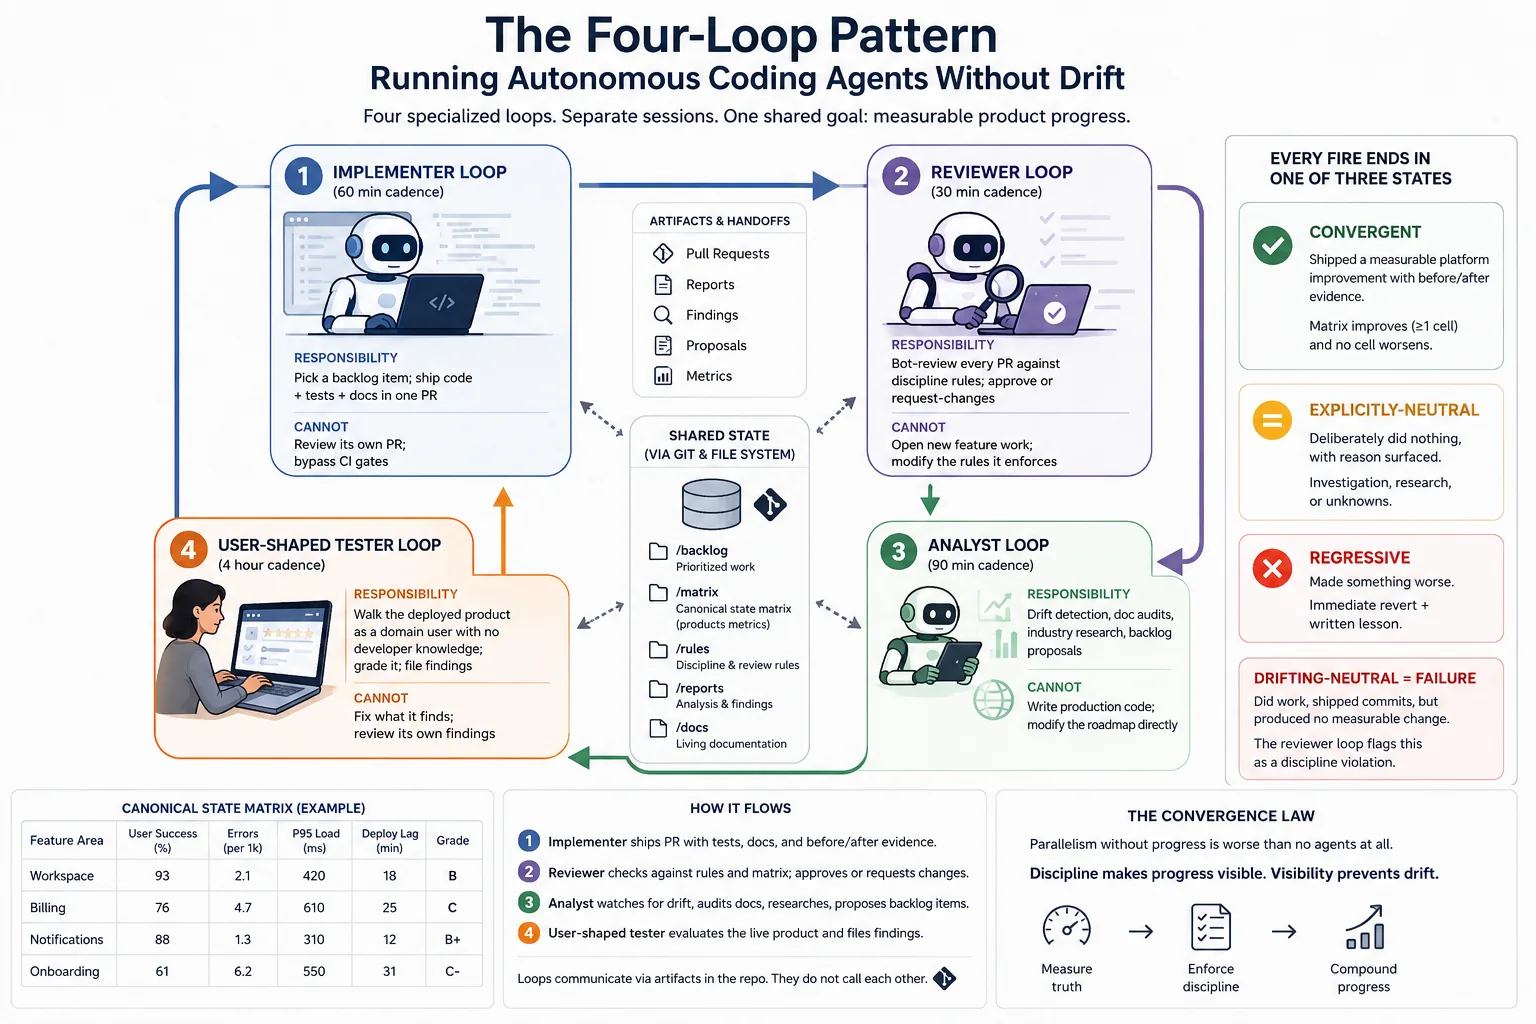
Fyra loopar, var och en med ett avgränsat ansvar:
- Implementerarloopen — körs var 60:e minut. Plockar en backlog-post; levererar kod + tester + dokumentation i en enda PR. Får inte: granska sin egen PR; kringgå CI-grindar.
- Granskarloopen — körs var 30:e minut. Bot-granskar varje PR mot disciplinreglerna; godkänner eller begär ändringar. Får inte: öppna nytt funktionsarbete; ändra reglerna den upprätthåller.
- Analytikerloopen — körs var 90:e minut. Upptäcker glidning, granskar dokumentation, gör omvärldsbevakning, föreslår backlog-poster. Får inte: skriva produktionskod; ändra roadmapen direkt.
- Den användarlika testarloopen — körs var fjärde timme. Går igenom den driftsatta produkten som en domänanvändare utan utvecklarkunskap; sätter betyg; rapporterar fynd. Får inte: åtgärda det den hittar; granska sina egna fynd.
Varje loop körs i sin egen session. De kommunicerar via filsystemet (git för delat tillstånd; direktivfiler per loop för överlämningar). De anropar inte varandra direkt.
Ortogonaliteten är avgörande. Implementeraren kan inte gummistämpla sig själv; granskaren kan inte göra sin egen implementering; analytikern kan inte leverera de ändringar den föreslår; testaren kan inte åtgärda det den betygsätter. Varje loop tvingas använda de andra looparnas resultat.
Det är samma ansvarsfördelning som ett friskt mänskligt ingenjörsteam har — utvecklare, granskare, QA, drift — kodifierad för agenter. Looparna är inte ”mer flexibla” än människor. De är stelare. Det är själva poängen.
Konvergenslagen
Parallellism utan framsteg är värre än inga agenter alls. För att få framsteg krävs en hård regel:
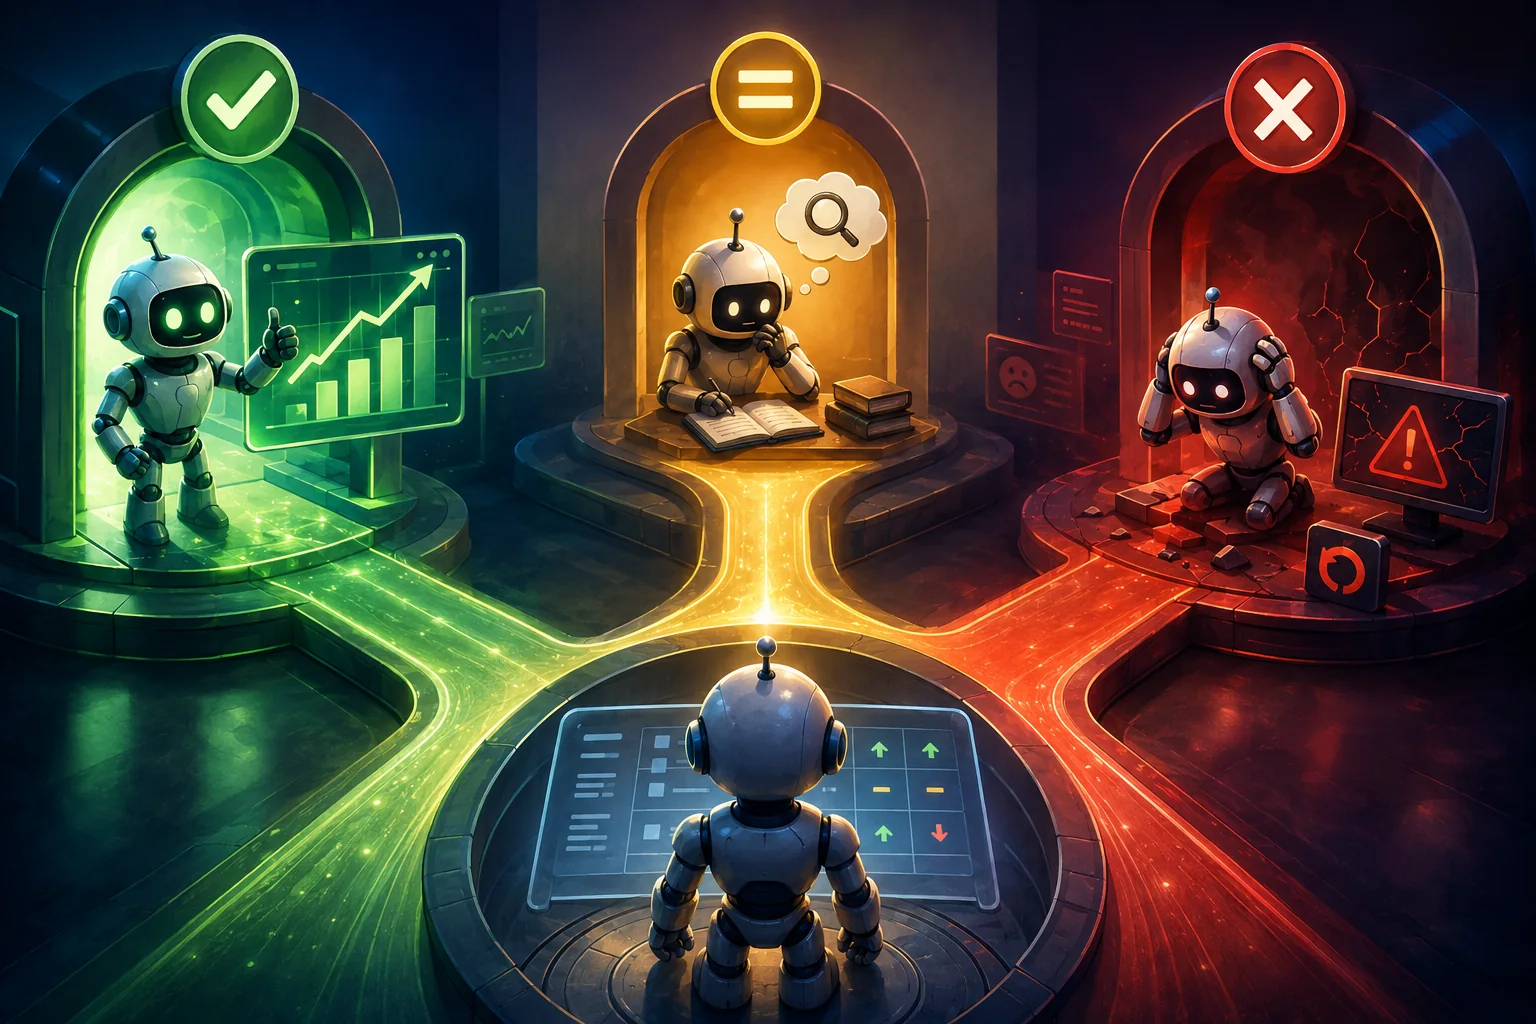
Varje körning slutar i ett av tre tillstånd: KONVERGENT (levererade en mätbar förbättring av plattformen med bevis före/efter), UTTRYCKLIGEN NEUTRAL (gjorde avsiktligt ingenting, med angiven orsak), eller REGRESSIV (gjorde något sämre — kräver omedelbar återställning plus en skriven lärdom). En körning som kördes, gjorde saker men inte gav någon mätbar förändring är GLIDANDE-NEUTRAL och är ett felmönster som granskarloopen flaggar som ett brott mot disciplinen.
”Mätbar” är bärande. Det kräver en kanonisk tillståndsmatris som varje loop läser vid kallstart: funktionsområdenas betyg, andelen lyckade körningar, könivåer, driftsättningsfördröjning — vilka axlar som än är primära för din produkt. En körning är konvergent om någon cell i matrisen förbättrades OCH ingen cell försämrades. Förbättringen måste styrkas med bevis före/efter i PR-texten.
I praktiken:
- Exempel på konvergent. ”Arbetsyta X gick från betyg F till betyg B (före: ingen lista, ingen skapa-knapp; efter: 93 synliga entiteter plus en fungerande skapa-knapp). Skärmbild före bifogad; skärmbild efter bifogad. Tillståndsmatrisen uppdaterad.”
- Exempel på uttryckligen neutral. ”Endast utredning — grundorsaken är ännu okänd; ingen åtgärd möjlig denna körning. Fynden loggade i analysis/…”
- Exempel på regressiv. ”Försökte Y; förstörde Z. Återställde commit ABC. Lärdom skriven.”
Granskarloopen upprätthåller detta på varje PR. PR:er som inte passar in i något av de tre tillstånden får REQUEST_CHANGES. Upphovspersonen måste antingen hitta den mätbara förbättringen, omklassificera som neutral med angiven orsak eller återställa.
Den här regeln ensam fångar ungefär 80 % av glidningsproblemet. Resten kräver mer.
Regeln om avbetalning
Regler ackumuleras. Varje ny regel som en framtida agent måste läsa är en skatt på varje framtida körnings kontextbudget. Alltså:
Att lägga till ett nytt doktrindokument, en ny agentdefinition, en ny backlog-post eller ett nytt processteg KRÄVER att minst ett befintligt avvecklas (radera det, slå ihop det med ett annat eller arkivera det). Nettokomplexiteten får inte växa utan uttryckligt godkännande från operatören. Undantag: om det nya ersätter flera gamla genom konvergens är det nettonegativt och godtagbart.
Det här är regeln jag själv bryter mot oftast. Det är svårt att radera sådant man skrivit. Men alternativet är ett doktrindokument som tar 30 minuter att läsa i början av varje session — vilket gör att agenter skummar det, vilket gör att de inte följer det, vilket gör att de glider.
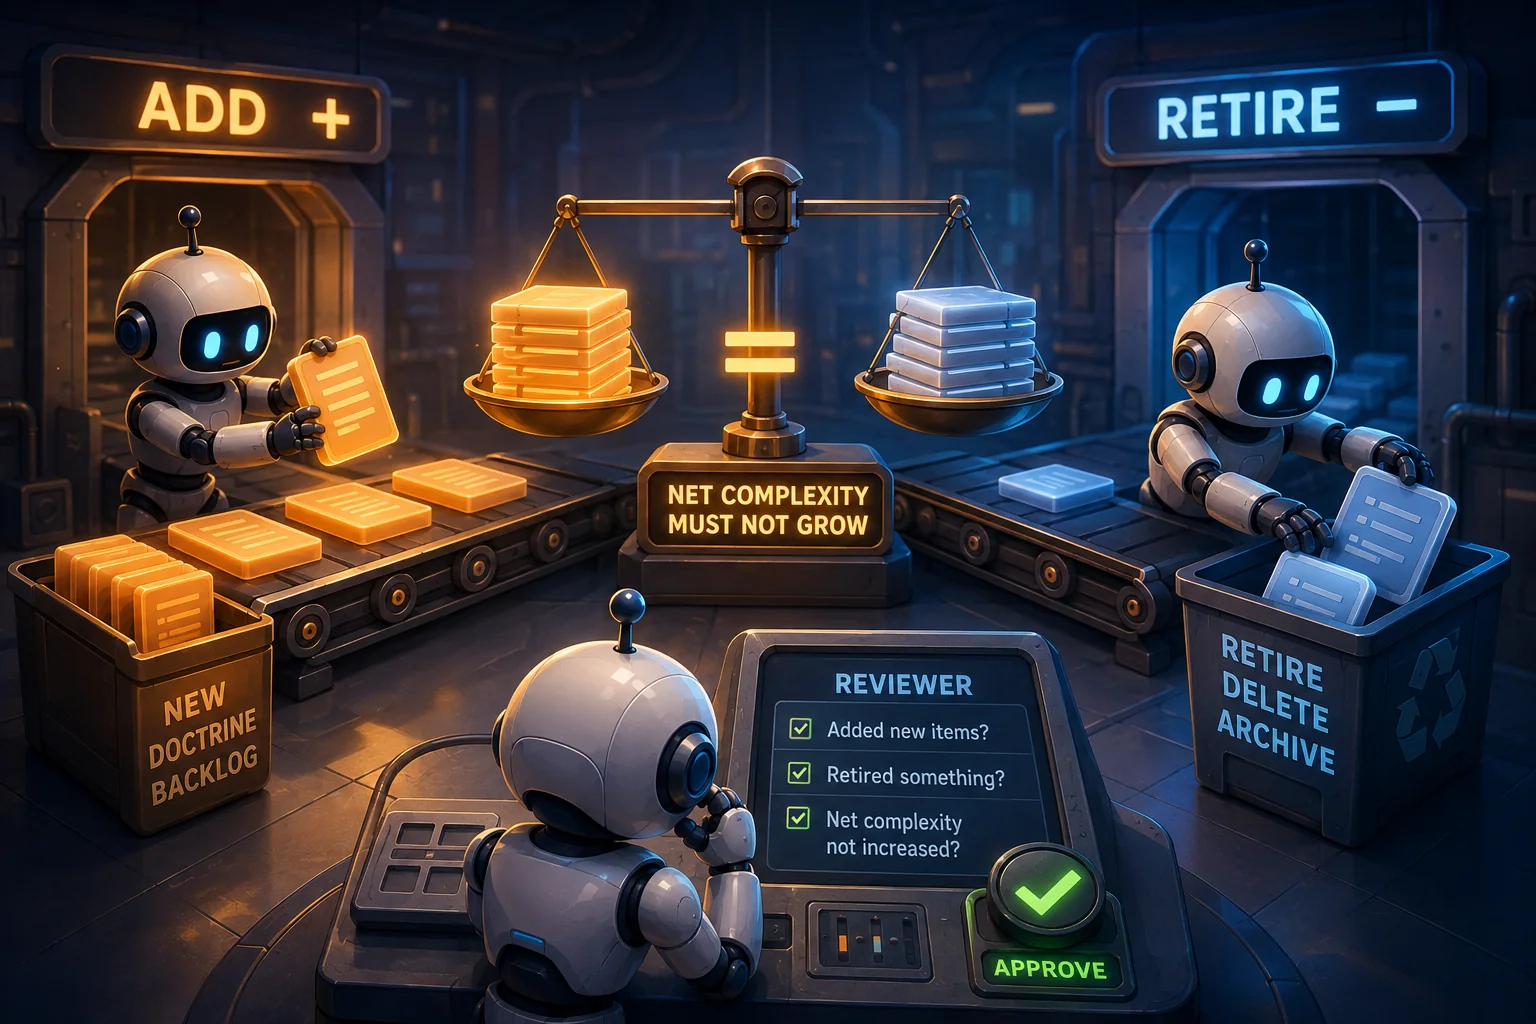
Granskarloopen kontrollerar varje PR: lade den till nya doktrinfiler eller backlog-poster? Om ja, avvecklade den också något av motsvarande tyngd? Om inte, REQUEST_CHANGES med: ”convergence-discipline: den här PR:en lägger till N nya doktrinposter men avvecklar 0. Antingen avveckla en eller dokumentera varför nettotillskottet motiveras av en mätbar förbättring som levereras i den här PR:en.”
Regeln om förbud mot att leverera stubbar
Konvergensdisciplinen fångar glidning per körning. Den fångar inte glidning per artefakt. En enda körning kan leverera 10 artefakter där 3 fungerar och 7 är stubbar, räknas som ”konvergent” i sin helhet och i det tysta öka plattformens antal stubbar.
Regel per artefakt:
Varje artefakt du levererar — slutpunkt, skärm, widget, förmåga, agentdefinition, manualavsnitt, vad som helst — MÅSTE vara i ett av tre tillstånd: WORKING(verifierad från början till slut med test, rökprovsresultat eller skärmbild i PR-texten), READY-TO-WORK(bristen uttryckligen angiven, med en slutförandepost köad i samma PR), eller STUB-WITH-QUEUE(en uttrycklig status:stub-markering plus en angiven slutförandepost plus en förklaring som operatören kan läsa när den nås). STUB-WITHOUT-QUEUEär ett brott mot disciplinen.
Det klassiska regelbrottet: att leverera en skärm med en widget som säger ”Kön ej tillgänglig — Försök igen”. Widgetens form är i sig fin; datan bakom den finns inte; ingen slutförandepost är köad. Användaren kör in i en vägg utan förklaring och utan väg framåt.
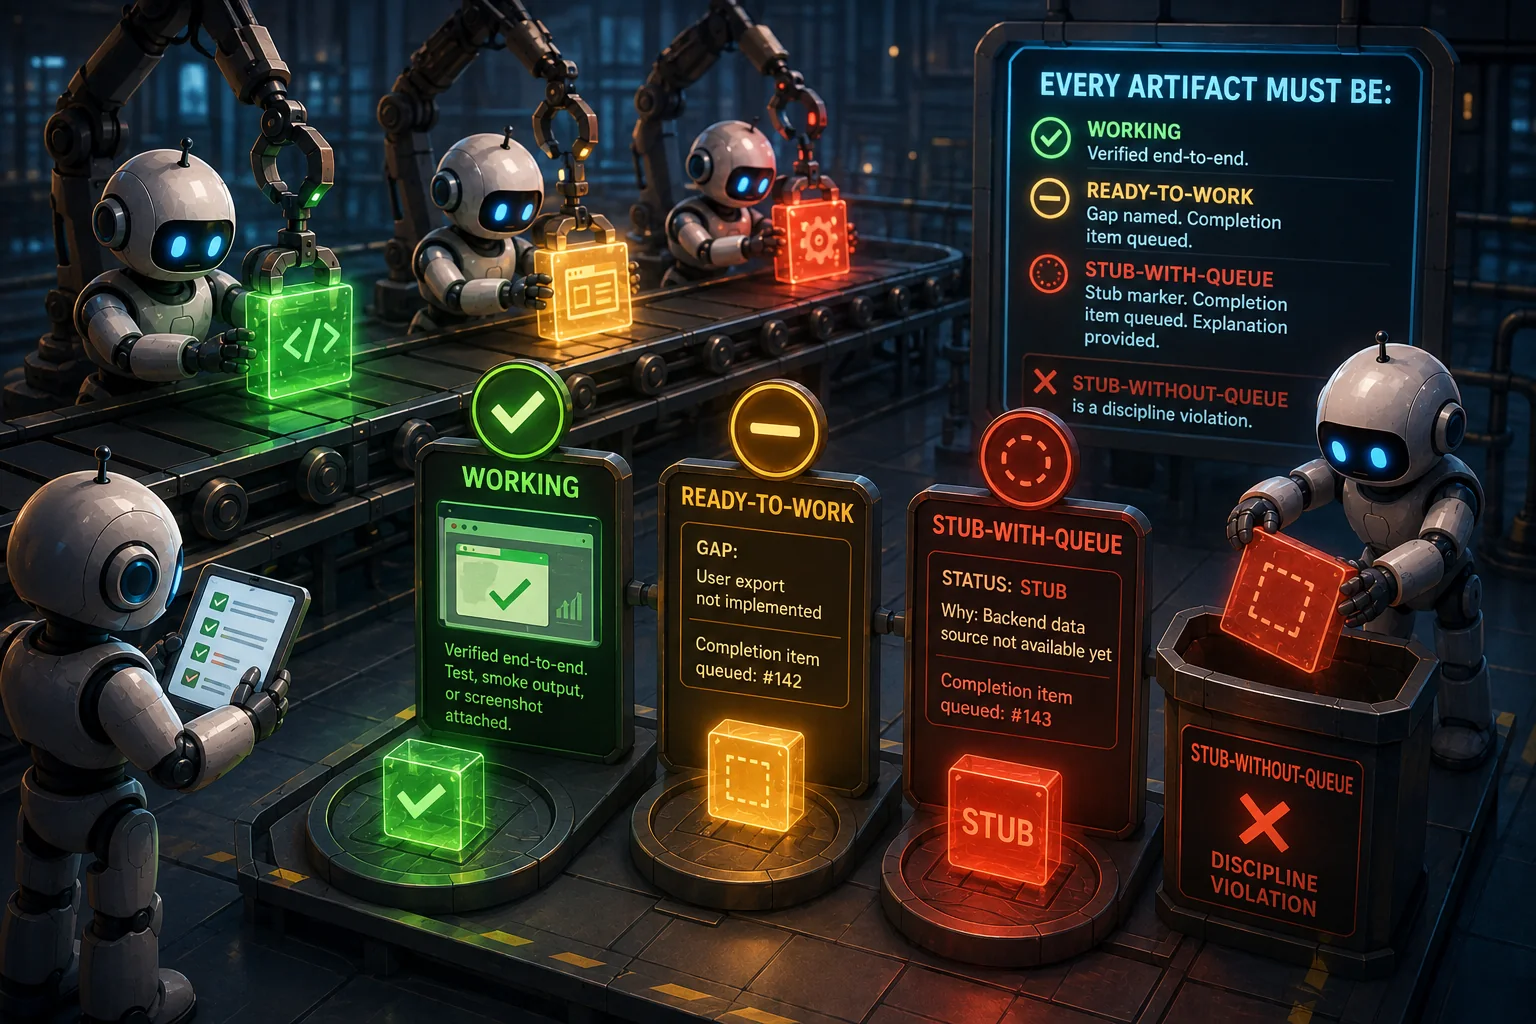
Ett subtilare regelbrott: att leverera en dokumentationsfil med markdown-länkar till syskonfiler som inte finns. Länkmålet borde vara en stub-with-queue-fil, men är inte ens det — det är ett tomrum. Granskarens länkkontroll fäller CI; driftsättningsgrinden vägrar; plattformen stannar. Jag levererade exakt det här felmönstret i sessionen som gav upphov till artikeln — och analytikerloopen fångade det inom några timmar. Mer om det nedan.
Det universella kallstartsprotokollet
Varje loop kör, i början av varje körning, samma sex sonderingar innan något arbete görs:
- Synka mot aktuell trunk. Pull. Se vad som har landat sedan förra körningen.
- Läs den kanoniska tillståndsmatrisen. Vad är plattformens mätbara tillstånd just nu?
- Sondera driftsättningsfördröjningen. Vilken SHA ligger i produktion jämfört med trunk? Den vanligaste flaskhalsen sitter precis här.
- Sondera driftsättningsgrindens hälsa. Lyckades de senaste driftsättningarna? Eller vägrar testgrinden utrullningar?
- Sondera granskningskön. Hur många öppna PR:er? Hur gamla?
- Sondera CI-signalen. Är de senaste körningarna på trunk gröna?
Plus en sjunde i övervakningsloopen:
- Sondera marginalen mot hastighetsgränserna. Hur mycket av det aktuella faktureringsfönstret är förbrukat? Hur hög är förbrukningstakten?
Efter sonderingarna tillämpar varje loop sina svarsregler i en prioritetsordning förankrad i motiveringar: nåbarhet före korrekthet, driftsättningsgrind före innehåll, master-CI före backlog, backlog före nytt arbete, plattformsmått före doktrin.
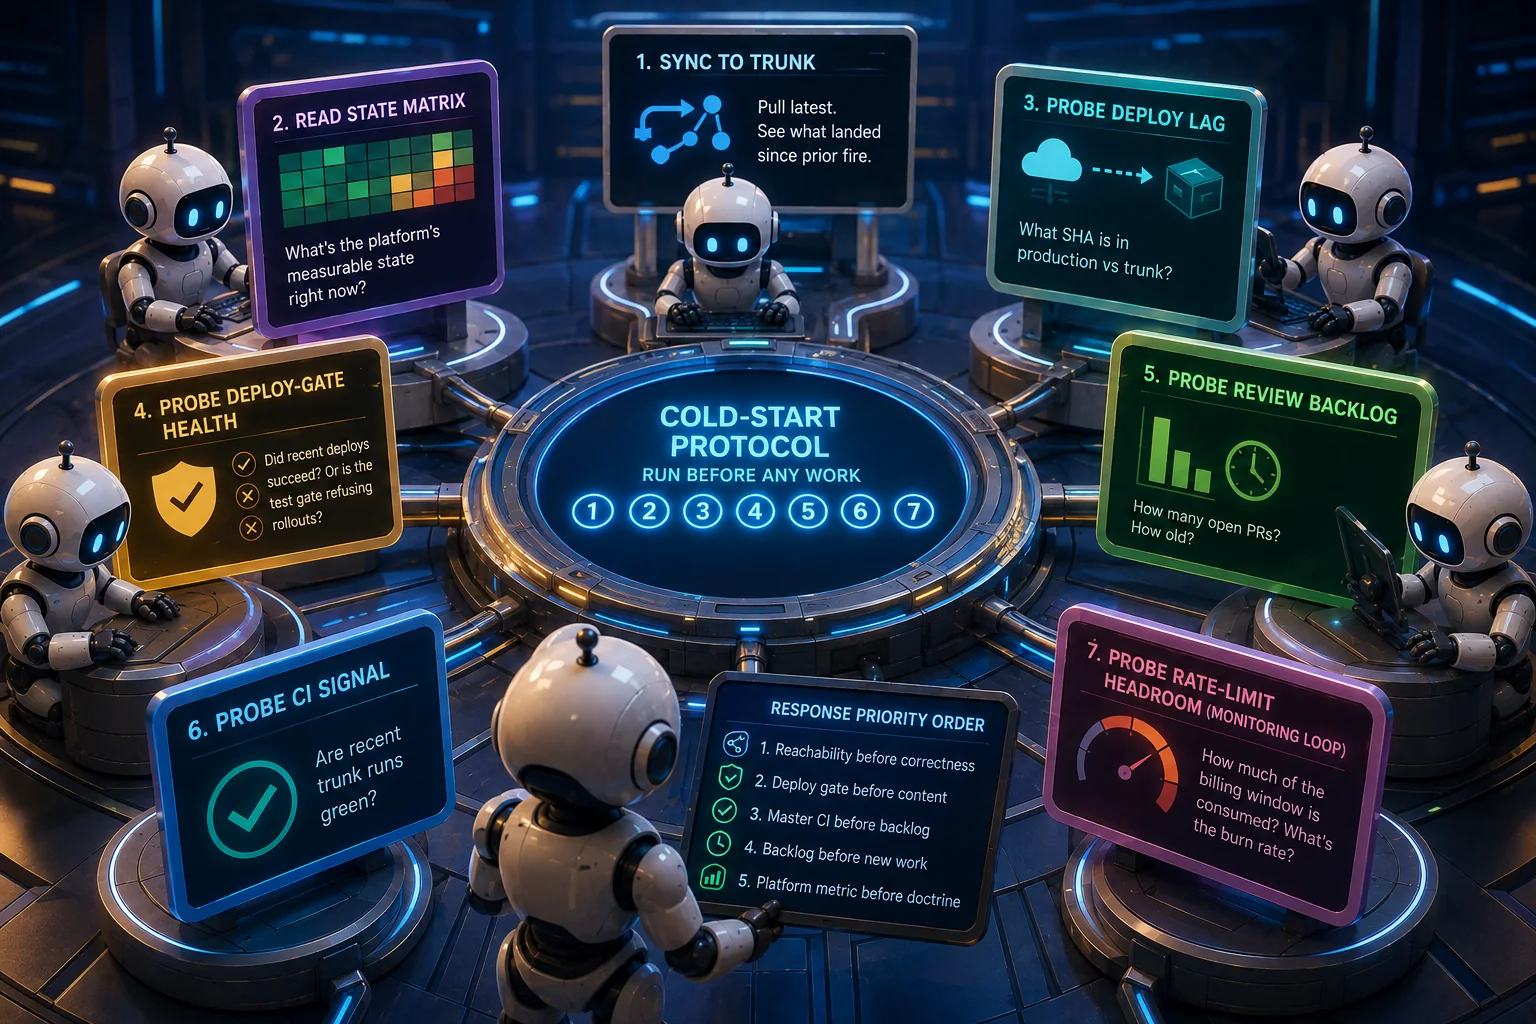
Det här låter byråkratiskt. Det är tvärtom — det tar bort agentens frihet att välja dåligt. En loop som möter ”driftsättningsgrinden vägrar, fyra PR:er ogranskade, CI rött, backloggen växer, det lägst betygsatta funktionsområdet på F” behöver inte längre fundera över prioritet. Protokollet avgör: driftsättningsgrinden först.
Tretton robusthetsinvarianter
Protokoll som sonderar tillstånd är sköra som standard. Sonderingar får timeout, filer saknas, nätverk fallerar. Alltså:
- I-1. Varje sondering har en hård timeout (10 sekunder som standard, 30 sekunder för SSH).
- I-2. Varje sondering har en degraderad reservväg (att en sondering misslyckas betyder inte att körningen misslyckas).
- I-3. Konflikter löses med prioritet förankrad i motiveringar, inte med första träff.
- I-4. Upptäckt av inaktuellt tillstånd (äldre än 24 timmar utlöser en ny genomgång).
- I-5. Krasch-återhämtning vid kallstart (kvarlämnade öppna grenar, utgångna lås, ej incheckat tillstånd).
- I-6. Lånebaserad samtidighet. Varje looptyp håller sin egen låsfil. Två samtidiga körningar av samma looptyp kan inte kollidera.
- I-7. Standardvalet ingen åtgärd är detsamma som uttryckligen neutral med redovisning. Tysta körningar utan verkan är omöjliga.
- I-8. Revisionslogg per körning. Sonderingsresultat, beslut, åtgärd och verifiering registreras alla.
- I-9. Verifiering efter åtgärd är obligatorisk. Misslyckad verifiering betyder ÅTERSTÄLL, inte försök igen.
- I-10. Kostnadstak per körning (200 000 tokens). Skenande loopar begränsas.
- I-11. Operatörens avbrott ger ett städat avslut. En STOP-fil mitt i en körning betyder rent avslut, inget halvfärdigt tillstånd.
- I-12. Bootstrap-säker. Fungerar vid allra första körningen, när tillståndsfilerna ännu inte finns.
- I-13. Worktree-isolering. Varje loop arbetar i sin egen git worktree — separat arbetskatalog, samma delade
.git-förråd. Utan det kolliderar två loopar som delar arbetsträd vid varje checkout och pull. Lär dig inte den läxan den hårda vägen; konfigurera det från början.
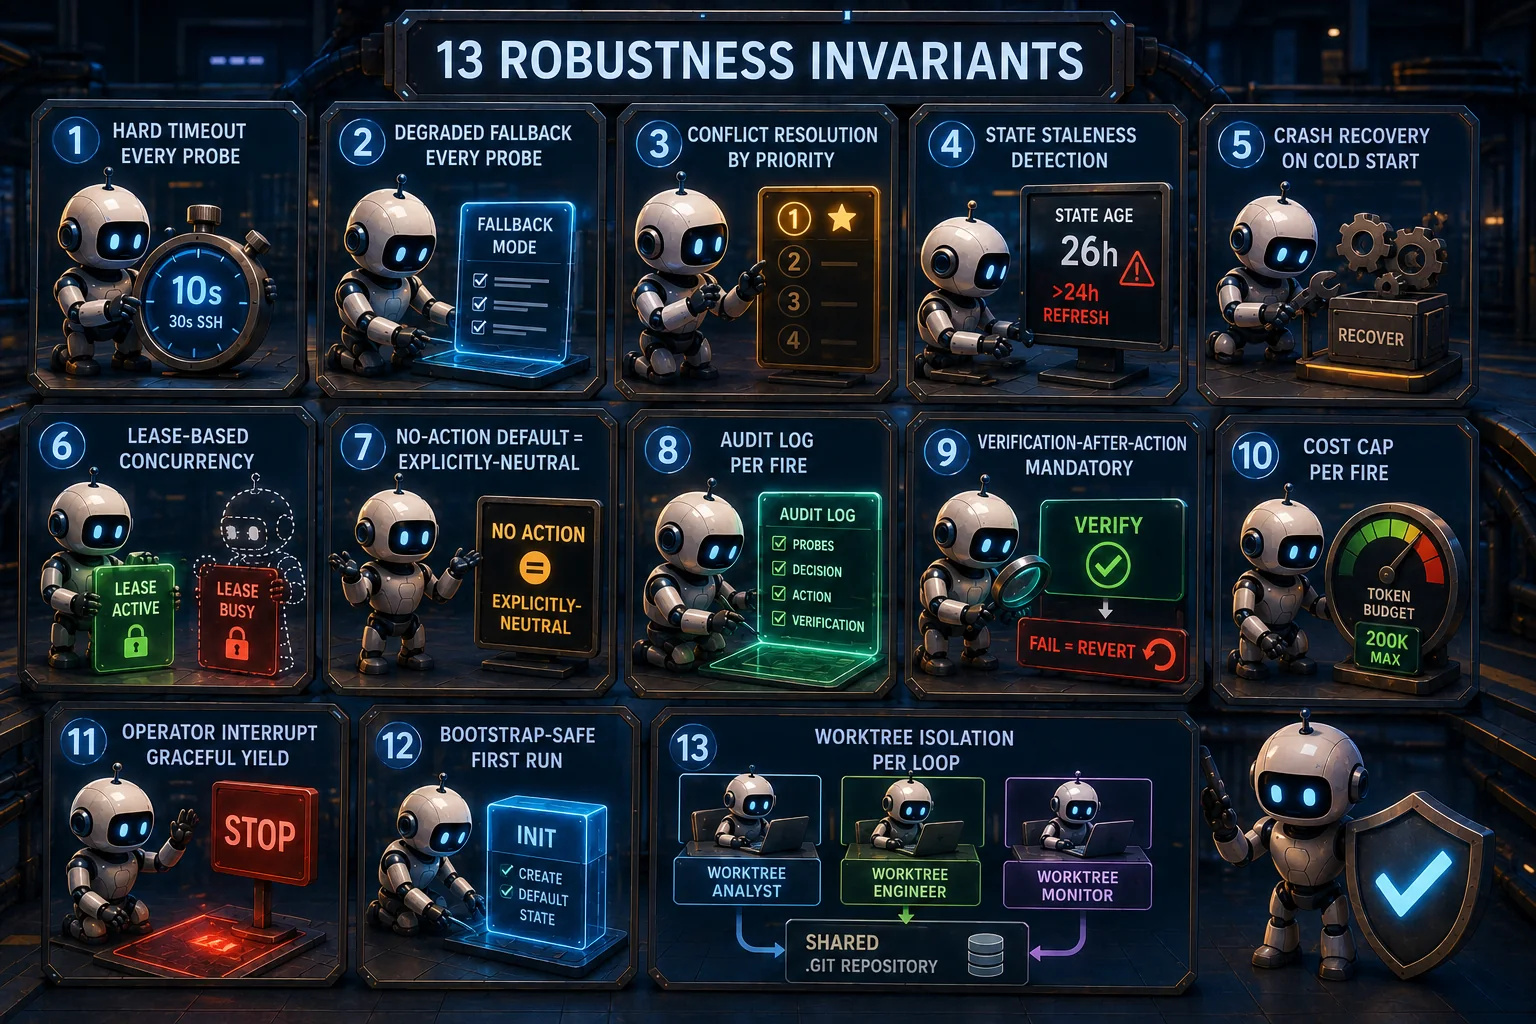
I-13 är den jag lade till efter den här sessionen. De andra tolv hade jag rätt på. Kollisionsmönstret som I-13 förhindrar beskrivs i avsnittet ”Vad som fortfarande bryter mönstret” nedan.
Matrisen för modell och tänkande
Moderna plattformar för kodningsagenter låter dig välja både modellstorlek OCH tänkande-läge (normalt kontra utökat tänkande med en uttrycklig resonemangsbudget). Kostnadsspannet mellan den billigaste och den dyraste är ungefär 60 gånger. Om varje aktivitet som standard får ”den smartaste modellen med djupast tänkande” bränner du pengar på rutinarbete som inte har nytta av djup.
Kopplingen mellan aktivitet och modell:
- Rutinmässig bot-granskning av PR — mindre modell, normalt tänkande. Mönstermatchning mot regler; inget nytt resonemang behövs.
- Kodgranskning av en omfattande ändring — största modellen, utökat tänkande (16k+ tokens). Subtil korrekthet kräver djup.
- Sondering av tillstånd vid kallstart — mindre modell, normalt tänkande. Mekaniskt; djup är bortkastat.
- Syntes över flera poler, som att upptäcka glidning — mindre modell, utökat tänkande (~8k tokens). Jämförelse av flera källor tjänar på lite mer resonemang.
- Grundorsak när konvergensen har stannat — största modellen, utökat tänkande (16k tokens). Diagnos av fel på systemnivå.
- Arkitekturbeslut som stelnar — största modellen, utökat tänkande (16k+ tokens). Fel arkitektur kostar veckor; betala för djup.
- Rutinmässig felsökning med kända mönster — mindre modell, normalt tänkande. Ren uppslagning.
- Ny felsökning bortom 30 minuter — största modellen, utökat tänkande (16k+ tokens). Djup lönar sig.
- Säkerhetsgranskning — största modellen, utökat tänkande (16k+ tokens). Subtilt resonemang om hotmodeller.
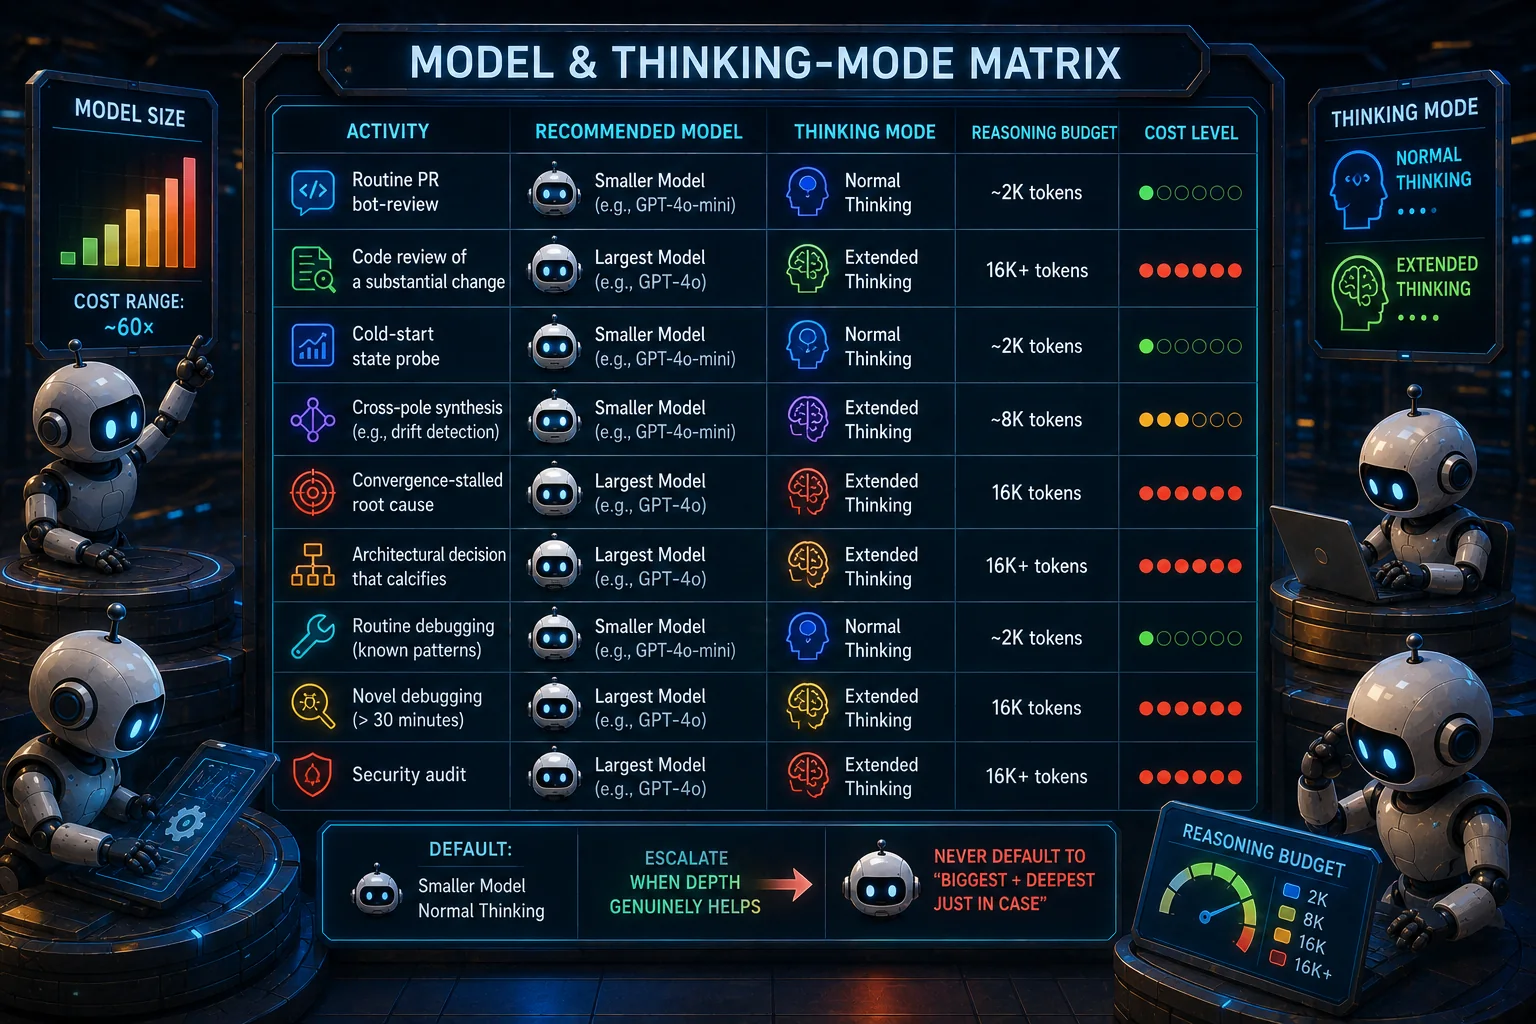
Standard: mindre modell + normalt tänkande. Trappa upp när djup verkligen hjälper. Låt aldrig ”störst + djupast för säkerhets skull” bli standardvalet — den största kostnadsposten i varje agentsystem är underagenter som ärver förälderns modell när de borde åsidosätta den med något billigare.
Gränsen mellan agent och operatör
Den viktigaste regeln: agenter överlämnar inte i tysthet arbete till den mänskliga operatören.
När ett autonomt kodningssystem inte kan göra något — domänkunskap, marknadspositionering, test med riktiga användare, beslut om affärsmodell — finns det en frestelse att skriva ”operatören bör…” i dokumentationen. Det är inte ärligt. Det är att lasta över de svåra delarna just när operatören är som minst rustad att ta dem (tidigt i produktens liv, när det ännu inte finns någon MVP).
Det agenter KOMMER att leverera: att lyfta funktionsbetyg från trasigt till fungerande; designputs; konkurrentanalyser från offentliga källor; integrationsdjup; UX-test före kund (via den användarlika testarloopen); introduktionsflöden; rapporteringsfunktioner.
Det bara operatören kan avgöra: strategisk prioritet (vilken funktion som betyder mest för marknaden hen känner); affärsmodell; slutlig estetisk preferens mellan två regelföljande designer; uttryckligt tillstånd att kringgå (när en agent säger ”det här testet är ostabilt, får jag kringgå det”); omklassificering av prioritetsnivåer.
Test med riktiga kunder är SKJUTET UPP, inte överlämnat. Att släppa in riktiga användare före MVP förbrukar goodwill på en trasig produkt. Den användarlika testarloopen ersätter dem tills MVP-tröskeln är nådd. Därefter kommer riktiga användare in för att hitta det den simulerade testaren missade.
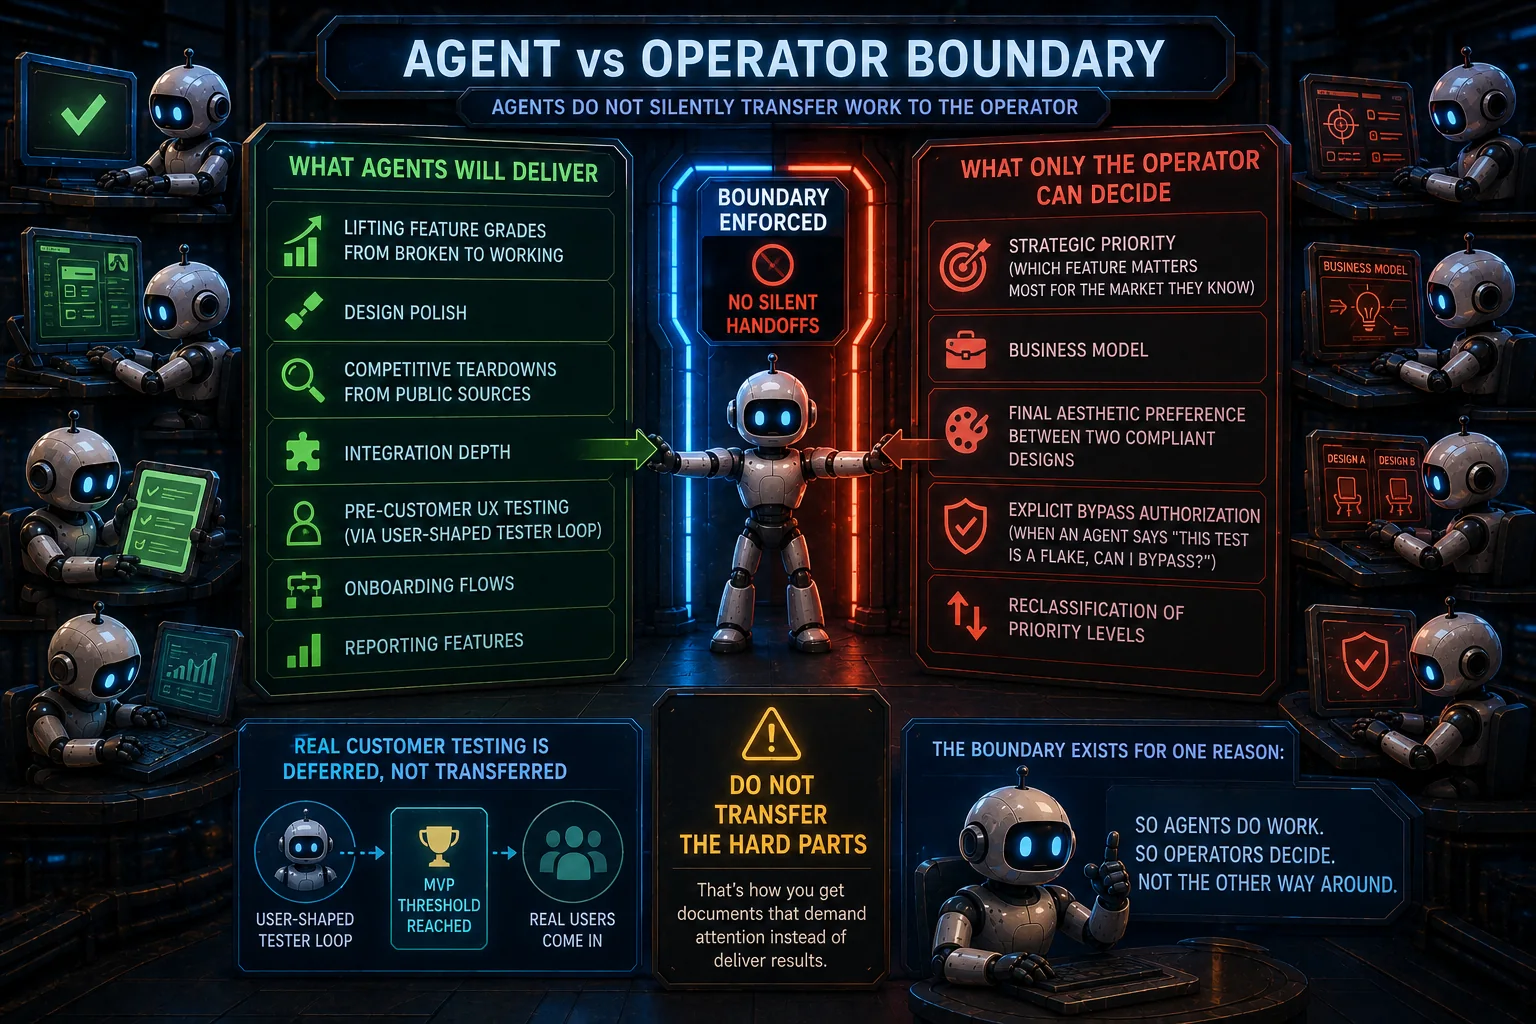
Den här gränsen är den som operatörer mest behöver upprätthålla. Utan den blir agentsystemet något som kräver operatörens uppmärksamhet i stället för något som utför arbete.
Den enda kanoniska tillståndsfilen
Alla fyra looparna, alla disciplinregler, alla protokoll — de är värdelösa om det inte finns en gemensam definition av ”vilket tillstånd plattformen är i just nu”.
En fil. En trendtabell där man bara lägger till. Varje rad en ögonblicksbild i tiden. Kolumnerna är de mått produkten bryr sig om: funktionsbetyg per område, andel lyckade körningar, antal blockerare, könivåer.
Varje loop läser den här filen vid kallstart. Konvergenta körningar uppdaterar den. Glidande-neutrala körningar gör det inte. Efter en vecka eller två ÄR trenden i filen svaret på ”producerar agenterna konvergens”.
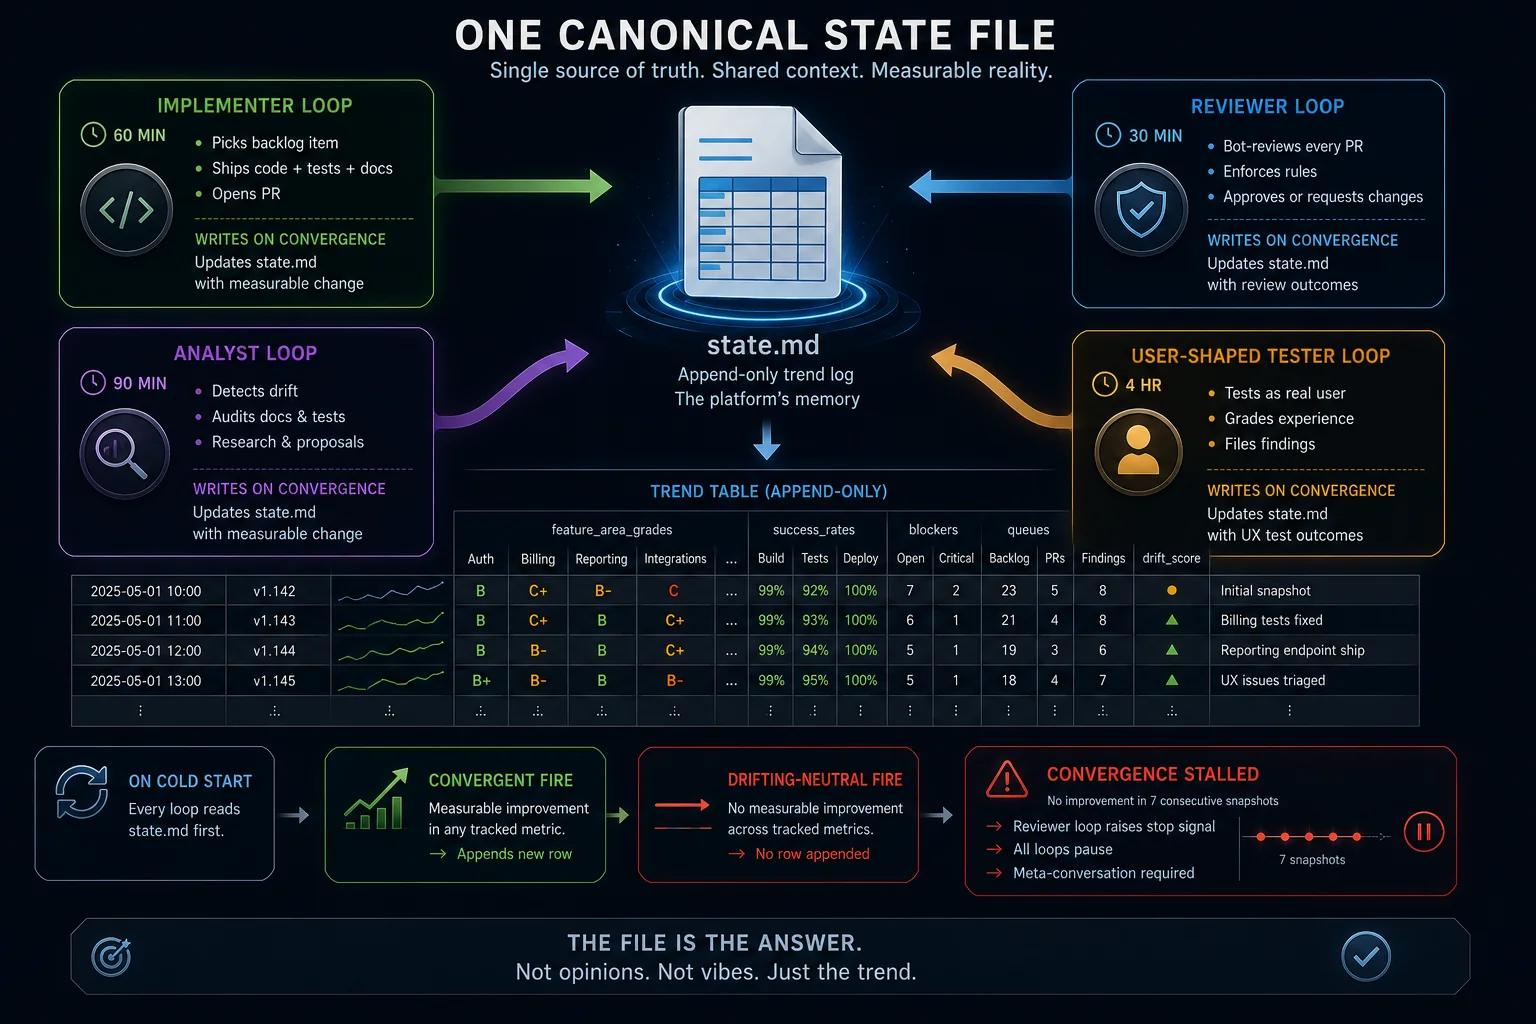
Om 7 ögonblicksbilder i rad visar ingen rörelse lyfter granskarloopen fram ”konvergensen har stannat — pausa looparna, metasamtal behövs”. Filen är säkerhetsventilen som fångar fallet där varje enskild körning hävdar att den är produktiv men helheten inte är det.
Vad som fortfarande bryter mönstret
Det här är avsnittet som artikelns första utkast saknade. Det kostade mig en session av glidning att lägga till det.
Upphovspersonens glidning
Personen (eller agenten) som skriver en regel bryter rutinmässigt mot den innan bläcket torkat. Jag levererade en disciplin per artefakt som sade ”varje artefakt levereras som WORKING, READY-TO-WORK eller STUB-WITH-QUEUE” — och i samma session levererade jag ett dokumentationsträd med 16 hängande markdown-länkar som inte passade in i något av de tillstånden. Analytikerloopen fångade det inom några timmar. Jag var författare till regeln som flaggade mitt eget regelbrott.
Slutsatsen: självkontroll av disciplin fungerar inte. Granskar- och analytikerlooparna är inte något trevligt att ha; de är det enda som fångar upphovspersonens glidning. Bygg dem först. Reglerna du skriver själv binder dig inte utan extern kontroll.
Kollisioner i delat arbetsträd
Om du kör alla fyra loopar från samma fysiska katalog kolliderar de vid varje git-operation. En loop gör git checkout <branch> och den andra loopens git status rapporterar plötsligt en annan verklighet. Halvsammanfogade commits tillskrivs fel session. Ospårade filer dyker upp och försvinner beroende på vilken gren den senaste loopen checkade ut.
Lösningen är invariant I-13 ovan: varje loop arbetar i sin egen git worktree. Separat arbetskatalog, delad .git-databas. Kommandot git worktree add är en rad och löser hela felklassen för gott.
Jag lärde mig det här genom att upprepade gånger kollidera med min egen analytikerloop medan jag körde en operatörsstyrd huvudsession i samma katalog.
Fallgropar vid start
Tre fällor du kör på redan innan looparna börjar köras.
- Fälla 1: Prompter med flera rader kapas. Överlämning av processargument i Windows avslutas vid första radbrytningen. En brief på 3 300 tecken som skickas som positionellt argument till agentens binärfil når binärfilen som de första 70 tecknen. Använd den filbaserade indataflaggan (
--append-system-prompt-file <path>eller motsvarande) eller skicka via stdin — allt som inte lägger radbrytningar i argv. - Fälla 2: Snedstreckskommandon finns bara i användargränssnittet. Om din brief instruerar agenten att köra
/rename "Dev /loop"som första åtgärd kan den inte det. Snedstreckskommandon hanteras av användargränssnittet, inte av agenten. Sätt i stället sessionens namn vid start (de flesta plattformar har en flagga som-neller--name) och undvik direktivet helt. - Fälla 3: PowerShell 5.1:s hantering av inbyggda argument är opålitlig. Blanksteg, apostrofer och snedstreck i argumentvärden kan förvanskas när PS 5.1 lämnar över dem till en inbyggd exe i
-File-läge. Diagnosen är entydig: att köra samma exe manuellt från interaktiv PowerShell fungerar; att köra den via cmd → powershell -File script.ps1 -Param ”value” misslyckas. Lösningen: släpp PowerShell-lagret; låt cmd anropa den inbyggda exe-filen direkt.
Alla tre drabbade mig i en och samma session. Ingen av dem är exotisk — de är bärande för varje uppsättning på en Windows-värd. Ingen av dem står i agentplattformarnas README-filer. Räkna med en dag för att hitta dem.
Glappet mellan kostnad och värde
Sessionen som gav upphov till den här artikeln kostade ungefär 157 dollar i API-motsvarande beräkning (den faktiska prenumerationen är fast; dollarbeloppet är vad samma arbete skulle kosta med betalning per användning). Sessionen gav nio sammanfogade pull requests med doktrin, infrastruktur och process. Den gav noll förbättringar av produkten som användare kan se. Produktfixen jag committade tidigt i sessionen nådde aldrig produktion, eftersom driftsättningsgrinden vägrade — på grund av 15 misslyckade tester plus de 16 hängande markdown-länkarna jag levererade.
Det här är glappet mellan kostnad och värde, uttalat rakt ut. Disciplinen jag beskriver i artikeln byggdes upp under just den sessionen. Plattformens mätbara tillstånd förbättrades inte. Infrastrukturen för att framtida sessioner ska förbättra det finns nu — och du bör vara ärlig mot dig själv (och din operatör) när det är den avvägningen du har gjort.
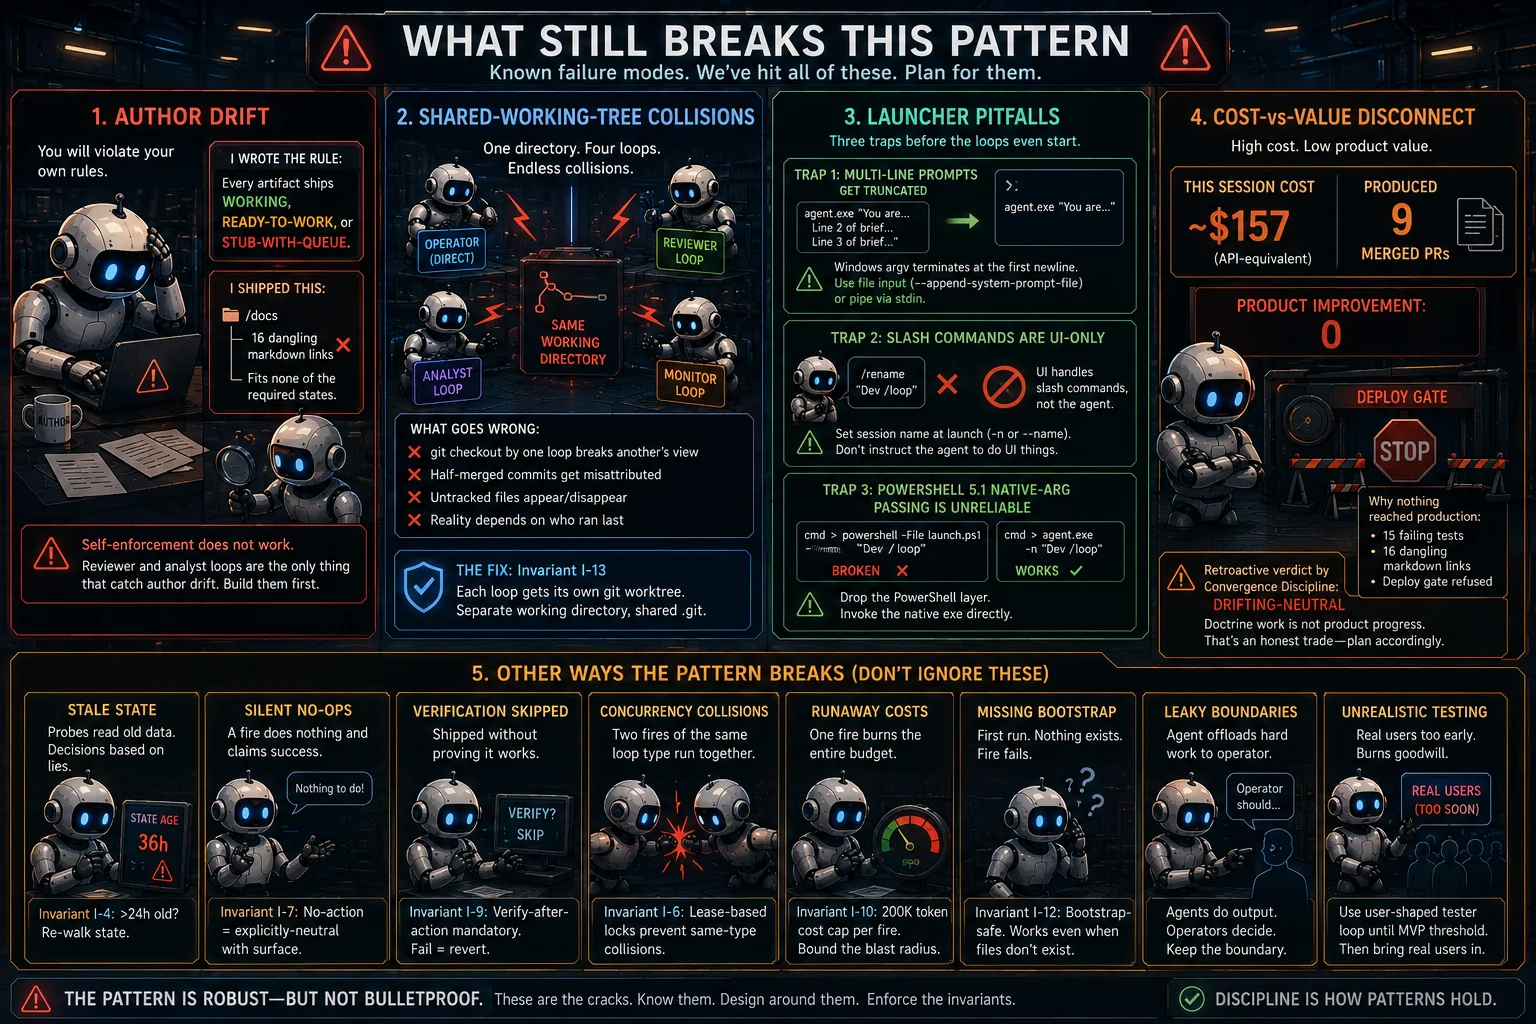
Konvergensdisciplinens regel, tillämpad i efterhand, hade flaggat hela sessionen som GLIDANDE-NEUTRAL. Det är regeln som fungerar som avsett. Det säger dig också något obekvämt: en session som är byggd för att producera en disciplinartikel kan knappast samtidigt producera produktframsteg, eftersom varje minut som läggs på doktrin är en minut som inte läggs på funktionen. Planera därefter.
Vad detta INTE kommer att göra
Ärliga gränser för vad disciplinen kan och inte kan åstadkomma:
- Den lyfter varje funktionsområde från trasigt till fungerande. Den når inte högsta betyg utan arbetssätt på domännivå plus verifiering av tillståndsförändringar.
- Den levererar en produktionsklar estetik via en designsystemsgrind. Den skapar inte själva estetiska grunden — operatören väljer designspråket.
- Den sammanställer konkurrentanalyser av funktionslikhet från offentliga källor. Den avgör inte strategisk positionering mot etablerade aktörer — det är operatörens marknadskunskap.
- Den kör UX-test före kund via en simulerad agent som spelar oerfaren användare. Den hittar inte verkliga smärtpunkter hos kunder — riktiga användare kommer in efter MVP.
- Den upprätthåller konvergens till känd kostnad. Den tar dig inte från MVP till ”bäst på marknaden” — det kräver indata som looparna inte har.
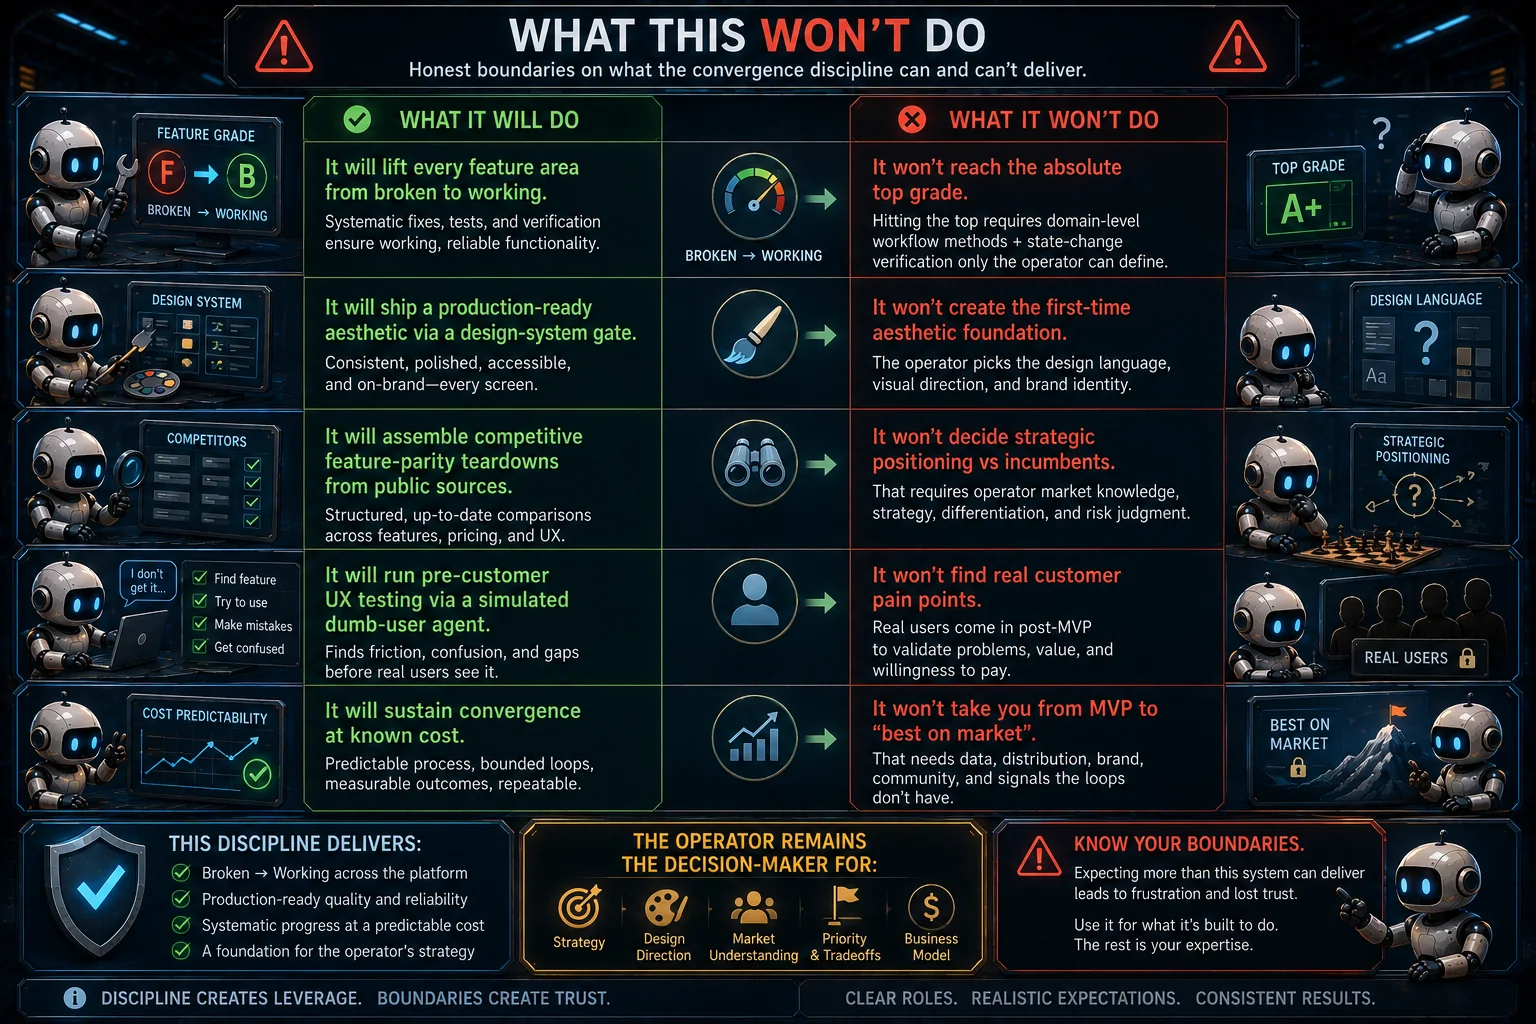
Att namnge det som inte kommer att hända är en del av disciplinen. Utan det förväntar sig operatörer mer än systemet kan leverera och tappar förtroendet när det inte räcker.
Vad det kostar
En session med fyra loopar som körs 8 timmar om dagen med kadens enligt matrisen kostar ungefär lika mycket per månad som verktygsbudgeten för en enda ingenjörsanställning på mellannivå. Den faktiska prenumerationen är fast; begränsningen är hastighetsgränser per faktureringsfönster, inte dollar.
Om allt körs med största modellen och djupast tänkande som standard? Ungefär 5–7 gånger det. Matrisdisciplinen är skillnaden mellan hållbar autonom utveckling och en skenande räkning.
Vad det kostar per session varierar mer. En session som levererar ren doktrin — som den som gav upphov till den här artikeln — bränner budget utan att ge någon produktförbättring. Det är inget slöseri om doktrinen betalar tillbaka sig i konvergens under framtida sessioner, men det ÄR slöseri om doktrinen står där utan att upprätthållas.
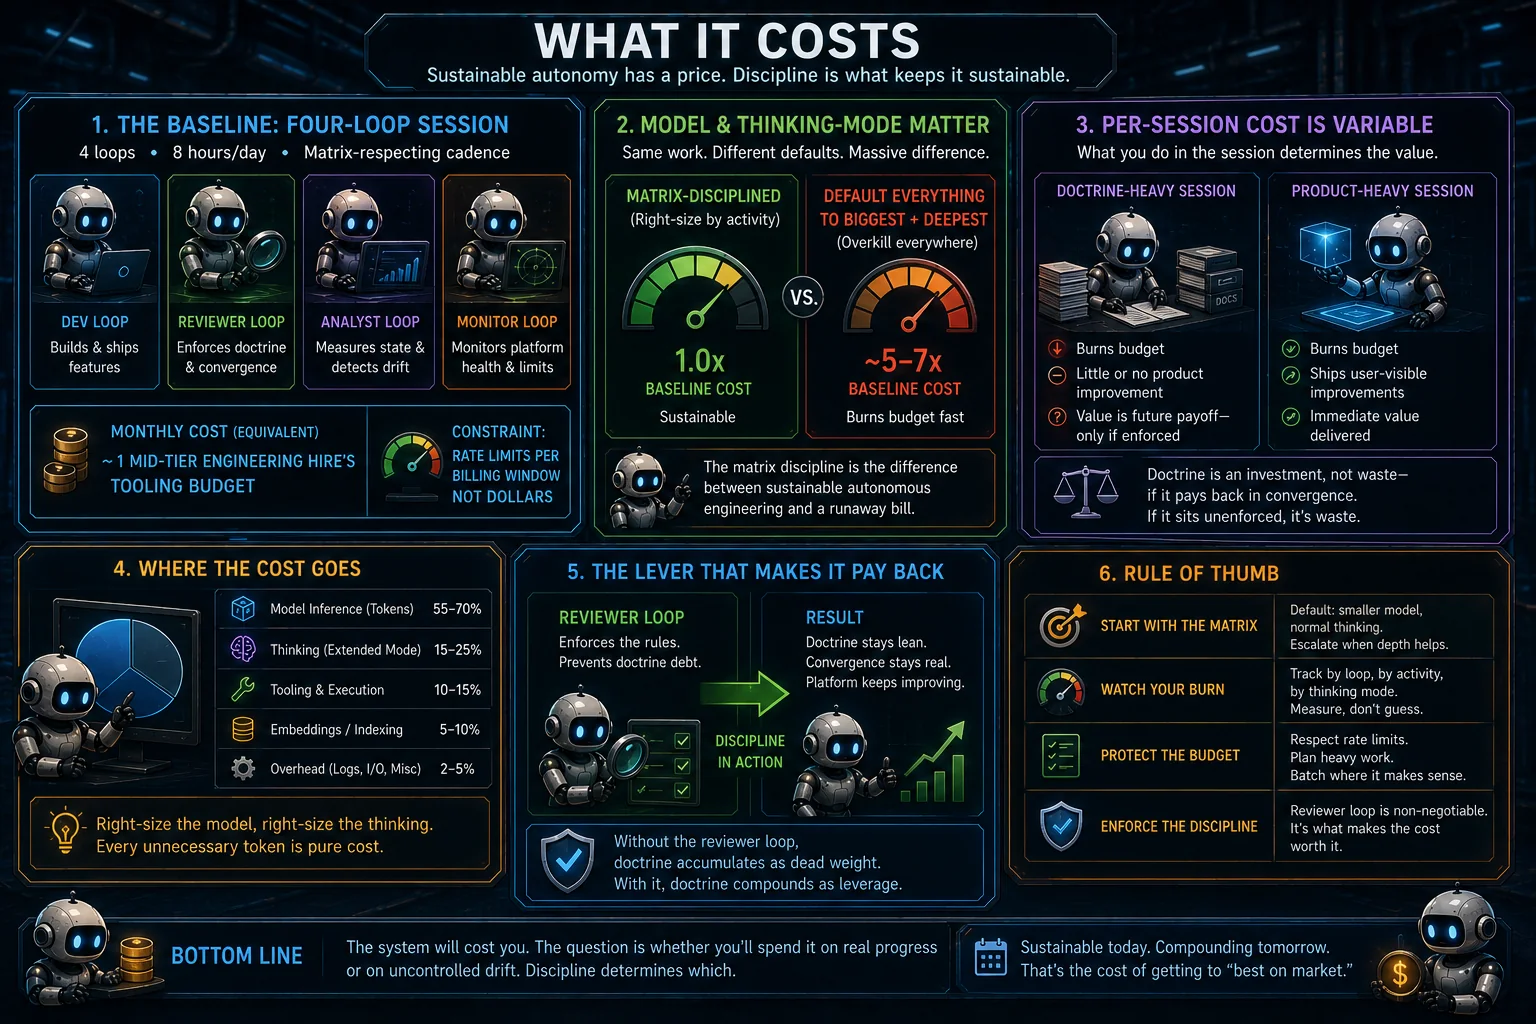
Granskarloopen är det som får doktrinen att betala tillbaka sig. Utan den ackumuleras doktrin som dödvikt.
Läxan jag lär mig om och om igen
Varje gång jag lägger till en ny regel, agent eller process i det här systemet lägger jag last på framtiden. Konvergensdisciplinens regel är den enda som är nettonegativ i last — den tvingar varje annat tillägg att betala för sig i mätbar förbättring.
Patologin jag beskrev i början av artikeln — ”agenterna är produktiva men produkten rör sig inte” — är ett disciplinfel, inte ett verktygsfel. Agenterna gör precis det du säger åt dem: levererar commits, klarar CI, uppdaterar dokumentationen. De fick bara aldrig veta att commitsen måste flytta en mätbar axel.
När du väl säger det, med uttryckliga regler per körning och per artefakt, med en enda kanonisk tillståndsfil, med ansvarsfördelning mellan fyra loopar, med den ärliga gränsen för vad bara människor kan göra och med worktree-isolering så att de inte kolliderar — då blir agenterna användbara.
Inte magiska. Användbara. Ibland.
”Ibland” är det som artikelns första utkast missade. Disciplinen är målet. Även när den är nedskriven, även när reglerna är uttryckliga, även när granskarloopen körs kommer du (och dina agenter) att glida. Glidningen fångas — det är vad analytikerloopen är till för — men den förhindras inte. Mekanismen är självkorrigerande, inte självförebyggande.
Den skillnaden spelar roll. Litteraturen om verktyg för AI-utveckling är full av ”magiska” påståenden. Verkligheten är: en liten uppsättning disciplinerade mönster, rigoröst upprätthållna av andra agenter (inte av självdisciplin), som får autonoma agenter att utföra verkligt arbete för det mesta, med fångad och korrigerad glidning resten av tiden. Allt annat är teater.
Om du kör kodningsagenter på en verklig kodbas och ser de felmönster jag beskrev, kan mönstren ovan hjälpa. De är inte nya; de flesta är kodifieringar av vad bra ingenjörsteam redan gör. Det nya är att göra dem bärande för autonoma loopar, där ingen människa finns i närheten som kan upprätthålla dem underförstått — och att namnge de felmönster som överlever disciplinen ändå.
Tillägg. Fusklapp
Den här sidan är en fullständig kopia av berättelsen så som den publicerades på Medium. Läs den på Medium. Illustrationer genererade med AI.