
Medium · Automatización, Web scraping · Borrador
Cuando la API no basta: extracción de datos asistida por navegador en nombre del usuario
Las plataformas SaaS modernas suelen exponer API públicas. En teoría, esto debería hacer sencillas las integraciones, los informes, la recopilación de evidencias de cumplimiento, la analítica y la automatización.
Publicado por primera vez en Medium el 26 de mayo de 2026. Léalo en Medium. 8 min de lectura.
En la práctica, la API disponible no siempre es suficiente:
- A veces la API pública no existe.
- A veces existe, pero expone solo un subconjunto limitado de los datos.
- A veces los datos son visibles en la aplicación web pero no están disponibles a través de endpoints documentados.
- Y a veces la función de exportación se limita a un archivo CSV que no incluye los metadatos, las relaciones, los comentarios, el historial ni la pista de auditoría que exige un fin empresarial legítimo.
Esto crea un problema práctico: el usuario está autorizado a acceder a la información, la información es visible en la aplicación, pero no existe un mecanismo oficial adecuado para obtenerla de forma estructurada y repetible.
En esos casos, la extracción de datos asistida por navegador puede convertirse en una solución alternativa práctica.
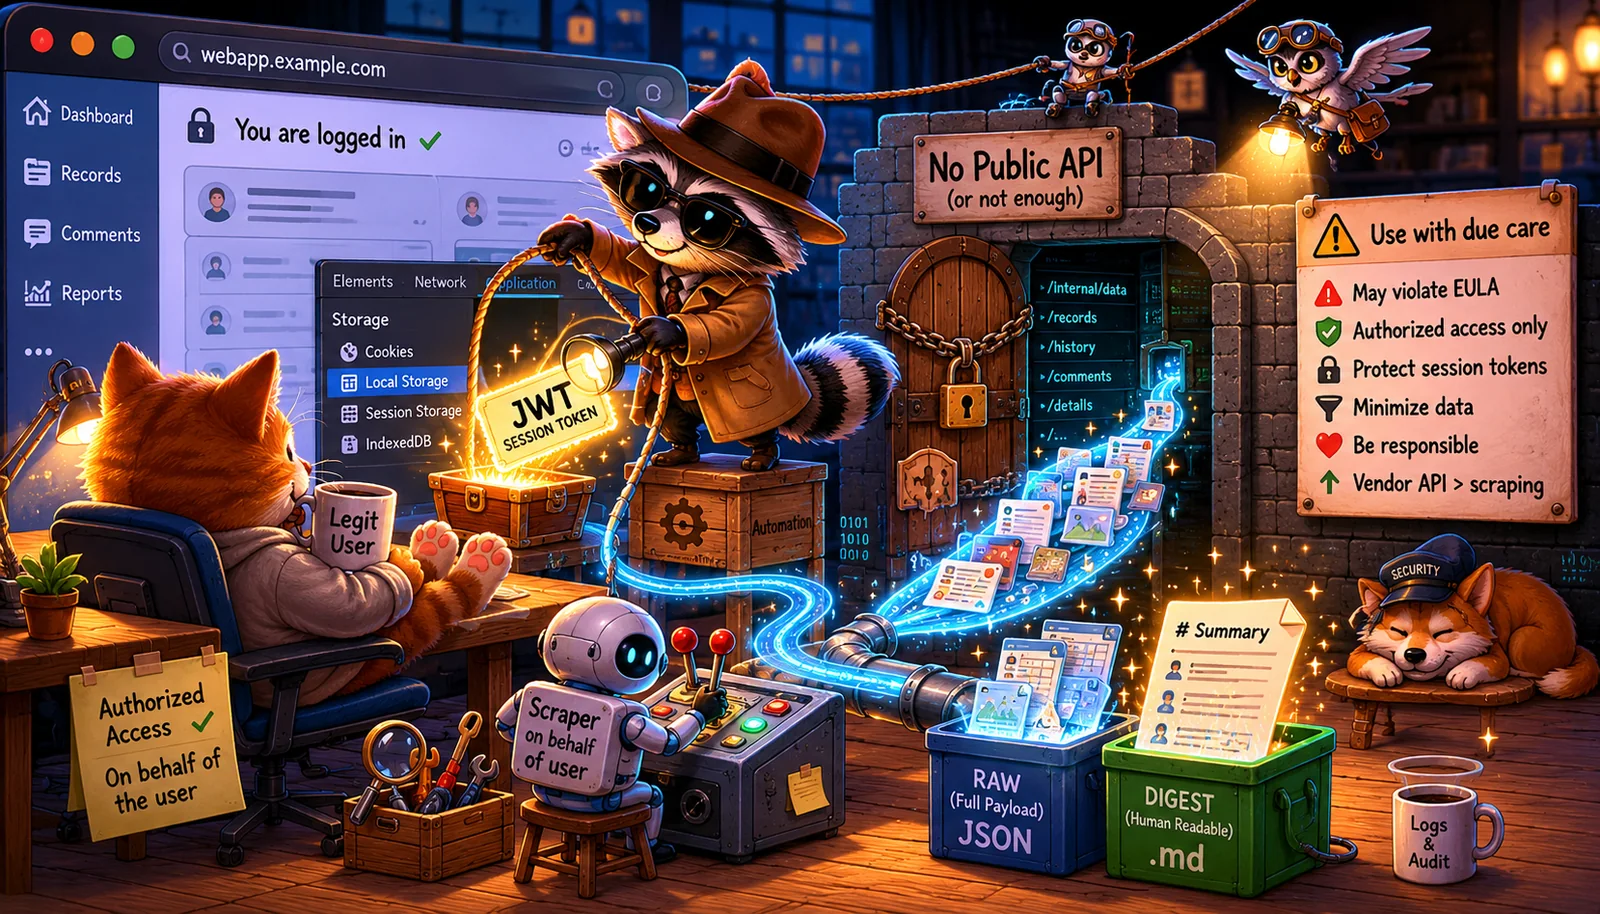
1. No es una automatización robótica de procesos (RPA)
Este enfoque puede parecerse a la automatización robótica de procesos (RPA), pero no es exactamente lo mismo.
La RPA tradicional suele imitar la interfaz de usuario: hace clic en botones, rellena formularios, desplaza páginas, espera a que carguen las pantallas y lee los elementos visibles. Trata la aplicación web como un espacio de trabajo visual y automatiza los mismos pasos que una persona daría a mano.
La extracción asistida por navegador funciona en otra capa. El navegador se sigue usando para la autenticación legítima del usuario y el control de acceso, pero la recopilación real de datos se hace observando y reutilizando la propia comunicación de la aplicación con su backend. En lugar de copiar valores de la pantalla, la automatización obtiene los datos estructurados que la propia aplicación ya recibe para poder dibujar esa pantalla.
En términos sencillos:
- La RPA automatiza lo que el usuario hace en la página.
- La extracción asistida por navegador automatiza lo que la página hace entre bastidores en nombre del usuario.
Esta distinción importa. La extracción asistida por navegador suele ser más estable, más rápida y más completa que la automatización visual de la interfaz, porque puede trabajar con cargas estructuradas en lugar de con elementos de interfaz ya renderizados. Al mismo tiempo, exige más cuidado, porque puede apoyarse en el comportamiento interno de la aplicación, en endpoints no documentados, cookies, almacenamiento de sesión, almacenamiento local u otros artefactos relacionados con la sesión.
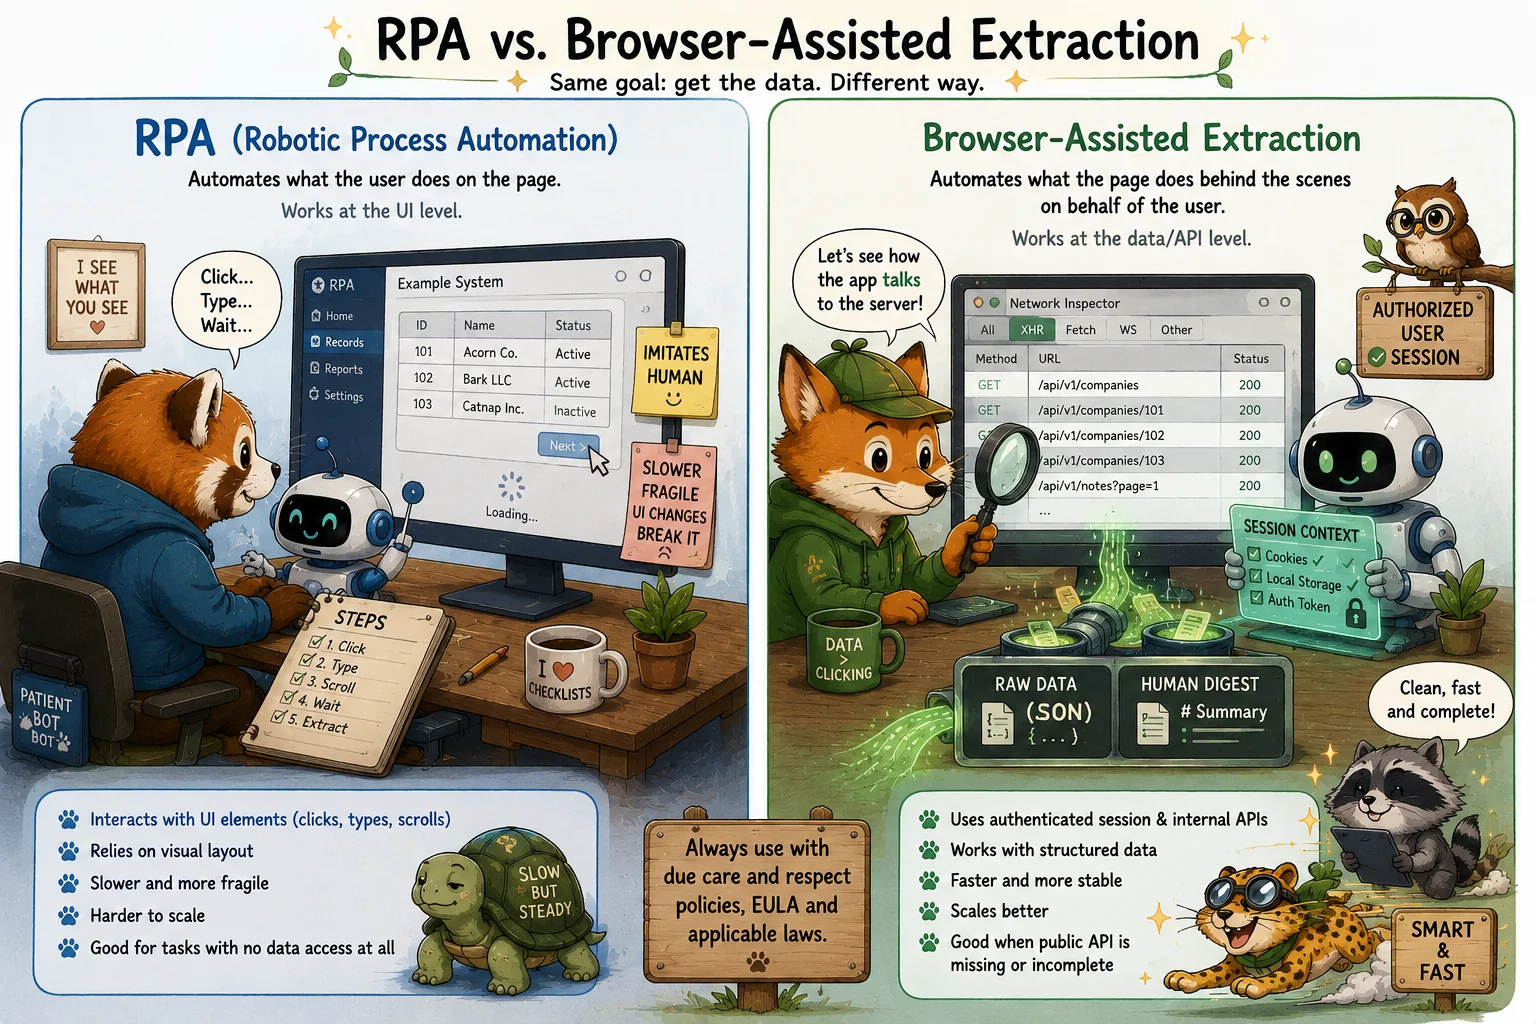
Por ello, este patrón debe tratarse como una solución alternativa controlada. No sustituye a una API oficial, a una integración compatible ni a una función de exportación bien documentada. Se parece más a «descubrir la API a través de la sesión autenticada del navegador» que a la RPA clásica.
El principio sigue siendo el mismo: la automatización debe actuar solo en nombre de un usuario autorizado, recopilar solo los datos a los que ese usuario tiene derecho a acceder y utilizarse teniendo en cuenta las consideraciones legales, contractuales, de privacidad y de seguridad.
2. El escenario
Imagine un sistema que una empresa utiliza para la gobernanza, el cumplimiento, las operaciones o la administración interna.
El sistema tiene una interfaz web. Los usuarios autorizados pueden iniciar sesión, navegar por los registros, ver los detalles y exportar o copiar información manualmente. Sin embargo, el sistema presenta una de las siguientes limitaciones:
- No hay API pública disponible.
- La API pública está incompleta y no expone todos los datos necesarios.
- La función de exportación es insuficiente para las necesidades de negocio, auditoría, migración o informes.
- Hay metadatos importantes visibles en el navegador pero no disponibles a través de métodos de integración documentados.
- La extracción manual sería lenta, propensa a errores y difícil de reproducir.
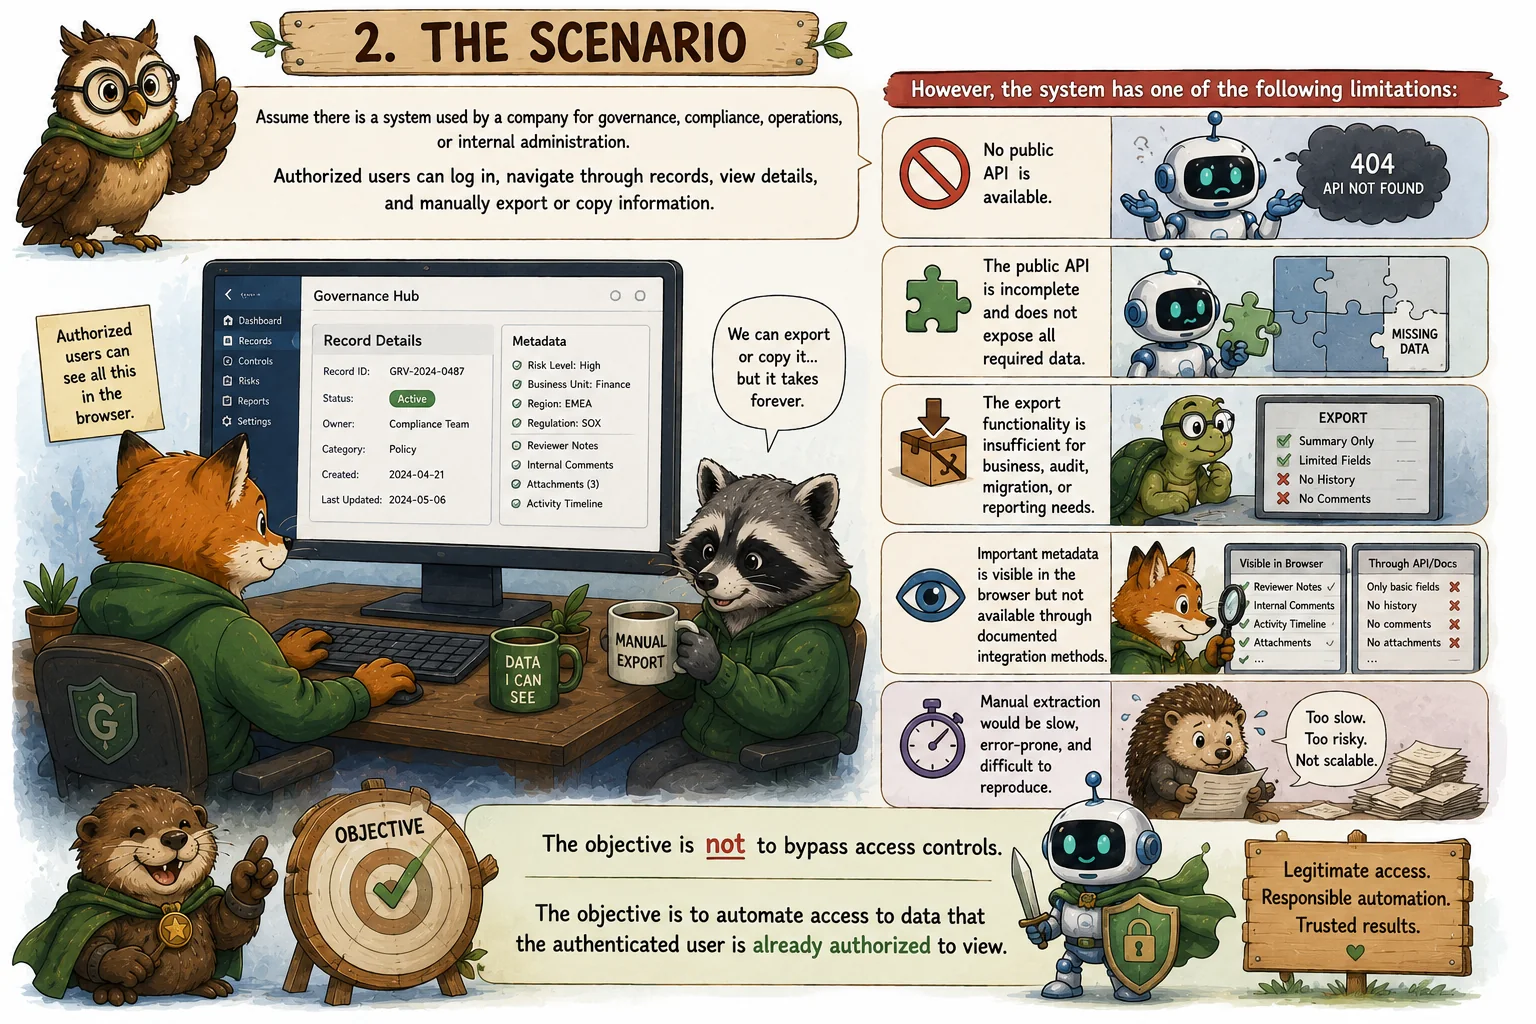
El objetivo no es eludir los controles de acceso. El objetivo es automatizar el acceso a datos que el usuario autenticado ya está autorizado a ver.
3. El enfoque general
El patrón general es el scraping asistido por navegador en nombre del usuario.
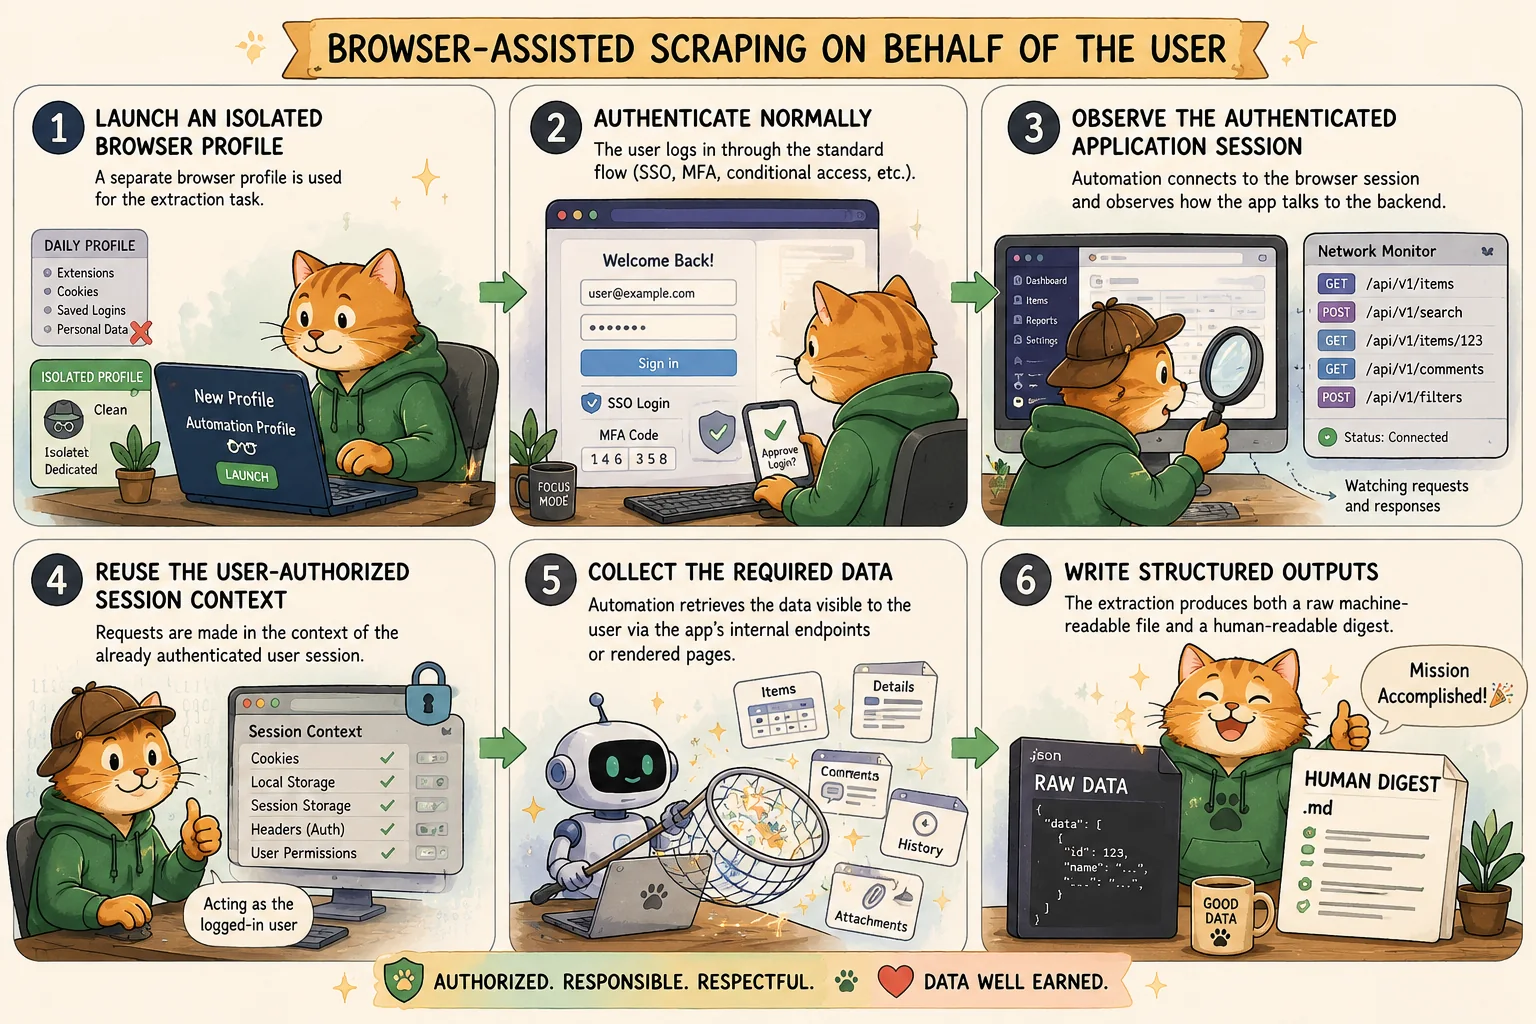
Un flujo de trabajo típico puede ser el siguiente:
- Lanzar un perfil de navegador aislado. Se usa un perfil de navegador independiente para la tarea de extracción. Así se evita mezclar la sesión de automatización con el perfil de navegación diaria del usuario, sus extensiones, sus credenciales guardadas, sus cookies ajenas al caso y sus sesiones personales.
- Autenticarse con normalidad. El usuario inicia sesión a través de la interfaz web estándar, con el flujo de autenticación habitual, incluidos SSO, MFA, acceso condicional o cualquier otro control que exija el sistema.
- Observar la sesión autenticada de la aplicación. Tras la autenticación, la automatización se conecta a la sesión del navegador y observa cómo se comunica la aplicación web con su backend.
- Reutilizar el contexto de sesión autorizado por el usuario. La automatización realiza las solicitudes en el contexto de la sesión de usuario ya autenticada. En algunos sistemas, el material de sesión pertinente puede almacenarse en mecanismos de almacenamiento accesibles desde el navegador, como las cookies, el almacenamiento de sesión o el almacenamiento local.
- Recopilar los datos necesarios. La automatización obtiene los datos que el usuario ve, a través de los endpoints internos de la aplicación o de las páginas renderizadas.
- Escribir salidas estructuradas. La extracción produce tanto un archivo bruto legible por máquina como un resumen legible por personas (recomendado).
4. Por qué funciona
Muchas aplicaciones web se construyen como clientes basados en navegador que se comunican con servicios de backend. Incluso cuando no hay una API pública, el propio navegador suele usar API internas para cargar los datos que se muestran en la interfaz de usuario.
Esto significa que la forma más fácil de entender cómo obtener toda la información relevante de un sistema es, a veces, inspeccionar cómo la obtiene el propio sistema para el navegador.
Esa es la incómoda realidad práctica.
Desde un punto de vista técnico, la aplicación web ya sabe dónde están los datos, qué endpoints se usan, qué parámetros se requieren y cómo se paginan o filtran los registros. La extracción asistida por navegador se limita a automatizar lo que el usuario podría hacer de otro modo a mano, siempre que se mantenga dentro de sus derechos de acceso legítimos.
5. El «hackeo» que en realidad no es un hackeo
Entre ingenieros y profesionales de la automatización del cumplimiento circula un chiste habitual:
La forma más fácil de obtener toda la información de un sistema es «hackearlo».
En este contexto, «hackear» no debe significar acceso no autorizado, explotación de vulnerabilidades, escalada de privilegios ni elusión de controles de seguridad. Significa entender cómo funciona por dentro la aplicación web y usar ese conocimiento para automatizar un proceso que de otro modo sería manual.
Por ejemplo, algunas aplicaciones web guardan en el navegador artefactos de sesión temporales para que el frontend pueda comunicarse con los servicios de backend. En algunos casos, la automatización puede reutilizar la sesión autenticada del navegador para extraer datos en nombre del usuario.
Puede ser una técnica potente cuando no hay una API oficial o esta es incompleta. También es una técnica que debe manejarse con cuidado, porque el material de sesión es sensible y puede dar un acceso equivalente al del usuario que ha iniciado sesión.
6. Aviso legal y contractual
Este tipo de automatización debe utilizarse con la debida cautela.
Aunque el usuario esté legítimamente autorizado a acceder a los datos, el scraping asistido por navegador puede infringir el contrato de licencia de usuario final (EULA) del sistema, sus Términos de servicio, su Política de uso aceptable, restricciones contractuales o su política de seguridad.
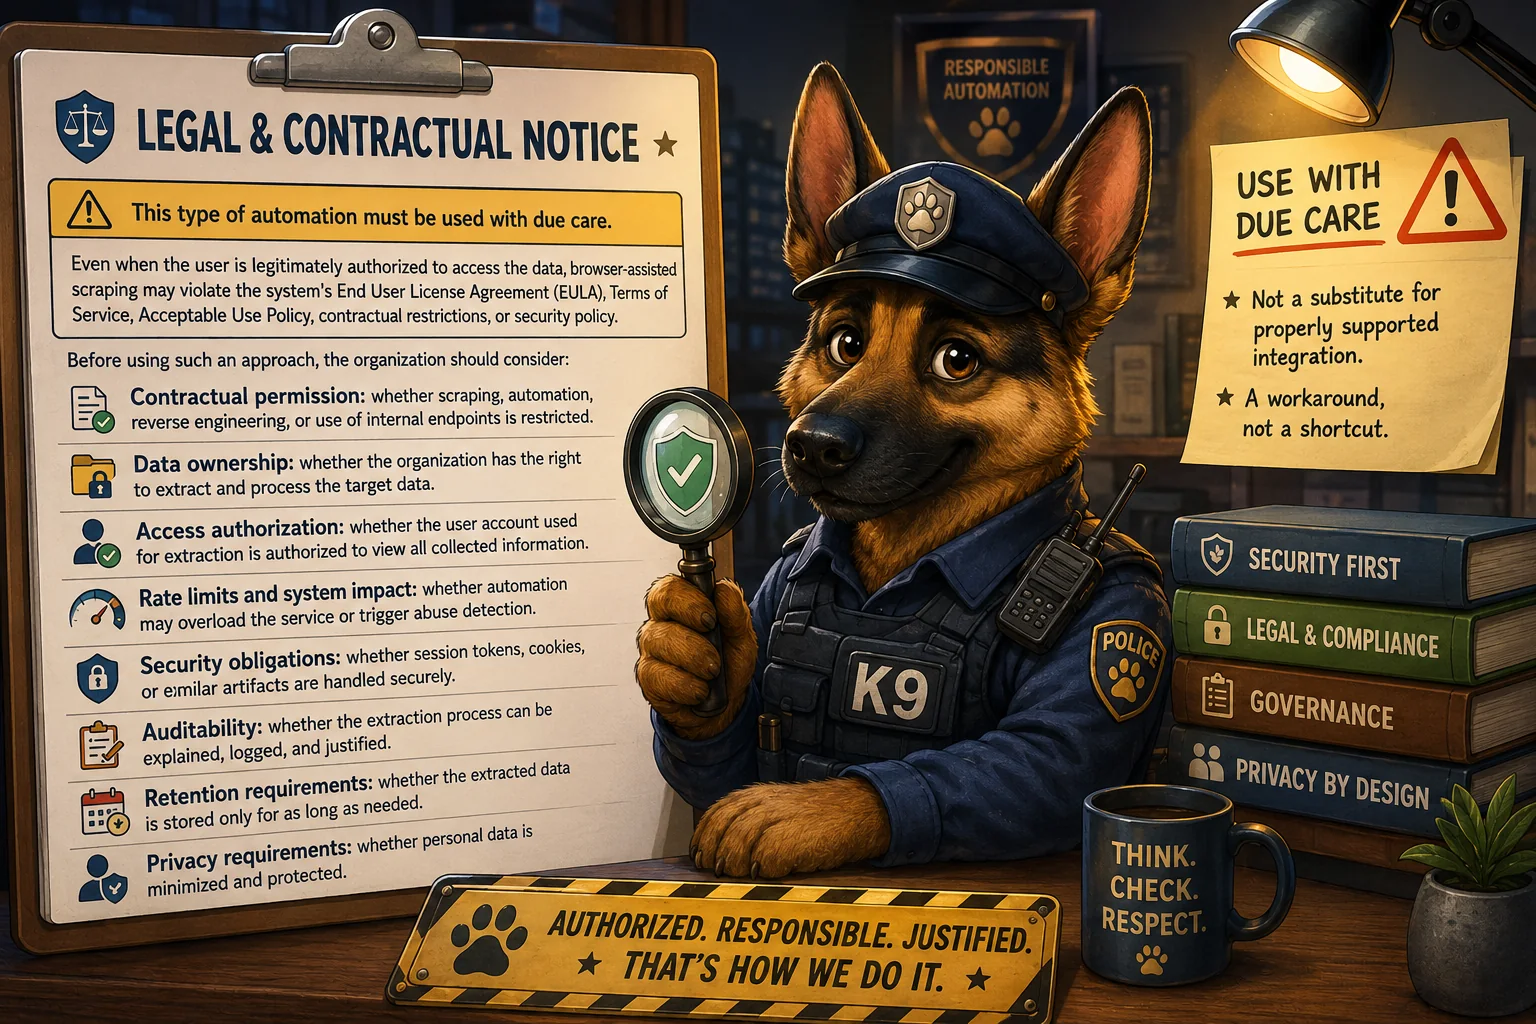
Antes de recurrir a este enfoque, la organización debería considerar:
- Permiso contractual: si se restringe el scraping, la automatización, la ingeniería inversa o el uso de endpoints internos.
- Titularidad de los datos: si la organización tiene derecho a extraer y tratar los datos de destino.
- Autorización de acceso: si la cuenta de usuario empleada para la extracción está autorizada a ver toda la información recopilada.
- Límites de tasa e impacto en el sistema: si la automatización puede sobrecargar el servicio o activar la detección de abusos.
- Obligaciones de seguridad: si los tokens de sesión, las cookies o artefactos similares se manejan de forma segura.
- Auditabilidad: si el proceso de extracción puede explicarse, registrarse y justificarse.
- Requisitos de conservación: si los datos extraídos se almacenan solo durante el tiempo necesario.
- Requisitos de privacidad: si los datos personales se minimizan y se protegen.
Este patrón no debe usarse a la ligera. Es una solución alternativa, no un sustituto de una integración debidamente compatible.
7. Consideraciones de seguridad
Los artefactos de sesión, incluidas las cookies y los tokens, deben tratarse como credenciales sensibles.
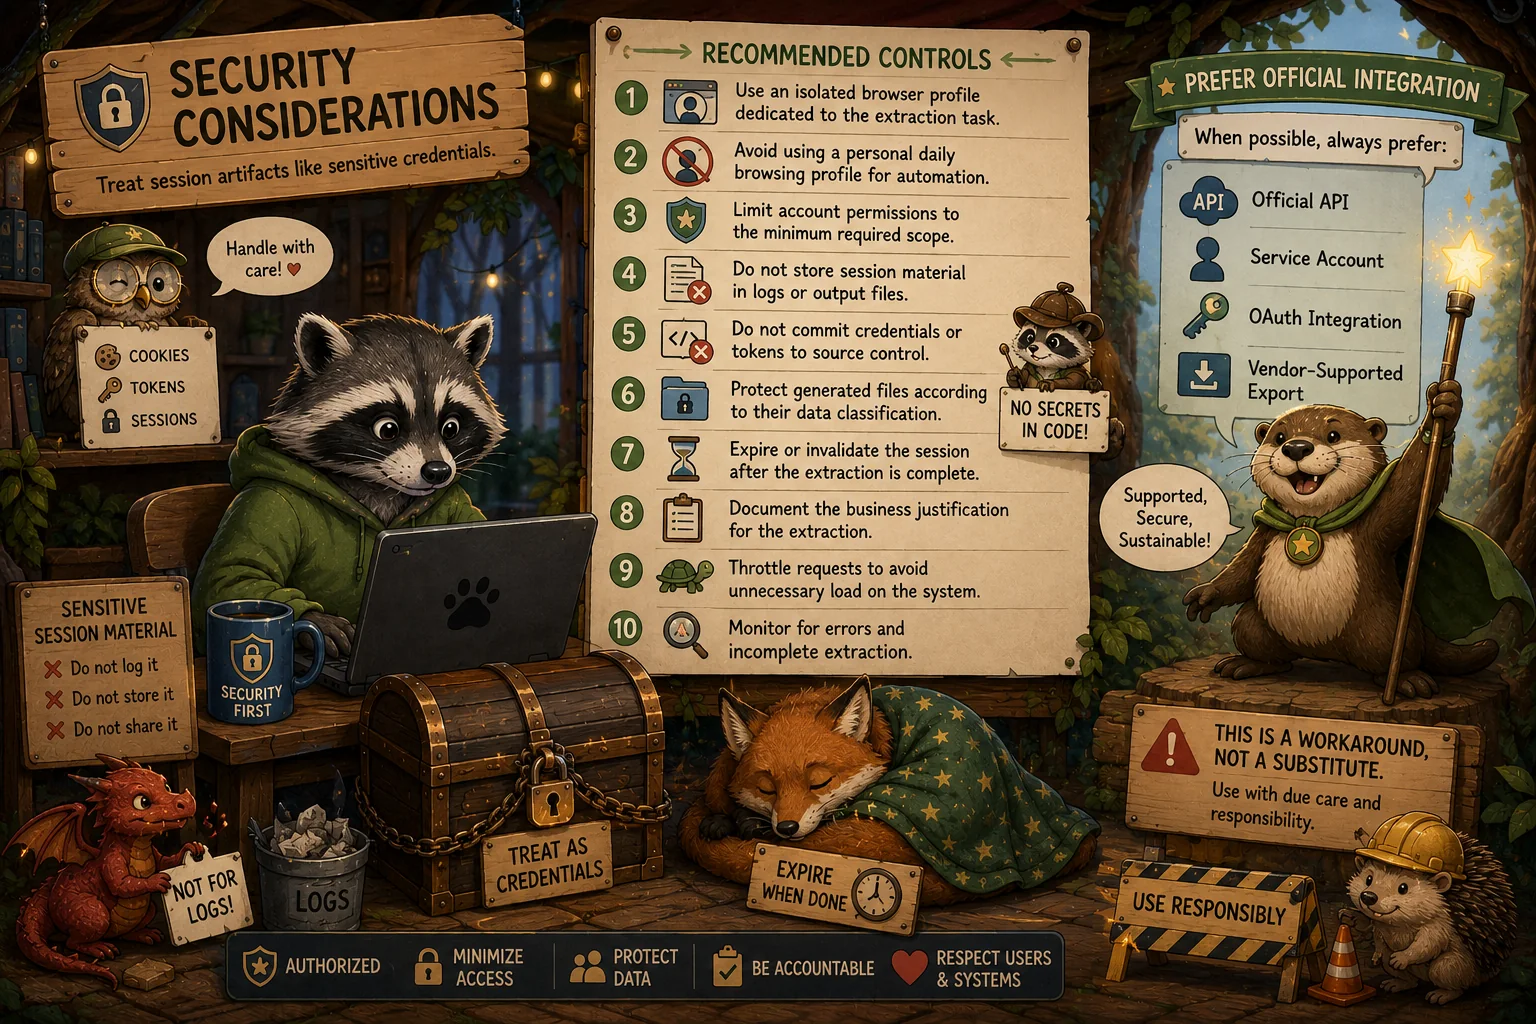
Si la automatización se apoya en una sesión autenticada, se recomiendan encarecidamente los siguientes controles:
- Usar un perfil de navegador aislado dedicado a la tarea de extracción.
- Evitar usar un perfil personal de navegación diaria para la automatización.
- Limitar los permisos de la cuenta al alcance mínimo necesario.
- No almacenar material de sesión en registros ni en archivos de salida.
- No subir credenciales ni tokens al control de código fuente.
- Proteger los archivos generados según su clasificación de datos.
- Hacer caducar o invalidar la sesión cuando termine la extracción.
- Documentar la justificación empresarial de la extracción.
- Limitar el ritmo de las solicitudes para evitar una carga innecesaria en el sistema.
- Supervisar los errores y las extracciones incompletas.
Siempre que sea posible, debe preferirse una API oficial, una cuenta de servicio, una integración OAuth o un mecanismo de exportación compatible con el proveedor.
8. Ejemplo de caso de uso teórico
Imagine que una empresa necesita extraer registros de una plataforma SaaS interna para una revisión de cumplimiento.
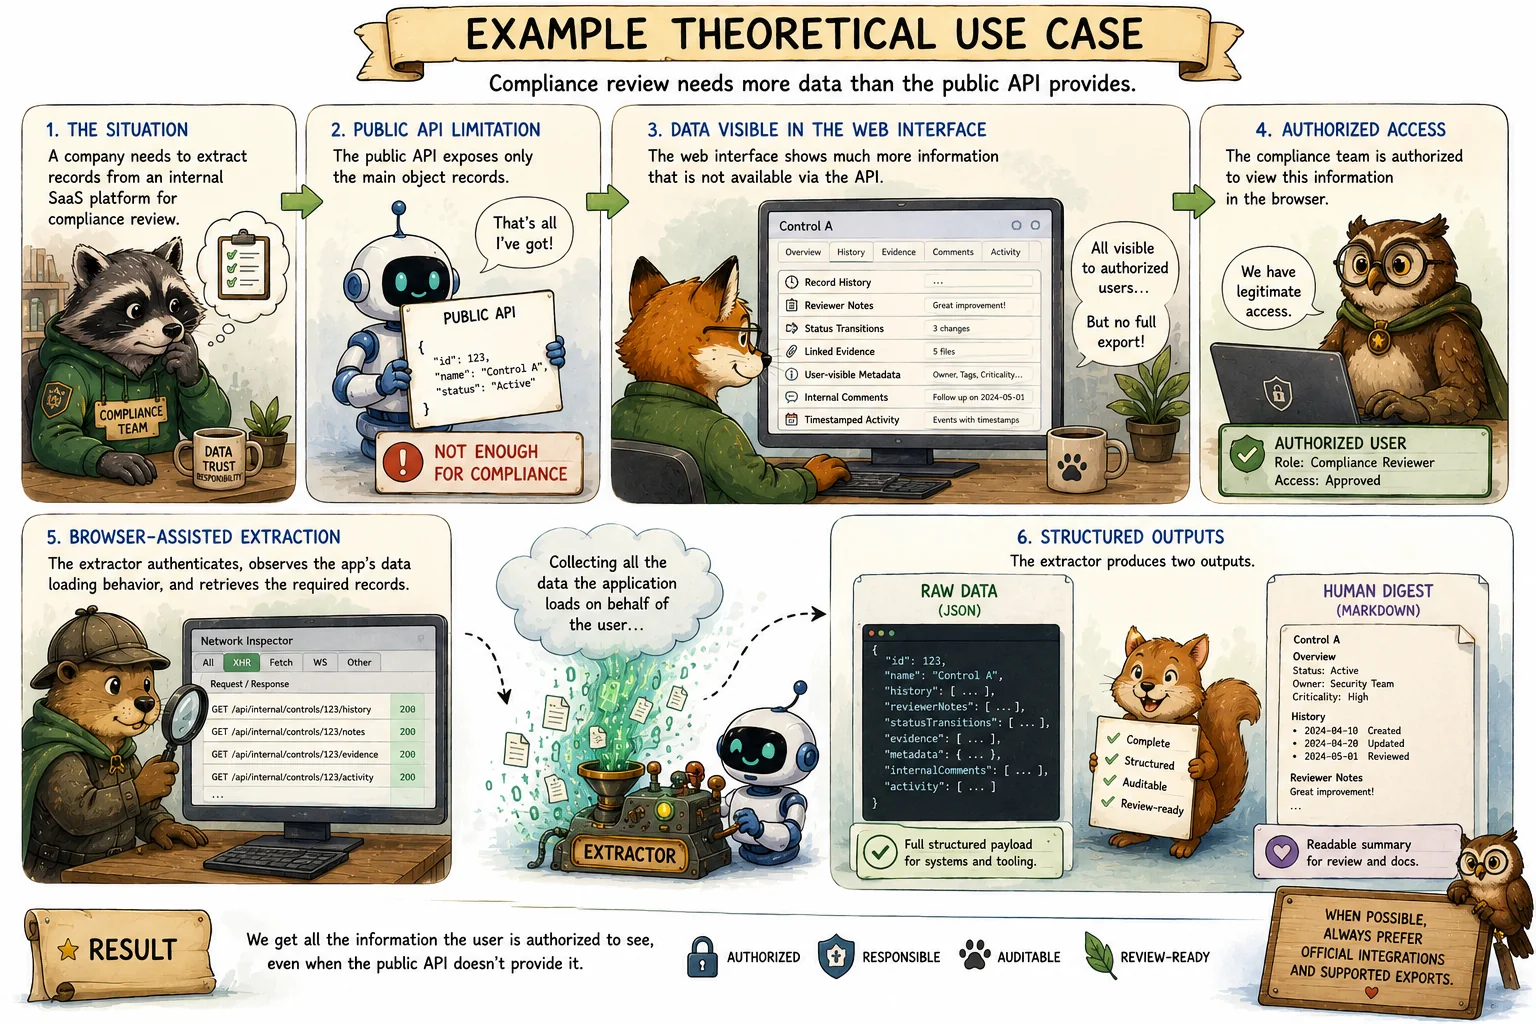
La API pública expone solo los registros del objeto principal, pero la interfaz web muestra información adicional, como:
- Historial del registro
- Notas del revisor
- Transiciones de estado
- Evidencia vinculada
- Metadatos visibles para el usuario
- Comentarios internos
- Actividad con marca de tiempo
El equipo de cumplimiento está autorizado a ver esta información en el navegador, pero no existe una función de exportación completa.
Un extractor asistido por navegador puede autenticarse como el usuario autorizado, observar cómo carga datos la propia aplicación, obtener los registros necesarios y producir dos salidas. El archivo JSON conserva la carga estructurada completa. El archivo Markdown ofrece una versión legible, adecuada para la revisión y la documentación.
9. Uso responsable
El scraping asistido por navegador puede ser legítimo cuando se usa para obtener datos a los que el usuario ya está autorizado a acceder y cuando no existe un mecanismo de exportación oficial adecuado.
Sin embargo, debe tratarse como una solución de ingeniería por excepción. Debe revisarse desde las perspectivas legal, de seguridad, de privacidad y operativa antes de utilizarse.
El mejor resultado sigue siendo una API compatible con el proveedor. Pero cuando la API falta o es insuficiente, una extracción asistida por navegador cuidadosamente controlada puede ofrecer un puente práctico entre el trabajo manual y una integración adecuada.
10. Conclusión
Los sistemas sin API suficientes generan fricción para el cumplimiento, la auditoría, los informes, la migración y la automatización operativa. En tales casos, la extracción de datos asistida por navegador puede ser una solución alternativa pragmática.
El principio clave es sencillo: automatice solo aquello a lo que el usuario tiene legítimamente permitido acceder, proteja el material de sesión como credenciales, evite la recopilación innecesaria de datos, respete las restricciones contractuales y documente la justificación.
Utilizado de forma responsable, este enfoque puede convertir un proceso que de otro modo sería manual y poco fiable en un flujo de trabajo repetible, estructurado y auditable.
Esta página es una copia íntegra del artículo tal como se publicó en Medium. Léalo en Medium. Ilustraciones generadas con IA.