
Medium · Automatisering, webscraping · Concept
Wanneer de API niet volstaat: data-extractie met behulp van de browser, namens de gebruiker
Moderne SaaS-platformen bieden vaak openbare API’s aan. In theorie zou dat integraties, rapportage, het verzamelen van compliancebewijs, analyses en automatisering eenvoudig moeten maken.
Voor het eerst gepubliceerd op Medium op 26 mei 2026. Lees het op Medium. 8 minuten leestijd.
In de praktijk volstaat de beschikbare API niet altijd:
- Soms bestaat er geen openbare API.
- Soms bestaat ze wel, maar geeft ze slechts een beperkte subset van de gegevens vrij.
- Soms zijn de gegevens zichtbaar in de webapplicatie, maar niet beschikbaar via gedocumenteerde eindpunten.
- En soms is de exportfunctie beperkt tot een CSV-bestand zonder de metadata, relaties, opmerkingen, historiek of audittrail die voor een legitiem zakelijk doel nodig zijn.
Dat levert een praktisch probleem op: de gebruiker mag de informatie raadplegen, de informatie is zichtbaar in de applicatie, maar er is geen adequaat officieel mechanisme om ze op een gestructureerde en herhaalbare manier op te halen.
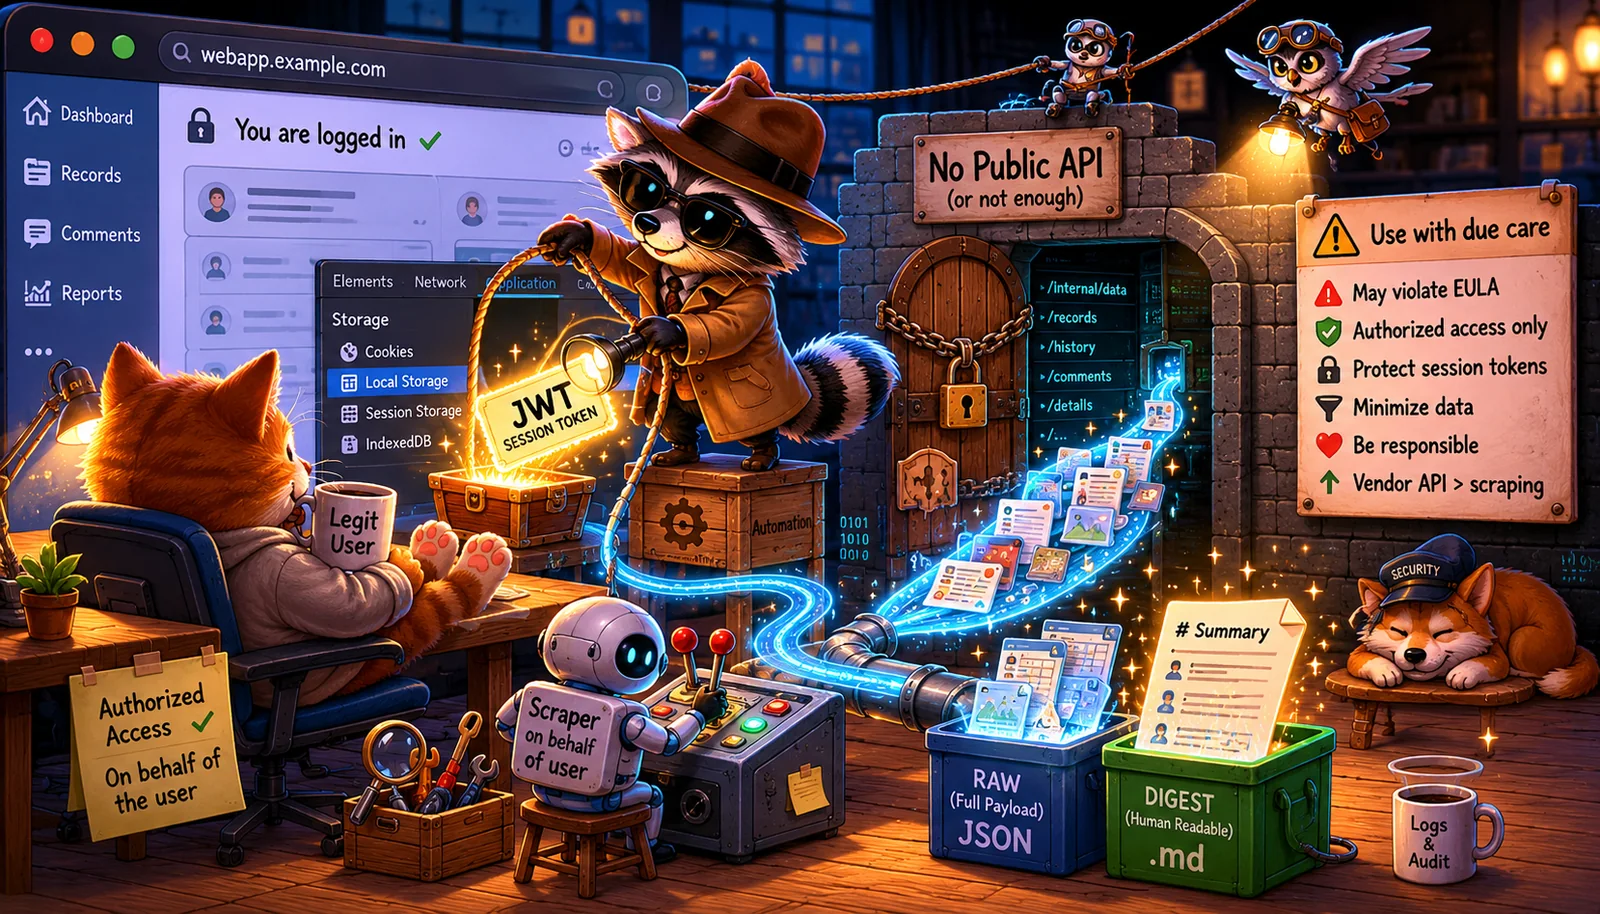
In zulke gevallen kan browsergestuurde gegevensextractie een praktische noodoplossing worden.
1. Geen Robotic Process Automation (RPA)
Deze aanpak lijkt misschien op Robotic Process Automation (RPA), maar is niet helemaal hetzelfde.
Traditionele RPA bootst meestal de gebruikersinterface na: ze klikt op knoppen, vult formulieren in, scrolt door pagina’s, wacht tot schermen geladen zijn en leest zichtbare elementen uit. Ze behandelt de webapplicatie als een visuele werkruimte en automatiseert dezelfde stappen als een mens handmatig zou uitvoeren.
Browsergestuurde extractie werkt op een andere laag. De browser wordt nog steeds gebruikt voor legitieme gebruikersauthenticatie en toegangsbeheer, maar de eigenlijke gegevensverzameling gebeurt door de communicatie van de applicatie met haar eigen backend te observeren en te hergebruiken. In plaats van waarden van het scherm te kopiëren, haalt de automatisering gestructureerde gegevens op die de applicatie zelf al ontvangt om het scherm te kunnen tonen.
In eenvoudige woorden:
- RPA automatiseert wat de gebruiker op de pagina doet.
- Browsergestuurde extractie automatiseert wat de pagina op de achtergrond doet namens de gebruiker.
Dit onderscheid is belangrijk. Browsergestuurde extractie is meestal stabieler, sneller en completer dan visuele UI-automatisering, omdat ze met gestructureerde payloads kan werken in plaats van met weergegeven interface-elementen. Tegelijk vraagt ze meer zorg, omdat ze kan steunen op intern applicatiegedrag, niet-gedocumenteerde eindpunten, cookies, sessieopslag, lokale opslag of andere sessiegebonden artefacten.
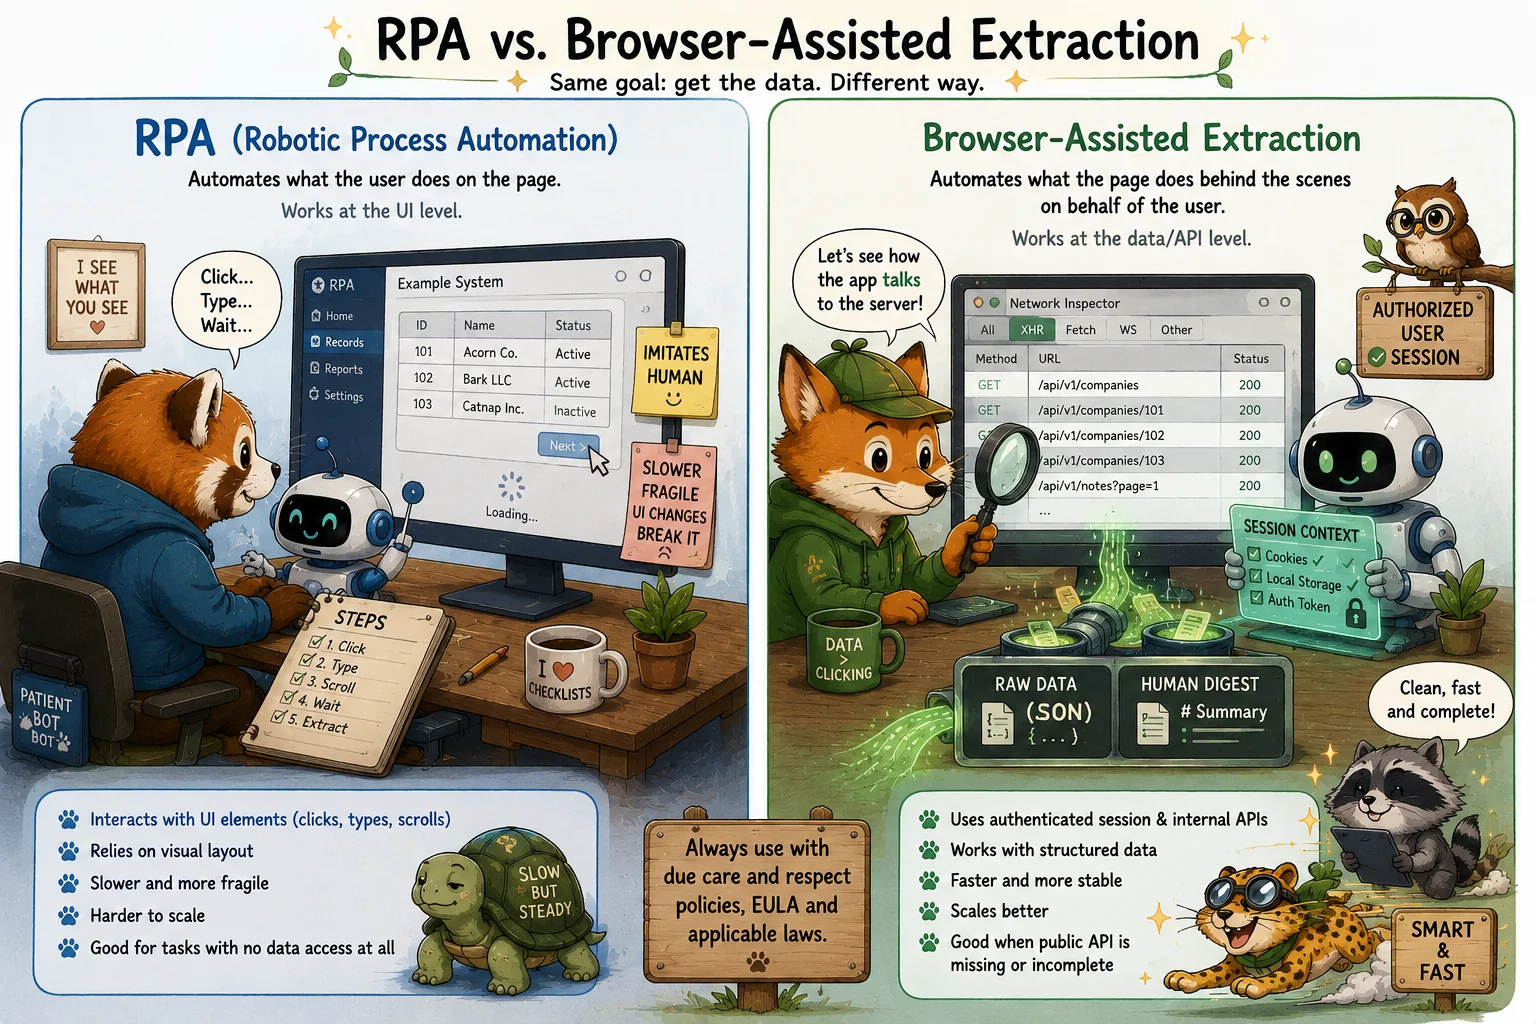
Daarom moet dit patroon worden behandeld als een beheerste noodoplossing. Het is geen vervanging voor een officiële API, een ondersteunde integratie of een degelijk gedocumenteerde exportfunctie. Het staat dichter bij “API-ontdekking via de geauthenticeerde browsersessie” dan bij klassieke RPA.
Het principe blijft hetzelfde: de automatisering mag alleen handelen namens een bevoegde gebruiker, mag enkel gegevens verzamelen waartoe die gebruiker toegang heeft, en moet worden ingezet met oog voor juridische, contractuele, privacy- en beveiligingsaspecten.
2. Het scenario
Stel dat een bedrijf een systeem gebruikt voor governance, compliance, operaties of interne administratie.
Het systeem heeft een webinterface. Bevoegde gebruikers kunnen inloggen, door records navigeren, details bekijken en informatie handmatig exporteren of kopiëren. Het systeem heeft echter een van de volgende beperkingen:
- Er is geen openbare API beschikbaar.
- De openbare API is onvolledig en geeft niet alle vereiste gegevens vrij.
- De exportfunctie is ontoereikend voor zakelijke doeleinden, audit, migratie of rapportage.
- Belangrijke metadata is zichtbaar in de browser maar niet beschikbaar via gedocumenteerde integratiemethoden.
- Handmatige extractie zou traag, foutgevoelig en moeilijk te reproduceren zijn.
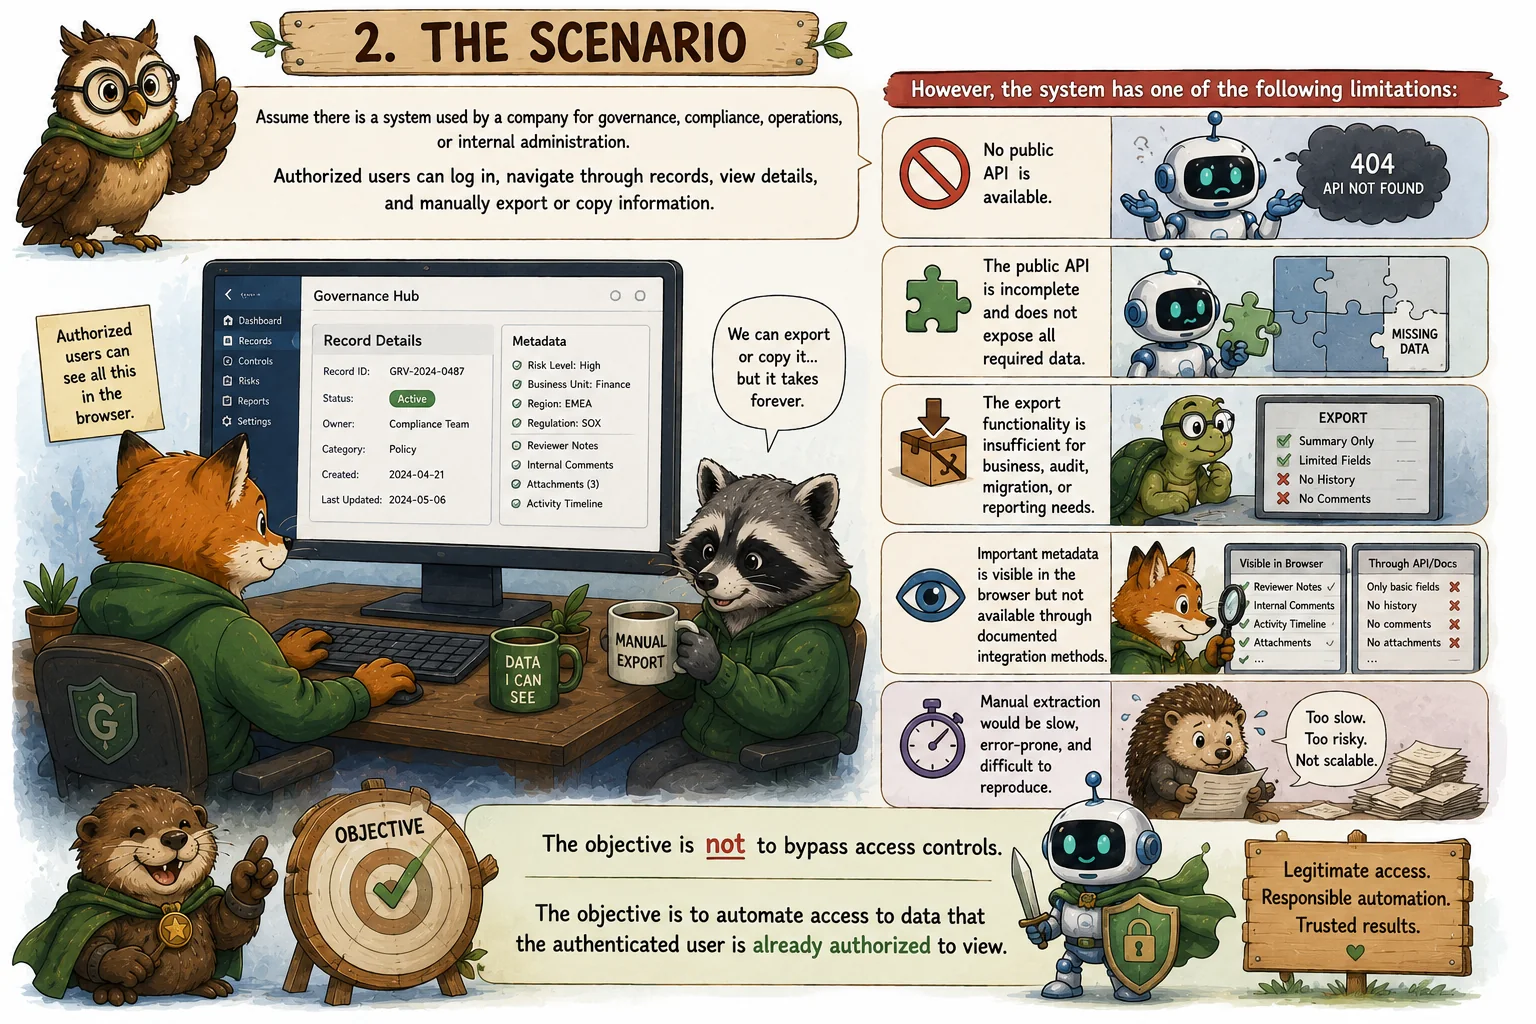
Het doel is niet om toegangsbeheer te omzeilen. Het doel is om de toegang te automatiseren tot gegevens die de geauthenticeerde gebruiker al mag raadplegen.
3. De algemene aanpak
Het algemene patroon is browsergestuurde scraping namens de gebruiker.
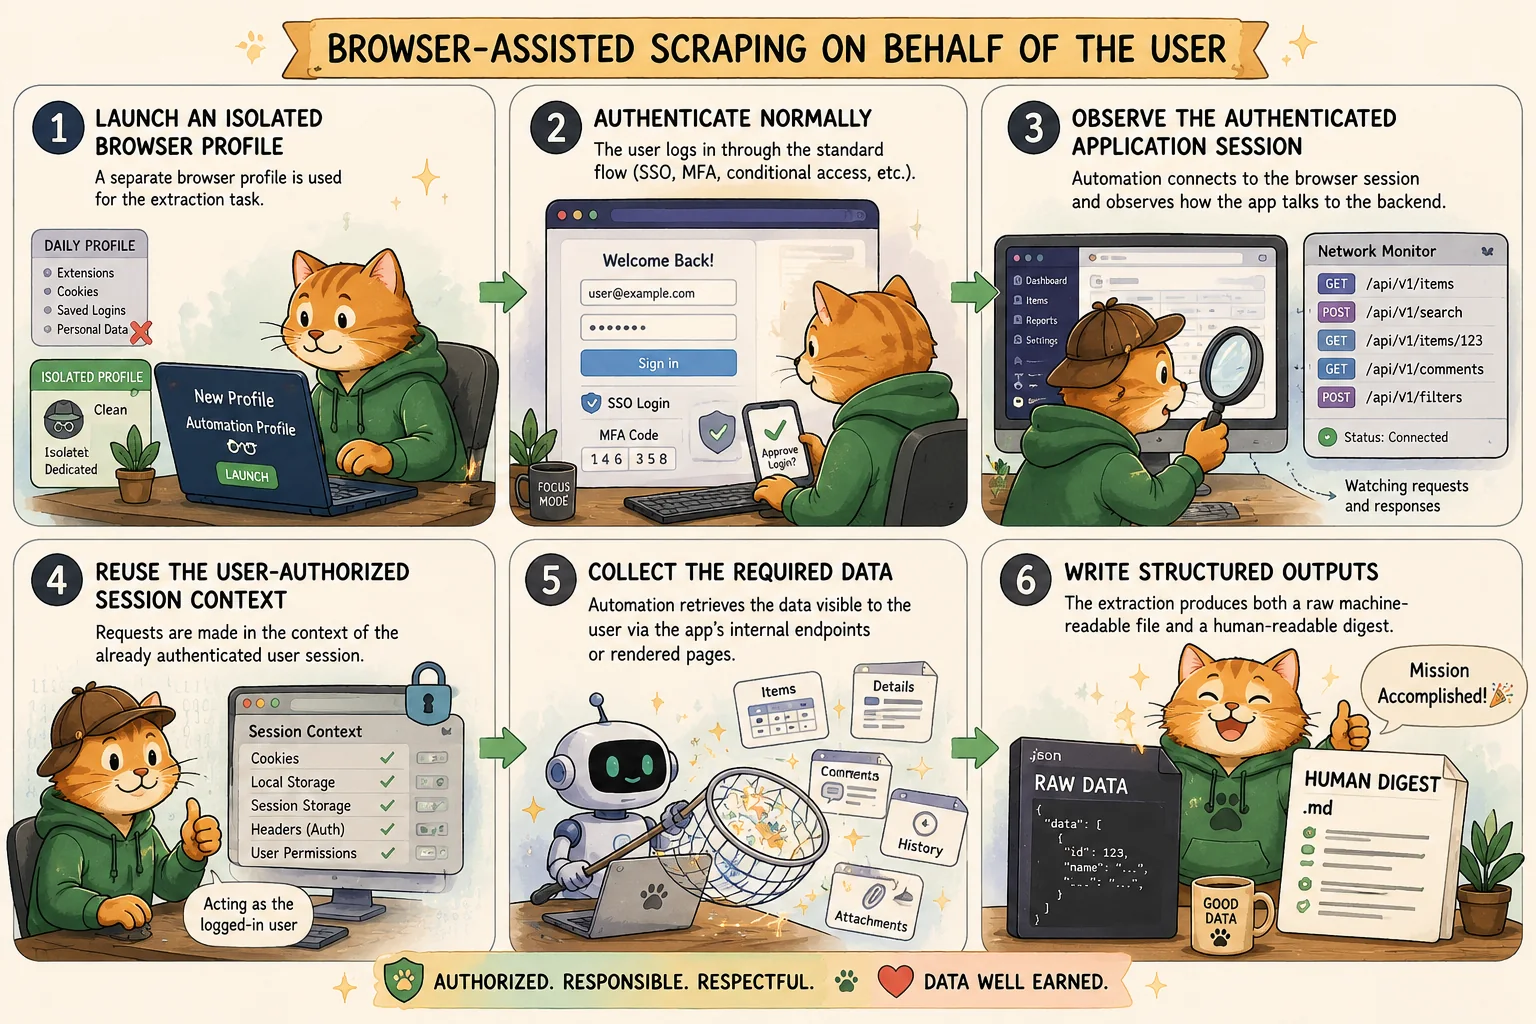
Een typische workflow kan er als volgt uitzien:
- Een geïsoleerd browserprofiel starten. Voor de extractietaak wordt een apart browserprofiel gebruikt. Zo wordt vermeden dat de automatiseringssessie wordt vermengd met het dagelijkse browserprofiel van de gebruiker, zijn extensies, opgeslagen inloggegevens, niet-gerelateerde cookies en persoonlijke sessies.
- Normaal inloggen. De gebruiker meldt zich aan via de standaard webinterface, met de gewone authenticatiestroom, inclusief SSO, MFA, voorwaardelijke toegang of andere maatregelen die het systeem vereist.
- De geauthenticeerde applicatiesessie observeren. Na de authenticatie koppelt de automatisering zich aan de browsersessie en observeert ze hoe de webapplicatie met haar backend communiceert.
- De door de gebruiker geautoriseerde sessiecontext hergebruiken. De automatisering voert verzoeken uit in de context van de reeds geauthenticeerde gebruikerssessie. In sommige systemen kan relevant sessiemateriaal worden bewaard in voor de browser toegankelijke opslagmechanismen, zoals cookies, sessieopslag of lokale opslag.
- De vereiste gegevens verzamelen. De automatisering haalt de gegevens op die voor de gebruiker zichtbaar zijn, via de interne eindpunten of weergegeven pagina’s van de applicatie.
- Gestructureerde output schrijven. De extractie levert zowel een ruw, machineleesbaar bestand als een voor mensen leesbare samenvatting op (aanbevolen).
4. Waarom dit werkt
Veel webapplicaties zijn opgebouwd als browsergebaseerde clients die met backendservices communiceren. Zelfs wanneer er geen openbare API is, gebruikt de browser zelf vaak interne API’s om de gegevens in de gebruikersinterface te laden.
Dat betekent dat de eenvoudigste manier om te begrijpen hoe je alle relevante informatie uit een systeem haalt, soms is om te bekijken hoe het systeem die informatie zelf voor de browser ophaalt.
Dat is de ongemakkelijke praktische werkelijkheid.
Technisch gezien weet de webapplicatie al waar de gegevens staan, welke eindpunten worden gebruikt, welke parameters nodig zijn en hoe records worden gepagineerd of gefilterd. Browsergestuurde extractie automatiseert eenvoudigweg wat de gebruiker anders handmatig zou kunnen doen, op voorwaarde dat ze binnen de legitieme toegangsrechten van de gebruiker blijft.
5. De “hack” die eigenlijk geen hack is
Onder engineers en specialisten in compliance-automatisering gaat een bekende grap rond:
De eenvoudigste manier om alle informatie uit een systeem te halen, is het te “hacken”.
In deze context mag “hacken” niet betekenen: ongeoorloofde toegang, uitbuiting, rechtenescalatie of het omzeilen van beveiligingsmaatregelen. Het betekent: begrijpen hoe de webapplicatie intern werkt en die kennis gebruiken om een anders handmatig proces te automatiseren.
Sommige webapplicaties slaan bijvoorbeeld tijdelijke sessieartefacten op in de browser, zodat de frontend met de backendservices kan communiceren. In sommige gevallen kan automatisering de geauthenticeerde browsersessie hergebruiken om namens de gebruiker gegevens te extraheren.
Dat kan een krachtige techniek zijn wanneer een officiële API ontbreekt of onvolledig is. Het is ook een techniek die zorgvuldig moet worden behandeld, omdat sessiemateriaal gevoelig is en toegang kan geven die gelijkwaardig is aan die van de aangemelde gebruiker.
6. Juridische en contractuele kennisgeving
Dit soort automatisering moet met de nodige zorg worden ingezet.
Zelfs wanneer de gebruiker legitiem toegang heeft tot de gegevens, kan browsergestuurde scraping in strijd zijn met de gebruikersovereenkomst (EULA), de gebruiksvoorwaarden, het beleid voor aanvaardbaar gebruik, contractuele beperkingen of het beveiligingsbeleid van het systeem.
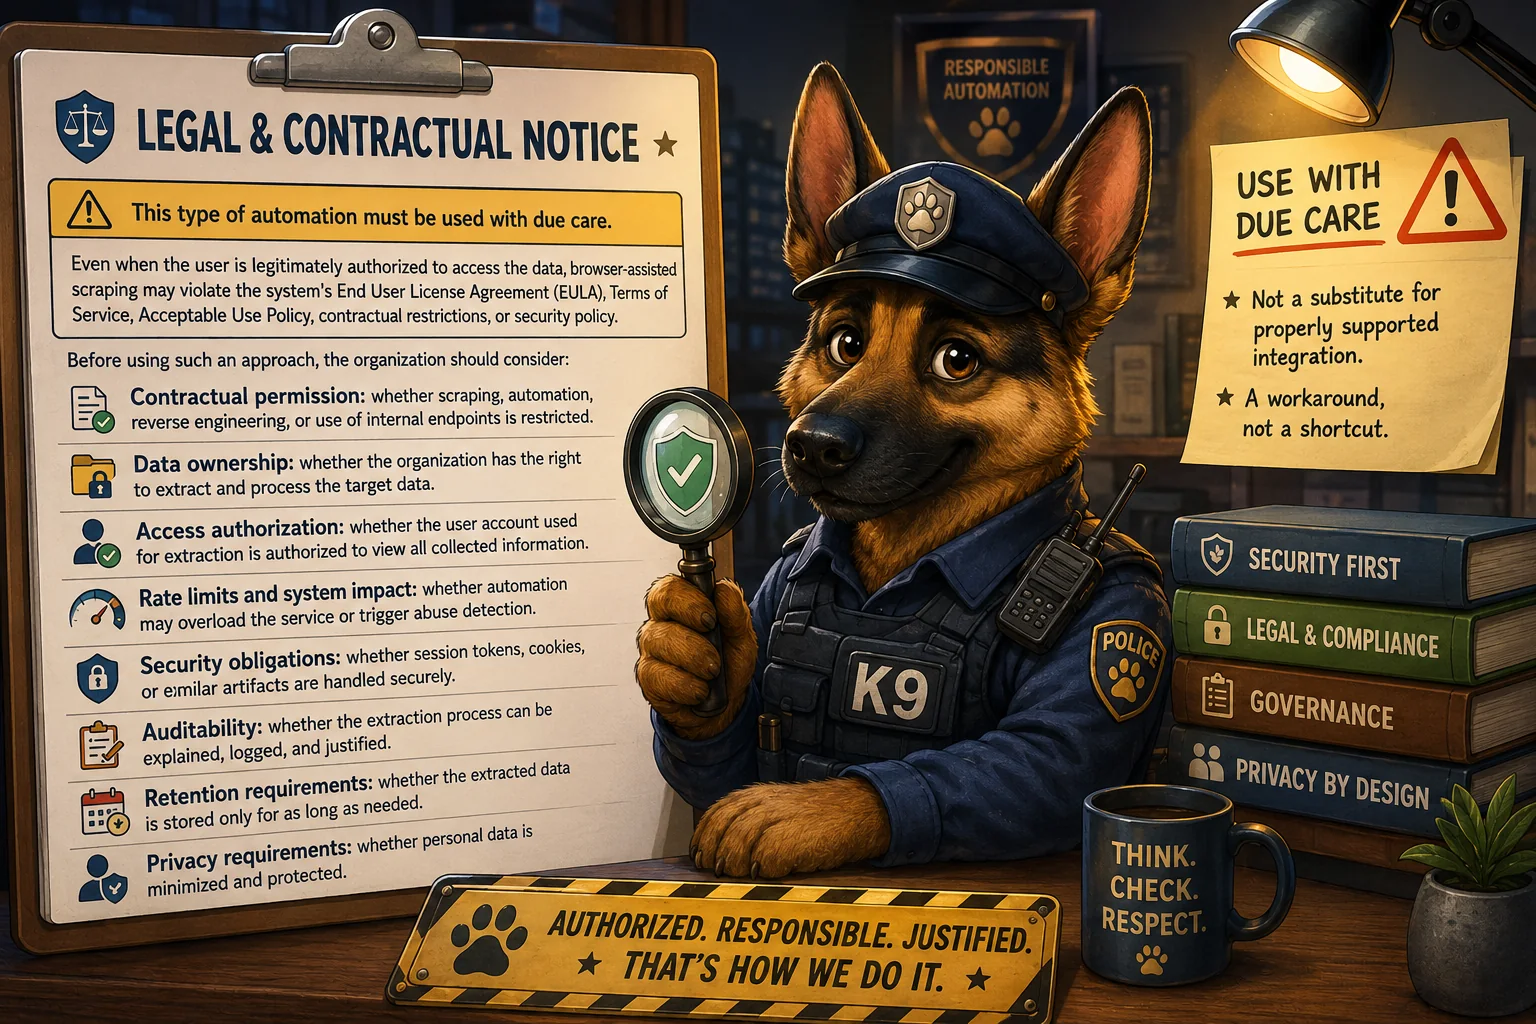
Voordat een dergelijke aanpak wordt gebruikt, moet de organisatie het volgende overwegen:
- Contractuele toestemming: of scraping, automatisering, reverse engineering of het gebruik van interne eindpunten beperkt is.
- Gegevenseigendom: of de organisatie het recht heeft de betrokken gegevens te extraheren en te verwerken.
- Toegangsautorisatie: of het gebruikersaccount dat voor de extractie wordt gebruikt, alle verzamelde informatie mag raadplegen.
- Limieten op aanvragen en impact op het systeem: of de automatisering de dienst kan overbelasten of misbruikdetectie kan activeren.
- Beveiligingsverplichtingen: of sessietokens, cookies of vergelijkbare artefacten veilig worden behandeld.
- Controleerbaarheid: of het extractieproces kan worden uitgelegd, gelogd en verantwoord.
- Bewaringsvereisten: of de geëxtraheerde gegevens enkel zo lang als nodig worden bewaard.
- Privacyvereisten: of persoonsgegevens worden geminimaliseerd en beschermd.
Dit patroon mag niet lichtvaardig worden gebruikt. Het is een noodoplossing, geen vervanging voor een degelijk ondersteunde integratie.
7. Beveiligingsoverwegingen
Sessieartefacten, waaronder cookies en tokens, moeten worden behandeld als gevoelige toegangsgegevens.
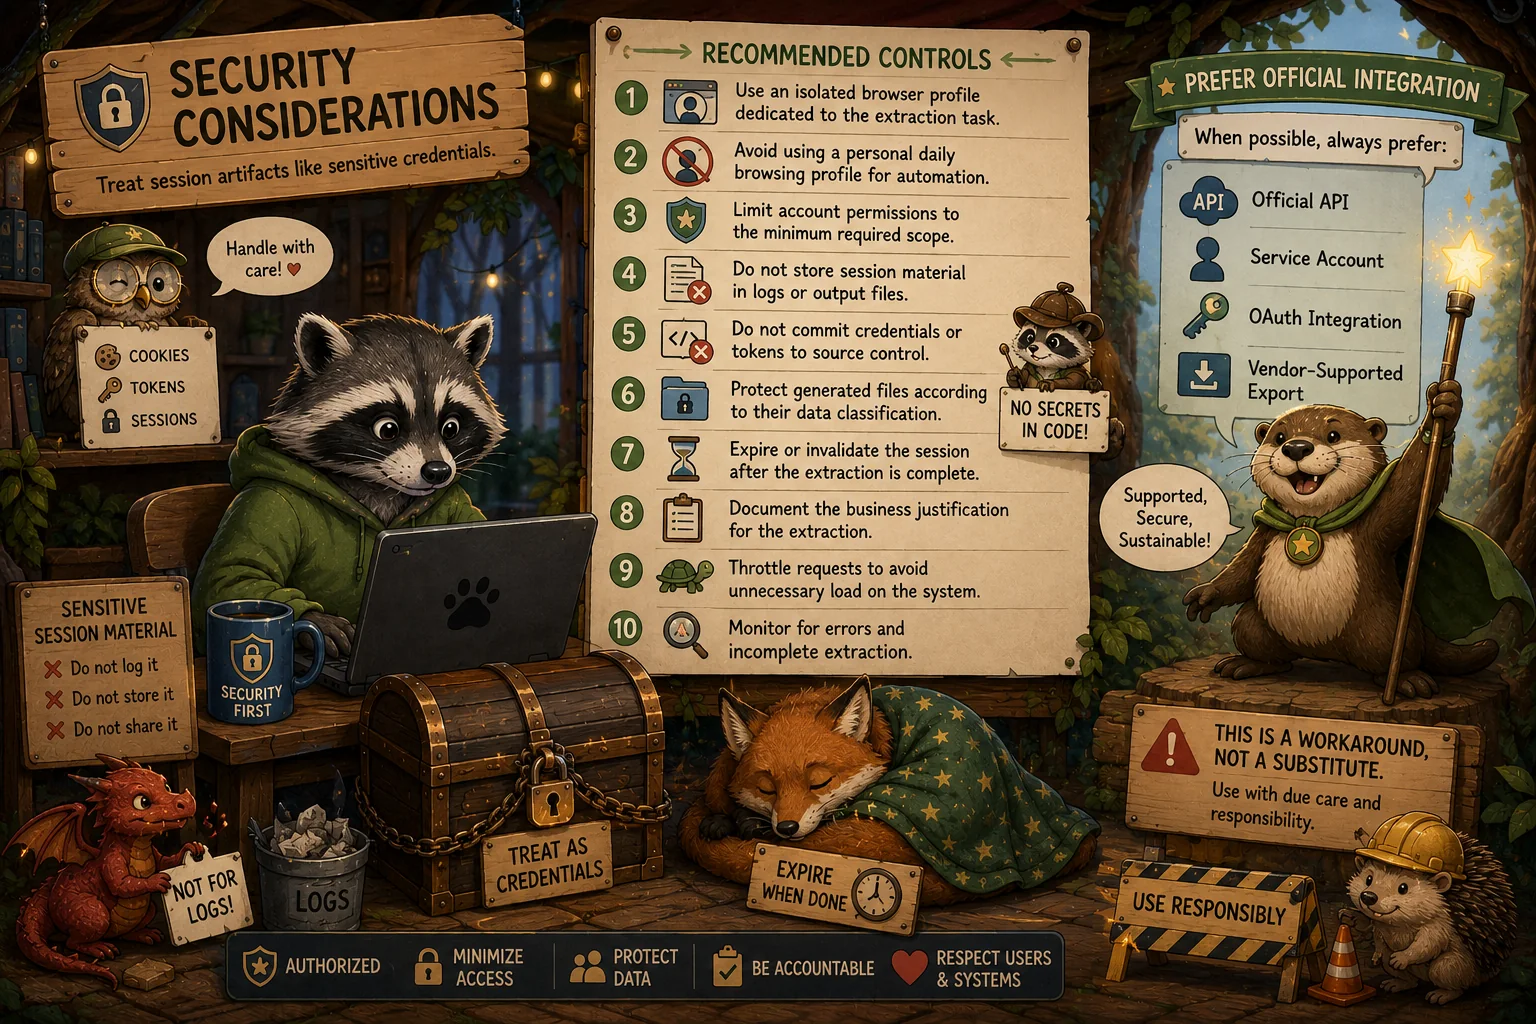
Als de automatisering op een geauthenticeerde sessie steunt, worden de volgende beheersmaatregelen sterk aanbevolen:
- Gebruik een geïsoleerd browserprofiel dat uitsluitend voor de extractietaak bestemd is.
- Vermijd het gebruik van een persoonlijk dagelijks browserprofiel voor automatisering.
- Beperk de accountrechten tot de minimaal vereiste reikwijdte.
- Bewaar geen sessiemateriaal in logs of uitvoerbestanden.
- Commit geen inloggegevens of tokens naar broncodebeheer.
- Bescherm gegenereerde bestanden volgens hun gegevensclassificatie.
- Laat de sessie verlopen of maak ze ongeldig nadat de extractie is voltooid.
- Documenteer de zakelijke rechtvaardiging voor de extractie.
- Beperk het aantal verzoeken per tijdseenheid om onnodige belasting van het systeem te vermijden.
- Bewaak fouten en onvolledige extractie.
Waar mogelijk verdient een officiële API, serviceaccount, OAuth-integratie of door de leverancier ondersteund exportmechanisme altijd de voorkeur.
8. Een theoretisch voorbeeld
Stel dat een bedrijf records uit een interne SaaS-omgeving moet extraheren voor een compliancereview.
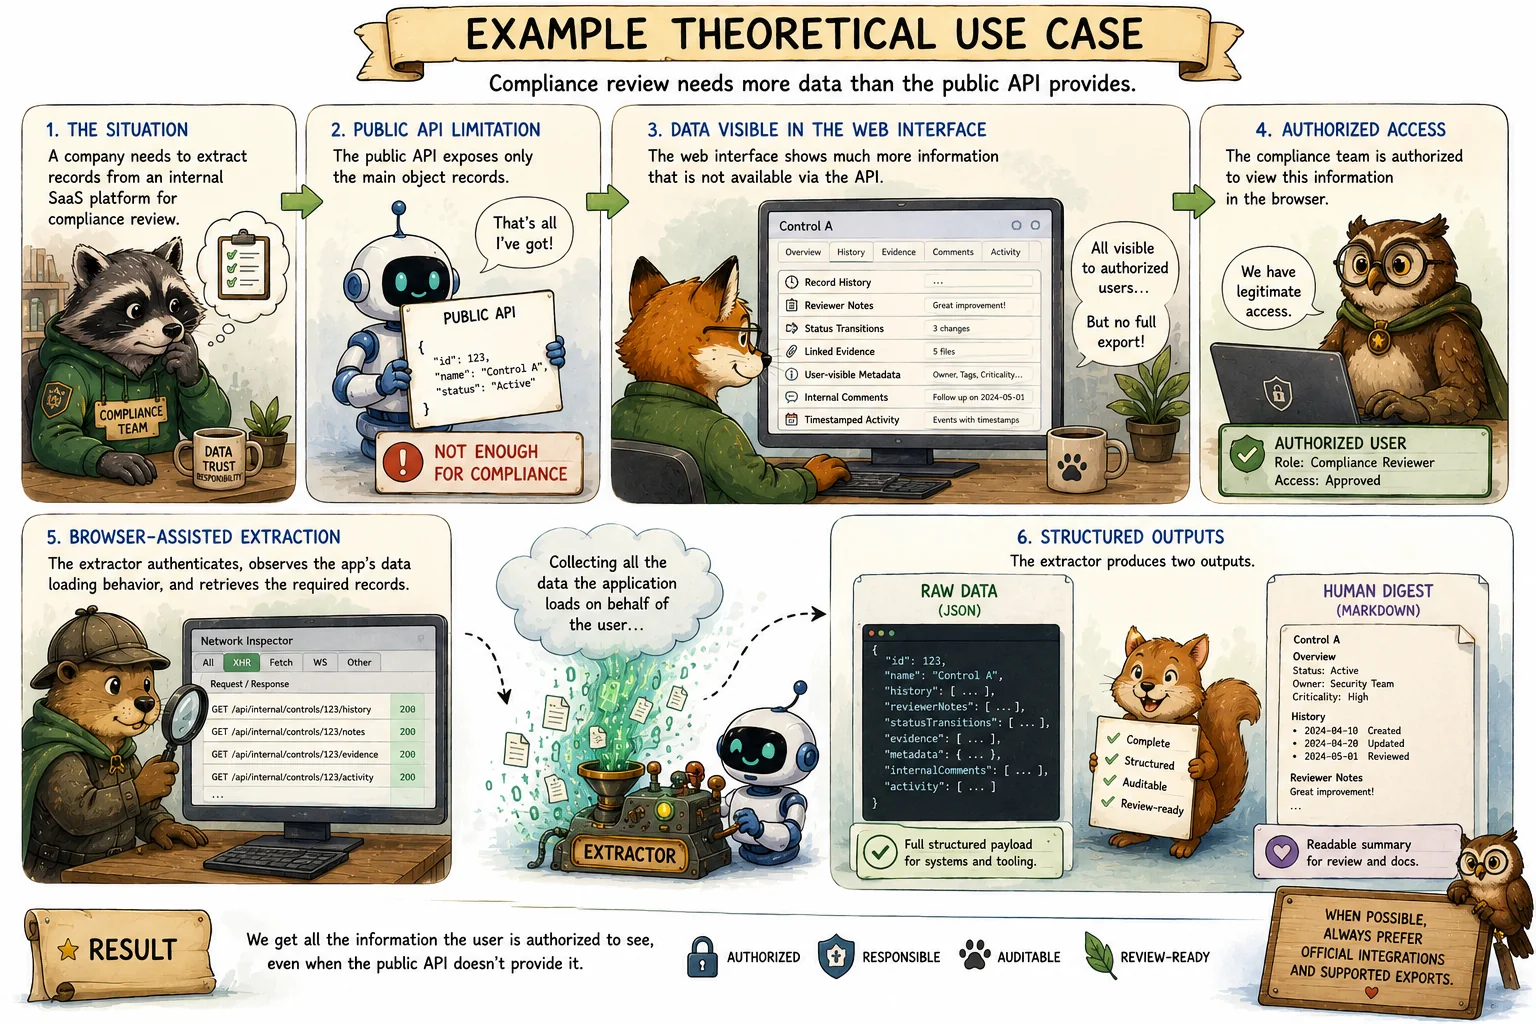
De openbare API geeft alleen de records van het hoofdobject vrij, maar de webinterface toont aanvullende informatie, zoals:
- Historiek van het record
- Opmerkingen van de reviewer
- Statusovergangen
- Gekoppeld bewijs
- Voor de gebruiker zichtbare metadata
- Interne opmerkingen
- Activiteit met tijdstempel
Het compliance-team mag deze informatie in de browser raadplegen, maar er is geen volledige exportfunctie.
Een browsergestuurde extractor kan zich als de bevoegde gebruiker authenticeren, het eigen laadgedrag van de applicatie observeren, de vereiste records ophalen en twee outputs produceren. Het JSON-bestand bewaart de volledige gestructureerde payload. Het Markdown-bestand biedt een leesbare versie die geschikt is voor review en documentatie.
9. Verantwoord gebruik
Browsergestuurde scraping kan legitiem zijn wanneer ze wordt gebruikt om gegevens op te halen waartoe de gebruiker al toegang heeft en wanneer er geen adequaat officieel exportmechanisme bestaat.
Ze moet echter worden behandeld als een technische oplossing bij uitzondering. Vóór gebruik moet ze vanuit juridisch, beveiligings-, privacy- en operationeel oogpunt worden getoetst.
De beste uitkomst blijft een door de leverancier ondersteunde API. Maar wanneer de API ontbreekt of ontoereikend is, kan zorgvuldig beheerste browsergestuurde extractie een praktische brug vormen tussen handwerk en een degelijke integratie.
10. Conclusie
Systemen zonder voldoende API’s zorgen voor wrijving bij compliance, audit, rapportage, migratie en operationele automatisering. In zulke gevallen kan browsergestuurde gegevensextractie een pragmatische noodoplossing zijn.
Het kernprincipe is eenvoudig: automatiseer alleen wat de gebruiker legitiem mag raadplegen, behandel sessiemateriaal als toegangsgegevens, vermijd onnodige gegevensverzameling, respecteer contractuele beperkingen en documenteer de rechtvaardiging.
Verantwoord toegepast kan deze aanpak een anders handmatig en onbetrouwbaar proces omvormen tot een herhaalbare, gestructureerde en controleerbare workflow.
Deze pagina is een volledige kopie van het verhaal zoals het op Medium is verschenen. Lees het op Medium. Illustraties gegenereerd met AI.