
Medium · Automatisering, Webbskrapning · Utkast
När API:et inte räcker: webbläsarstödd datautvinning på användarens uppdrag
Moderna SaaS-plattformar erbjuder ofta publika API:er. I teorin borde det göra integrationer, rapportering, insamling av compliance-bevis, analys och automation enkla.
Först publicerad på Medium den 26 maj 2026. Läs den på Medium. 8 min läsning.
I praktiken räcker det tillgängliga API:et inte alltid till:
- Ibland finns inget publikt API.
- Ibland finns det, men det exponerar bara en begränsad del av datan.
- Ibland syns datan i webbapplikationen men är inte tillgänglig via dokumenterade slutpunkter.
- Och ibland är exportfunktionen begränsad till en CSV-fil som saknar metadata, samband, kommentarer, historik eller revisionsspår som behövs för ett legitimt affärsändamål.
Det skapar ett praktiskt problem: användaren har rätt att komma åt informationen, informationen syns i applikationen, men det finns ingen tillräcklig officiell mekanism för att hämta den på ett strukturerat och upprepbart sätt.
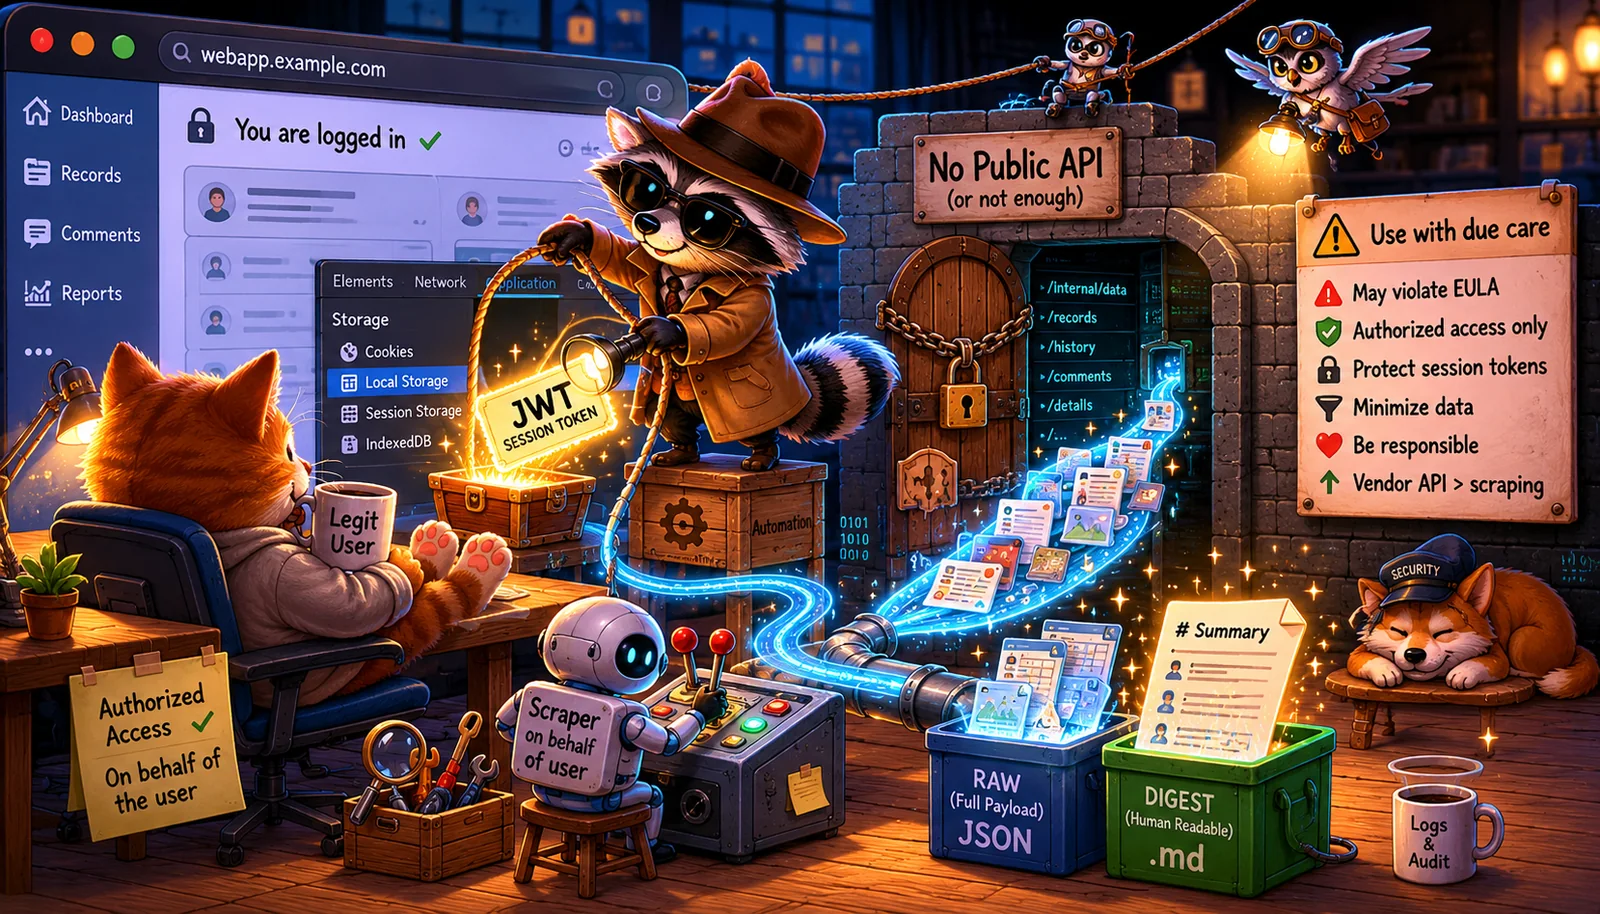
I sådana fall kan webbläsarassisterad datautvinning bli en praktisk lösning.
1. Inte Robotic Process Automation (RPA)
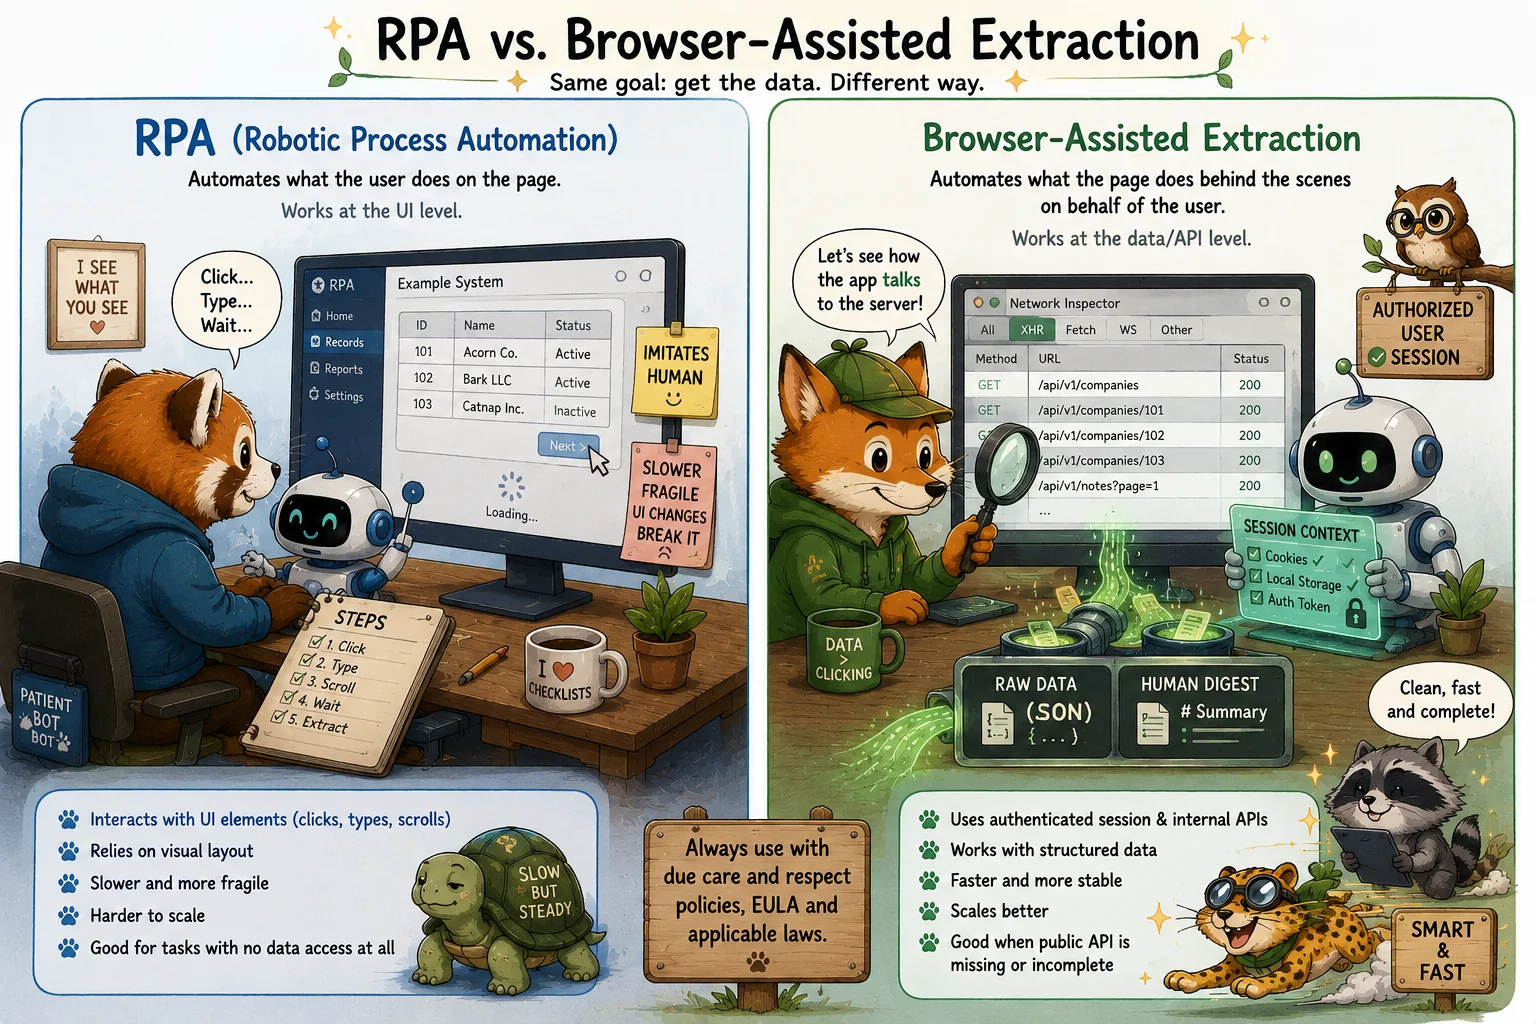
Det här tillvägagångssättet kan likna Robotic Process Automation (RPA), men det är inte riktigt samma sak.
Traditionell RPA härmar oftast användargränssnittet: den klickar på knappar, fyller i formulär, scrollar sidor, väntar på att skärmar ska laddas och läser synliga element. Den behandlar webbapplikationen som en visuell arbetsyta och automatiserar samma steg som en människa skulle utföra manuellt.
Webbläsarassisterad utvinning arbetar på ett annat lager. Webbläsaren används fortfarande för legitim användarautentisering och åtkomstkontroll, men själva datainsamlingen sker genom att observera och återanvända applikationens egen kommunikation med sin backend. I stället för att kopiera värden från skärmen hämtar automationen strukturerad data som applikationen redan tar emot för att kunna rendera skärmen.
Enkelt uttryckt:
- RPA automatiserar det användaren gör på sidan.
- Webbläsarassisterad utvinning automatiserar det sidan gör bakom kulisserna på användarens vägnar.
Skillnaden spelar roll. Webbläsarassisterad utvinning är oftast stabilare, snabbare och mer fullständig än visuell automation av gränssnittet, eftersom den kan arbeta med strukturerade nyttolaster i stället för renderade gränssnittselement. Samtidigt kräver den större försiktighet, eftersom den kan bygga på internt applikationsbeteende, odokumenterade slutpunkter, cookies, sessionslagring, lokal lagring eller andra sessionsrelaterade artefakter.
Därför bör det här mönstret behandlas som en kontrollerad lösning. Det är inte en ersättning för ett officiellt API, en stödd integration eller en ordentligt dokumenterad exportfunktion. Det ligger närmare ”API-upptäckt via den autentiserade webbläsarsessionen” än klassisk RPA.
Principen är densamma: automationen får bara agera på uppdrag av en behörig användare, bara samla in data som användaren har rätt att komma åt och bara användas med hänsyn till rättsliga, avtalsmässiga, integritets- och säkerhetsaspekter.
2. Scenariot
Anta att det finns ett system som ett företag använder för styrning, compliance, drift eller intern administration.
Systemet har ett webbgränssnitt. Behöriga användare kan logga in, navigera bland poster, se detaljer och manuellt exportera eller kopiera information. Men systemet har någon av följande begränsningar:
- Inget publikt API finns.
- Det publika API:et är ofullständigt och exponerar inte all nödvändig data.
- Exportfunktionen räcker inte för behov inom verksamhet, revision, migrering eller rapportering.
- Viktig metadata syns i webbläsaren men är inte tillgänglig via dokumenterade integrationsmetoder.
- Manuell utvinning skulle vara långsam, felbenägen och svår att upprepa.
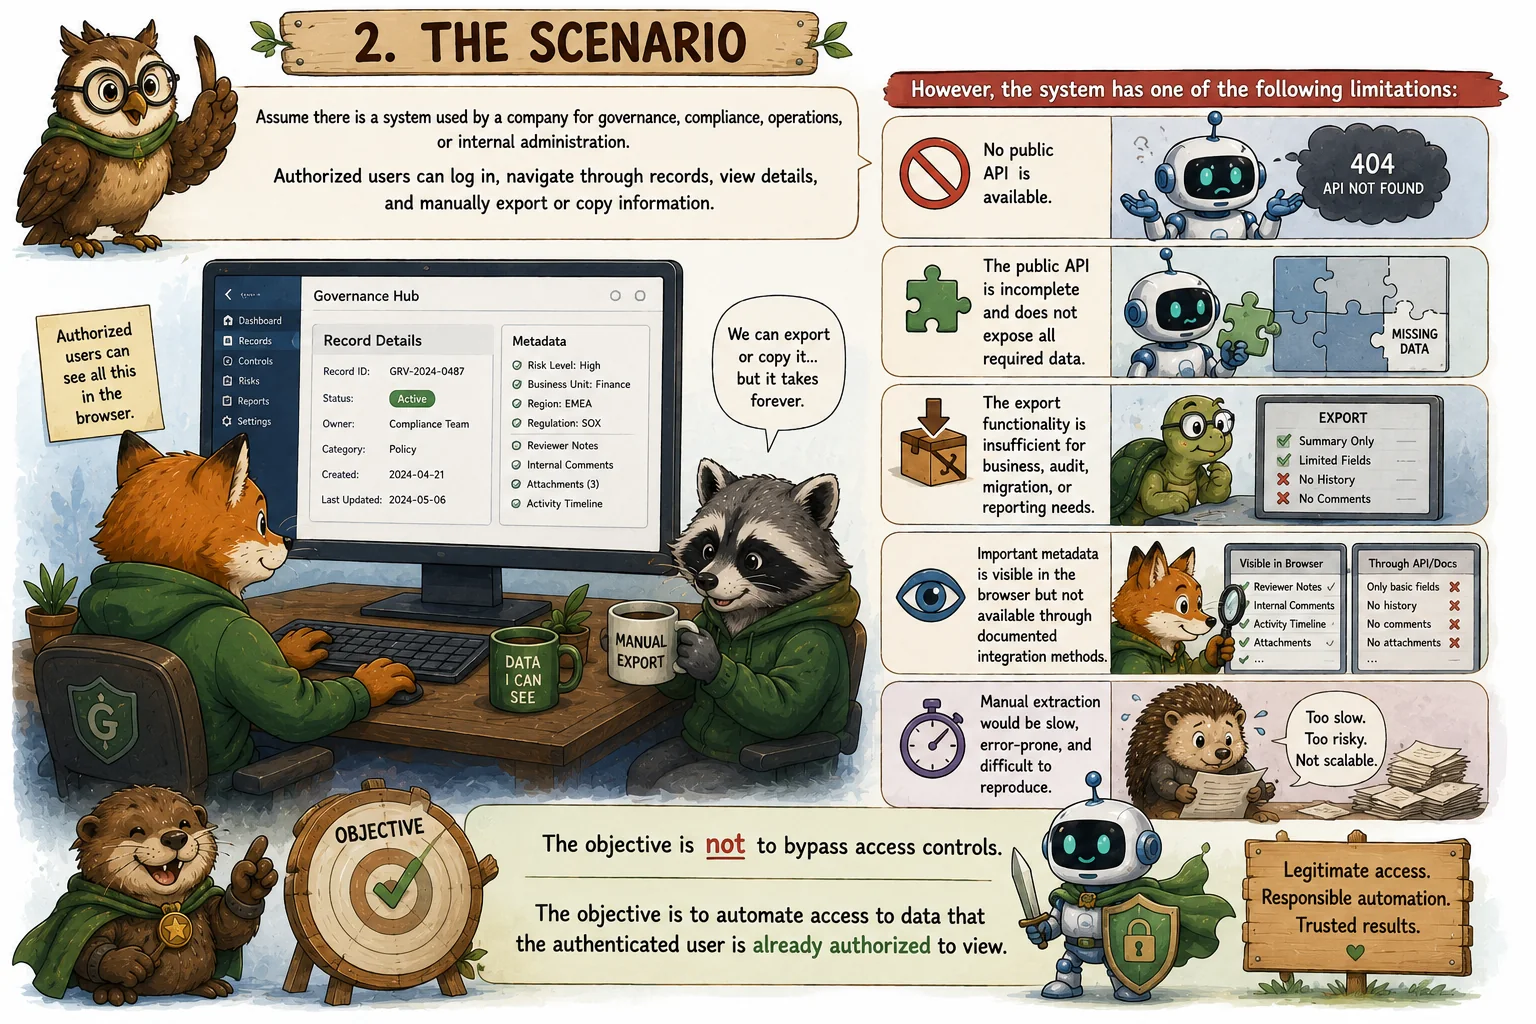
Målet är inte att kringgå åtkomstkontroller. Målet är att automatisera åtkomsten till data som den autentiserade användaren redan har rätt att se.
3. Det allmänna tillvägagångssättet
Det allmänna mönstret är webbläsarassisterad skrapning på användarens vägnar.
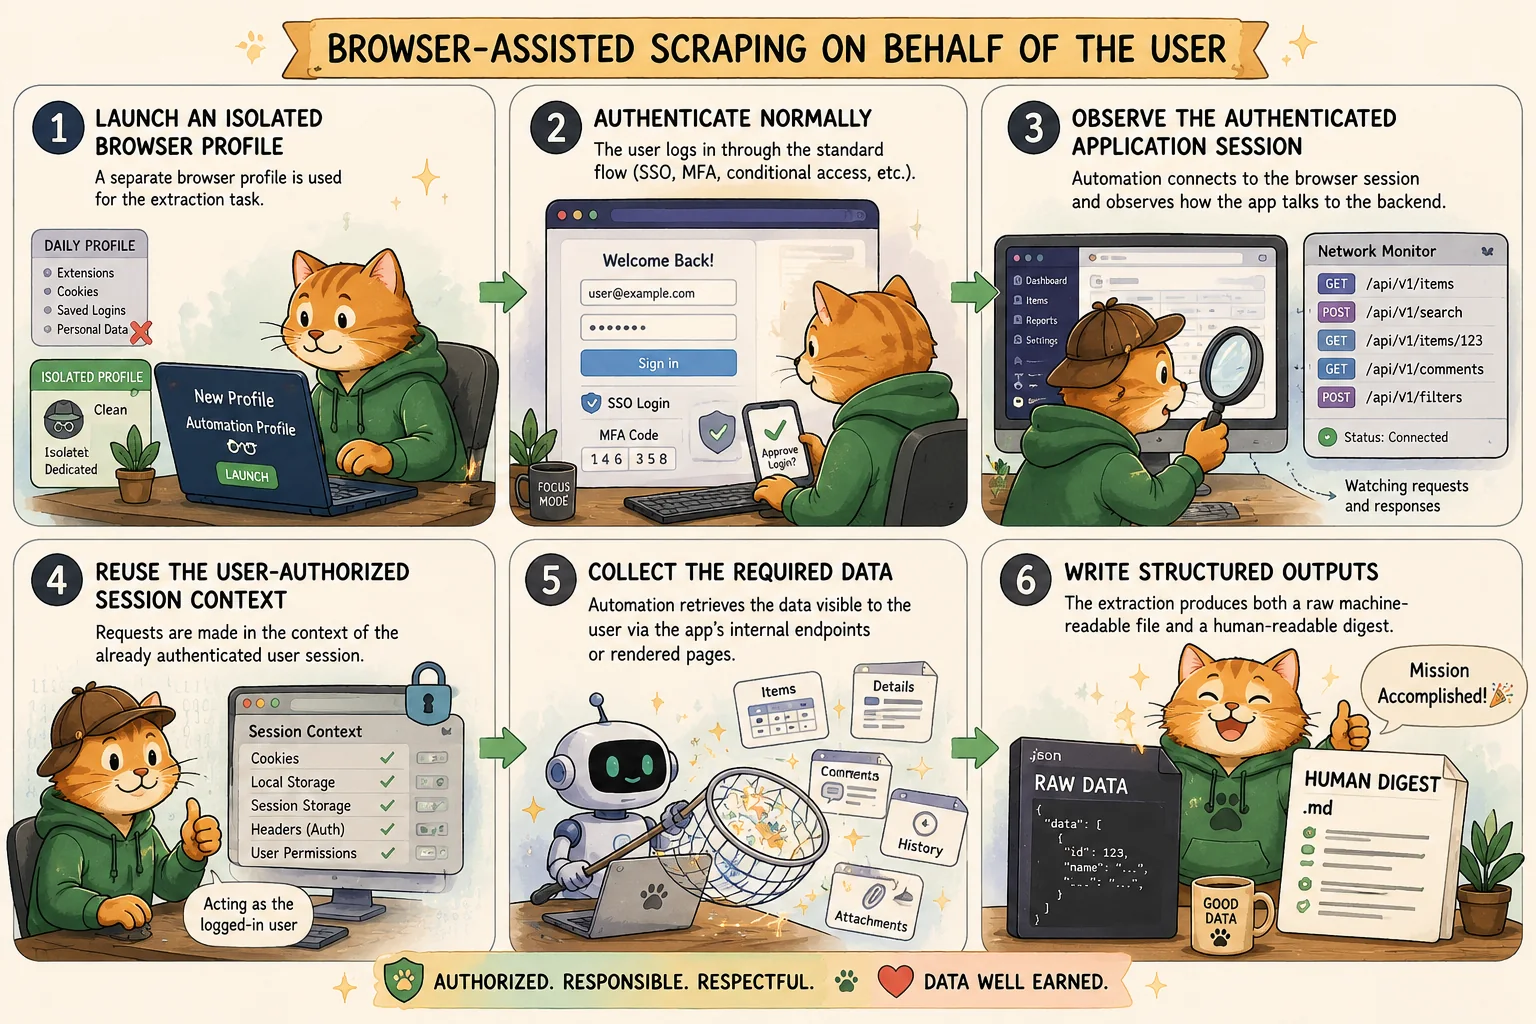
Ett typiskt arbetsflöde kan se ut så här:
- Starta en isolerad webbläsarprofil. En separat webbläsarprofil används för utvinningsuppgiften. Det undviker att blanda automationssessionen med användarens vardagliga webbläsarprofil, tillägg, sparade inloggningsuppgifter, orelaterade cookies och privata sessioner.
- Autentisera som vanligt. Användaren loggar in via det vanliga webbgränssnittet, med det normala autentiseringsflödet, inklusive SSO, MFA, villkorad åtkomst eller andra kontroller som systemet kräver.
- Observera den autentiserade applikationssessionen. Efter autentiseringen ansluter automationen till webbläsarsessionen och observerar hur webbapplikationen kommunicerar med sin backend.
- Återanvänd den användarauktoriserade sessionens sammanhang. Automationen gör anrop i samband med den redan autentiserade användarsessionen. I vissa system kan relevant sessionsmaterial finnas i lagringsmekanismer som webbläsaren kommer åt, till exempel cookies, sessionslagring eller lokal lagring.
- Samla in den data som behövs. Automationen hämtar den data som användaren kan se, via applikationens interna slutpunkter eller renderade sidor.
- Skriv strukturerade utdata. Utvinningen ger både en rå maskinläsbar fil och en läsbar sammanfattning för människor (rekommenderas).
4. Varför det fungerar
Många webbapplikationer är byggda som webbläsarbaserade klienter som kommunicerar med backend-tjänster. Även när det inte finns något publikt API använder webbläsaren ofta interna API:er för att ladda den data som visas i gränssnittet.
Det betyder att det enklaste sättet att förstå hur man hämtar all relevant information ur ett system ibland är att undersöka hur systemet självt hämtar informationen åt webbläsaren.
Det är den obekväma praktiska verkligheten.
Ur teknisk synvinkel vet webbapplikationen redan var datan finns, vilka slutpunkter som används, vilka parametrar som krävs och hur poster pagineras eller filtreras. Webbläsarassisterad utvinning automatiserar helt enkelt det användaren annars kunde göra manuellt, så länge det sker inom användarens legitima åtkomsträttigheter.
5. ”Hacket” som egentligen inte är ett hack
Det finns ett vanligt skämt bland ingenjörer och de som arbetar med automation av compliance:
Det enklaste sättet att få ut all information ur ett system är att ”hacka” det.
I det här sammanhanget ska ”hacka” inte betyda obehörig åtkomst, exploatering, behörighetseskalering eller kringgående av säkerhetskontroller. Det betyder att förstå hur webbapplikationen fungerar internt och använda den kunskapen för att automatisera en annars manuell process.
Till exempel lagrar vissa webbapplikationer tillfälliga sessionsartefakter i webbläsaren så att frontenden kan kommunicera med backend-tjänster. I vissa fall kan automation återanvända den autentiserade webbläsarsessionen för att utvinna data på användarens vägnar.
Det kan vara en kraftfull teknik när ett officiellt API saknas eller är ofullständigt. Det är också en teknik som måste hanteras varsamt, eftersom sessionsmaterial är känsligt och kan ge åtkomst likvärdig med den inloggade användarens.
6. Rättsligt och avtalsmässigt meddelande
Den här typen av automation måste användas med vederbörlig omsorg.
Även när användaren legitimt har rätt att komma åt datan kan webbläsarassisterad skrapning strida mot systemets licensavtal för slutanvändare (EULA), användarvillkor, policy för godtagbar användning, avtalsmässiga begränsningar eller säkerhetspolicy.
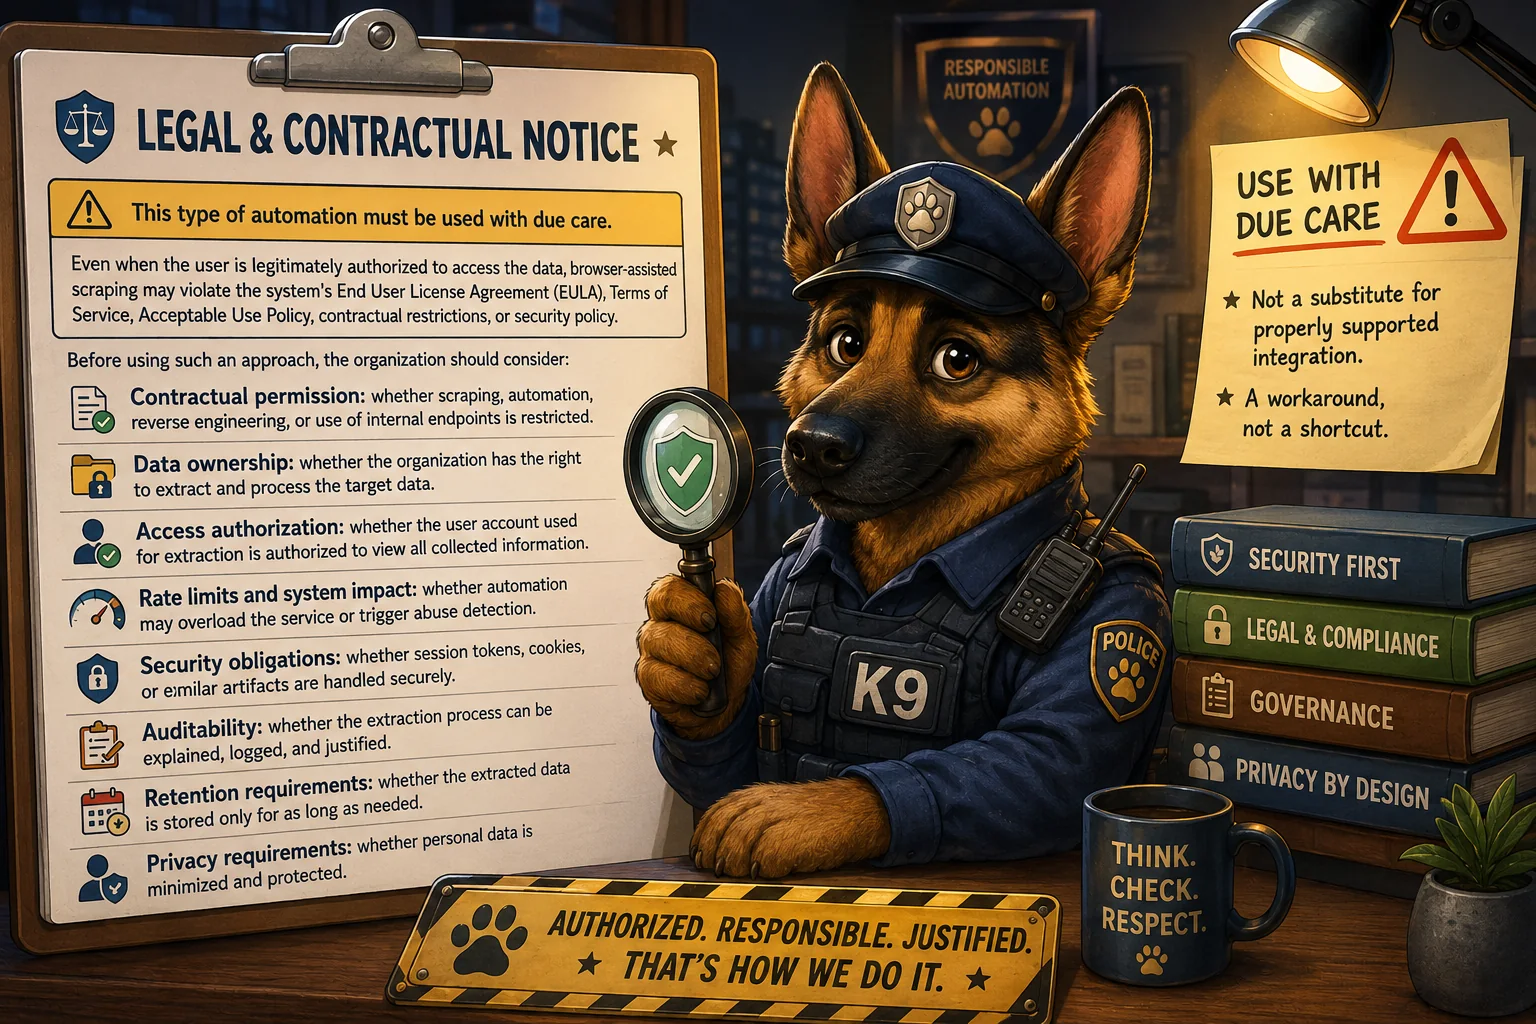
Innan ett sådant tillvägagångssätt används bör organisationen överväga:
- Avtalsmässigt tillstånd: om skrapning, automation, reverse engineering eller användning av interna slutpunkter är begränsad.
- Dataägande: om organisationen har rätt att utvinna och behandla måldatan.
- Åtkomstbehörighet: om användarkontot som används för utvinningen har rätt att se all insamlad information.
- Hastighetsgränser och påverkan på systemet: om automationen kan överbelasta tjänsten eller utlösa upptäckt av missbruk.
- Säkerhetsskyldigheter: om sessionstokens, cookies eller liknande artefakter hanteras säkert.
- Spårbarhet: om utvinningsprocessen kan förklaras, loggas och motiveras.
- Krav på lagring: om den utvunna datan bara lagras så länge den behövs.
- Krav på integritet: om personuppgifter minimeras och skyddas.
Det här mönstret bör inte användas lättvindigt. Det är en genväg, inte en ersättning för en ordentligt stödd integration.
7. Säkerhetsaspekter
Sessionsartefakter, inklusive cookies och tokens, måste behandlas som känsliga inloggningsuppgifter.
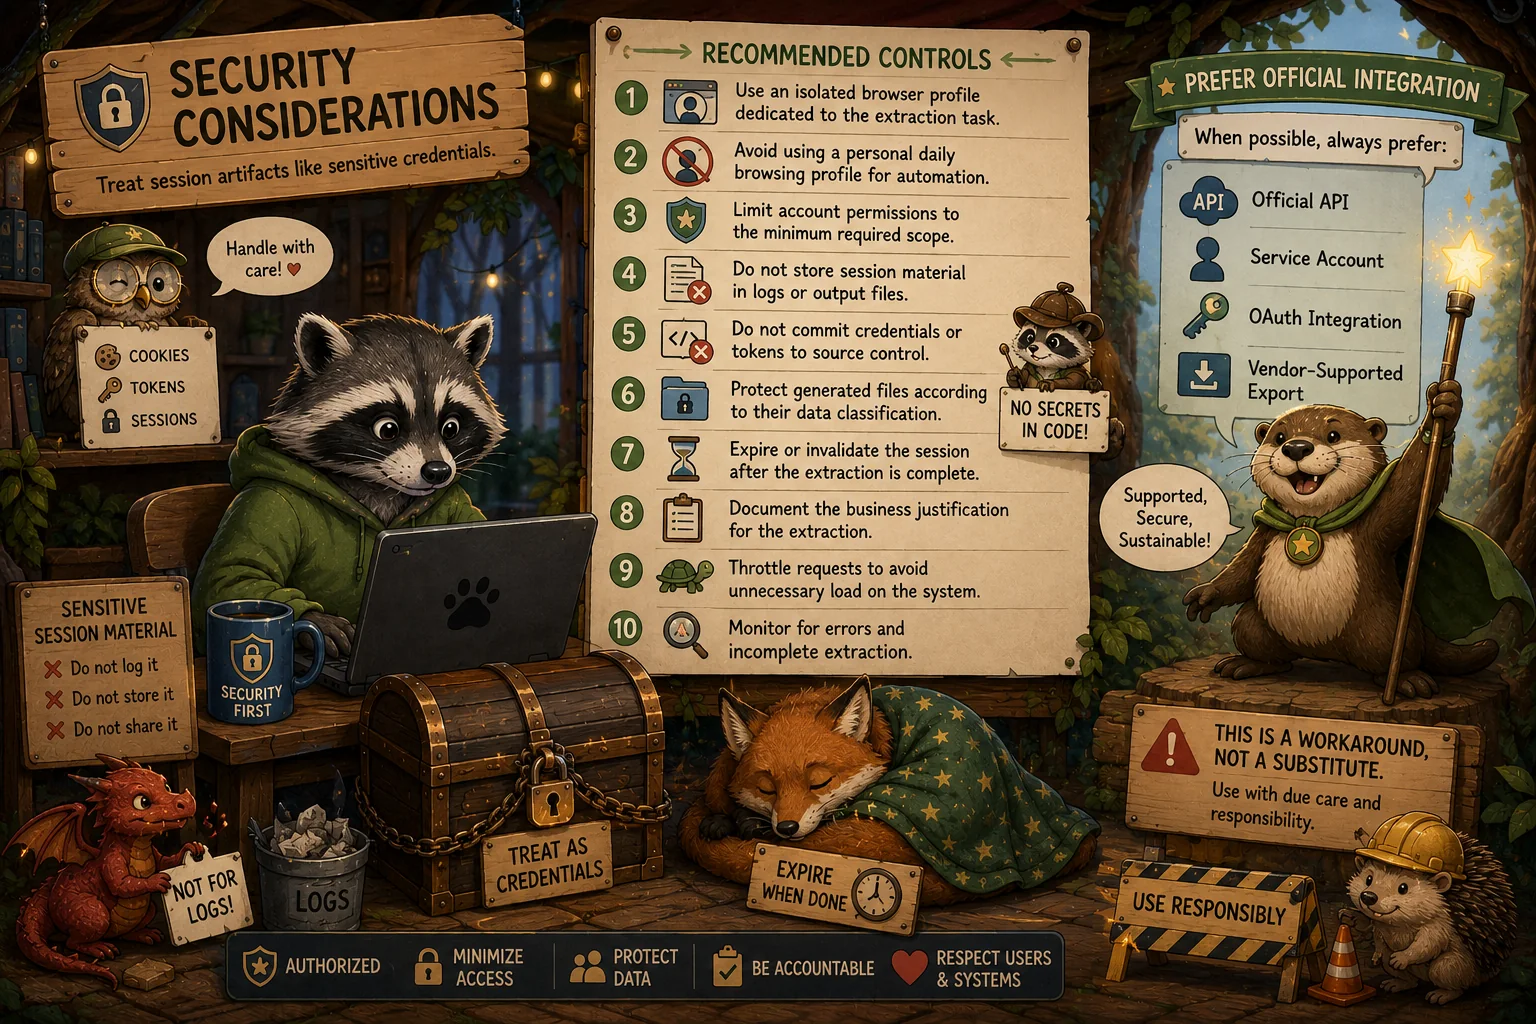
Om automationen bygger på en autentiserad session rekommenderas följande kontroller starkt:
- Använd en isolerad webbläsarprofil som är dedikerad till utvinningsuppgiften.
- Undvik att använda en personlig vardagsprofil för automation.
- Begränsa kontots behörigheter till den minsta nödvändiga omfattningen.
- Lagra inte sessionsmaterial i loggar eller utdatafiler.
- Checka inte in inloggningsuppgifter eller tokens i källkodshanteringen.
- Skydda genererade filer i enlighet med deras dataklassificering.
- Låt sessionen gå ut eller ogiltigförklara den när utvinningen är klar.
- Dokumentera affärsmotiveringen för utvinningen.
- Strypa anropstakten för att undvika onödig belastning på systemet.
- Övervaka fel och ofullständig utvinning.
Där det är möjligt bör ett officiellt API, ett tjänstekonto, en OAuth-integration eller en leverantörsstödd exportmekanism alltid föredras.
8. Teoretiskt användningsfall
Anta att ett företag behöver utvinna poster ur en intern SaaS-plattform för en compliance-granskning.
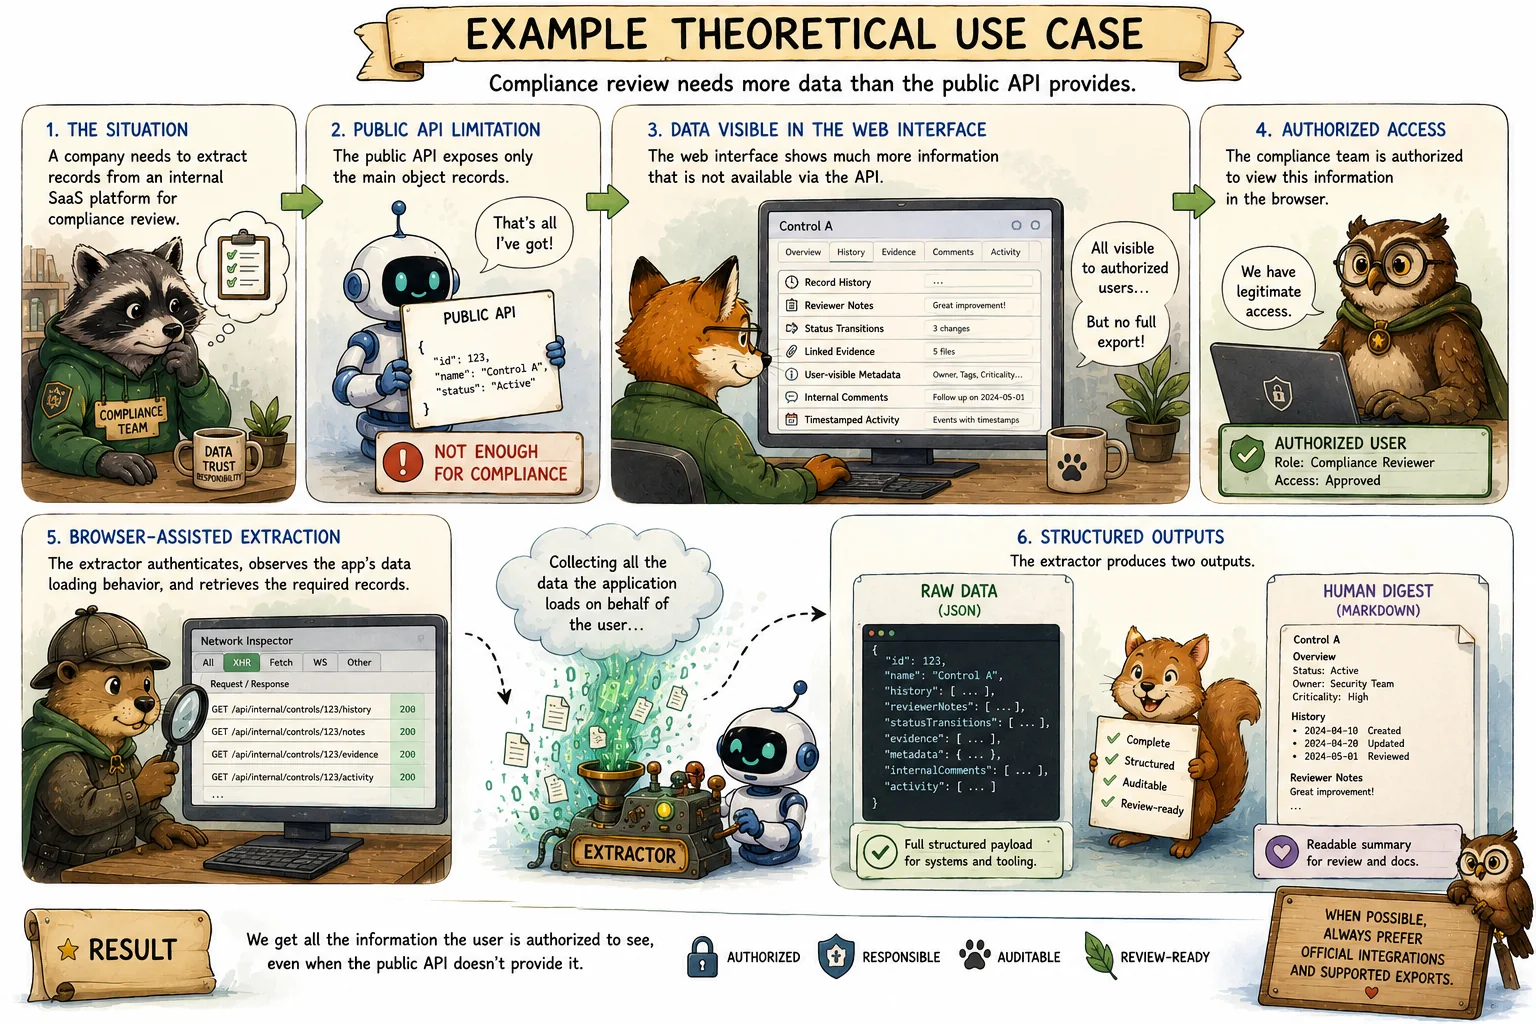
Det publika API:et exponerar bara huvudobjektens poster, men webbgränssnittet visar ytterligare information, till exempel:
- Posthistorik
- Granskaranteckningar
- Statusövergångar
- Länkade bevis
- Metadata som är synlig för användaren
- Interna kommentarer
- Tidsstämplad aktivitet
Compliance-teamet har rätt att se den här informationen i webbläsaren, men det finns ingen fullständig exportfunktion.
En webbläsarassisterad utvinnare kan autentisera sig som den behöriga användaren, observera applikationens eget sätt att ladda data, hämta de poster som behövs och ge två utdata. JSON-filen bevarar hela den strukturerade nyttolasten. Markdown-filen ger en läsbar version som lämpar sig för granskning och dokumentation.
9. Ansvarsfull användning
Webbläsarassisterad skrapning kan vara legitim när den används för att hämta data som användaren redan har rätt att komma åt och när det inte finns någon tillräcklig officiell exportmekanism.
Den bör dock behandlas som en ingenjörslösning för undantagsfall. Den bör granskas ur rättsliga, säkerhetsmässiga, integritetsmässiga och operativa perspektiv innan den används.
Det bästa utfallet är fortfarande ett API som stöds av leverantören. Men när API:et saknas eller inte räcker kan noggrant kontrollerad webbläsarassisterad utvinning utgöra en praktisk brygga mellan manuellt arbete och en ordentlig integration.
10. Slutsats
System utan tillräckliga API:er skapar friktion för compliance, revision, rapportering, migrering och operativ automation. I sådana fall kan webbläsarassisterad datautvinning vara en pragmatisk lösning.
Huvudprincipen är enkel: automatisera bara det användaren legitimt har rätt att komma åt, skydda sessionsmaterial som inloggningsuppgifter, undvik onödig datainsamling, respektera avtalsmässiga begränsningar och dokumentera motiveringen.
Används den ansvarsfullt kan den här metoden göra en annars manuell och opålitlig process till ett upprepbart, strukturerat och spårbart arbetsflöde.
Den här sidan är en fullständig kopia av berättelsen så som den publicerades på Medium. Läs den på Medium. Illustrationer genererade med AI.